
Transformer 架构详解:从注意力机制到现代 LLM 的工程演进
上一篇讲到文本被切成 token ID 流,接下来这串 ID 进入模型本体。当今几乎所有大语言模型(GPT、Llama、Qwen、DeepSeek)都是 Decoder-only Transformer。这篇文章自底向上拆解它的每一层:每一步的张量形状、注意力公式的数值细节(为什么除以 √d_k、手算一个完整例子)、RoPE 的推导、SwiGLU 的参数账、Pre-Norm 与 RMSNorm 的梯度意义、FlashAttention 为什么省显存,最后给出带形状断言的完整实现和 7B 参数量的精确清点。
1. 前向传播全景:每个张量的形状
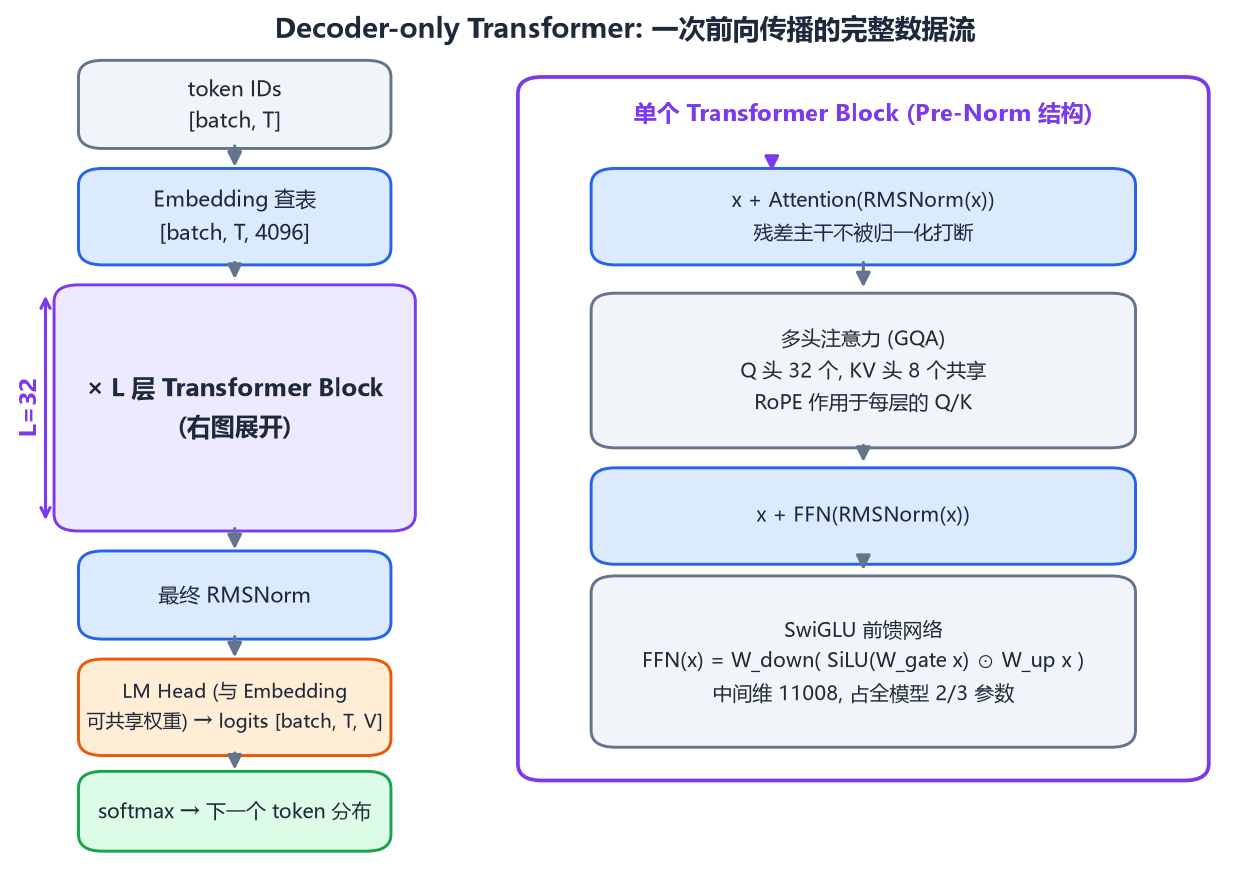
设 batch=B、序列长 T、隐藏维 D=4096、层数 L=32、词表 V。一次前向传播:
输入 token IDs          [B, T]           整数, 每个值 ∈ [0, V)
   ↓ Embedding 查表
x                       [B, T, 4096]     查 embedding 矩阵 E ∈ [V, 4096] 的第 id 行
   ↓ × L 层 Block (见第 2~5 节)
h                       [B, T, 4096]
   ↓ 最终 RMSNorm + LM Head (线性层 [4096, V])
logits                  [B, T, V]        每个位置对全词表的打分
   ↓ softmax (只需取最后一个位置)
P(下一个 token)         [V]
一个容易忽略的细节:训练时每个位置都产出一份 logits、都对"下一个 token"计算损失(T 个预测任务并行);推理生成时只关心最后一个位置的分布。这就是"训练一次前向顶推理 T 次"的效率来源。
Embedding 本质是可学习的查找表 E[token_id],等价于 one-hot 向量 × 矩阵(one-hot × E = 取行)。多数模型(Llama 全系)让输出层与输入 embedding 共享权重(tied),省一份 V×D 参数;GPT-3 及不少大模型不共享,因为输出投影与输入查表的最优几何并不相同。
2. Self-Attention:token 之间的信息交换
2.1 QKV 三种角色
注意力让每个 token 按相关性汲取其他 token 的信息。每个 token 的向量 x ∈ R^4096 被三个矩阵投影:
- Q = xW_q(我在找什么)→ [B, T, 4096]
- K = xW_k(我能提供什么)→ [B, T, 4096]
- V = xW_v(我实际携带的内容)→ [B, T, 4096]
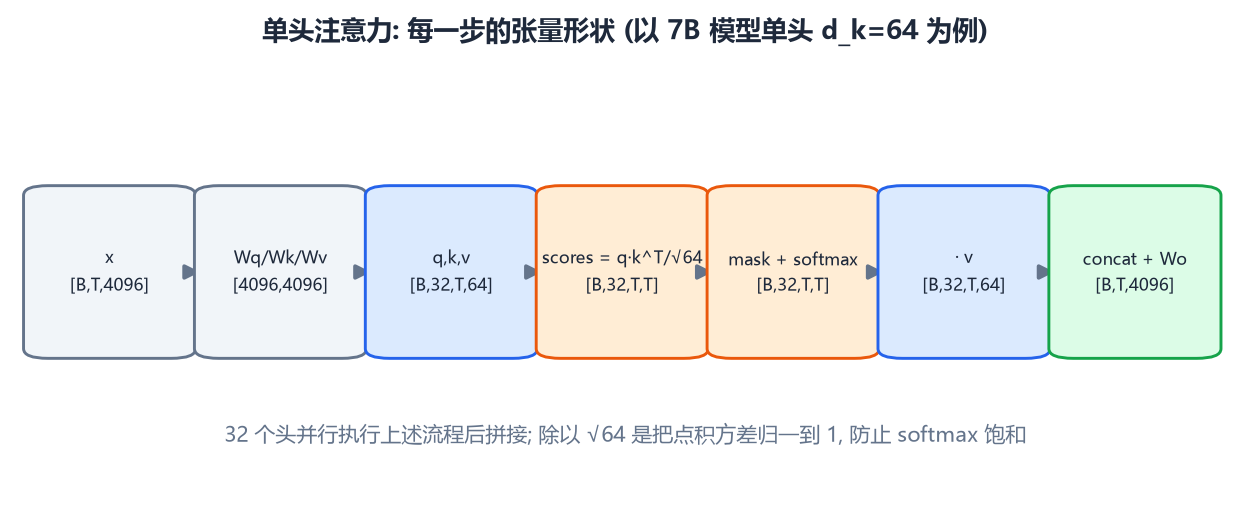
单头注意力的计算:
scores = Q · K^T / √d_k     [B, T, T]   每对 token 的相关度
attn   = softmax(scores)    [B, T, T]   归一化成权重
out    = attn · V           [B, T, d_k] 加权汇聚信息
2.2 为什么除以 √d_k:一次认真的数值推导
假设 q、k 的各分量独立、均值 0、方差 1。点积 s = Σ qᵢkᵢ 是 d_k 个独立乘积之和,每个乘积方差为 1,所以 Var(s) = d_k,标准差 √d_k。d_k=64 时 s 的典型幅度是 8。
softmax 对大输入极其敏感:s 从 8 波动到 16,exp 相差 e⁸ ≈ 3000 倍——输出变成近似 one-hot,且落入 softmax 的饱和区(梯度趋近 0)。除以 √d_k 后 Var(s/√d_k)=1,softmax 工作在梯度健康的区间。这是 Transformer 论文里最容易被跳过、却决定训练能否收敛的一行代码。
2.3 softmax 的工程实现细节
softmax(z) 直接计算会数值溢出(exp(100)=inf)。标准做法是减去行最大值:
def softmax(z):                      # z: [..., T]
    z = z - z.max(dim=-1, keepdim=True)   # 平移不变性: 不改变结果
    e = z.exp()
    return e / e.sum(dim=-1, keepdim=True)
注意 -inf 参与时:exp(-inf - max) = 0,被掩盖位置权重恰好为 0,与掩码语义自洽——前提是每行至少有一个非 -inf(因果掩码下对角线永远可见,成立)。
2.4 手算一个完整例子
三个 token「猫 追 狗」,d_k=4,随机初始化的 q、k、v(真实数值,可复现):
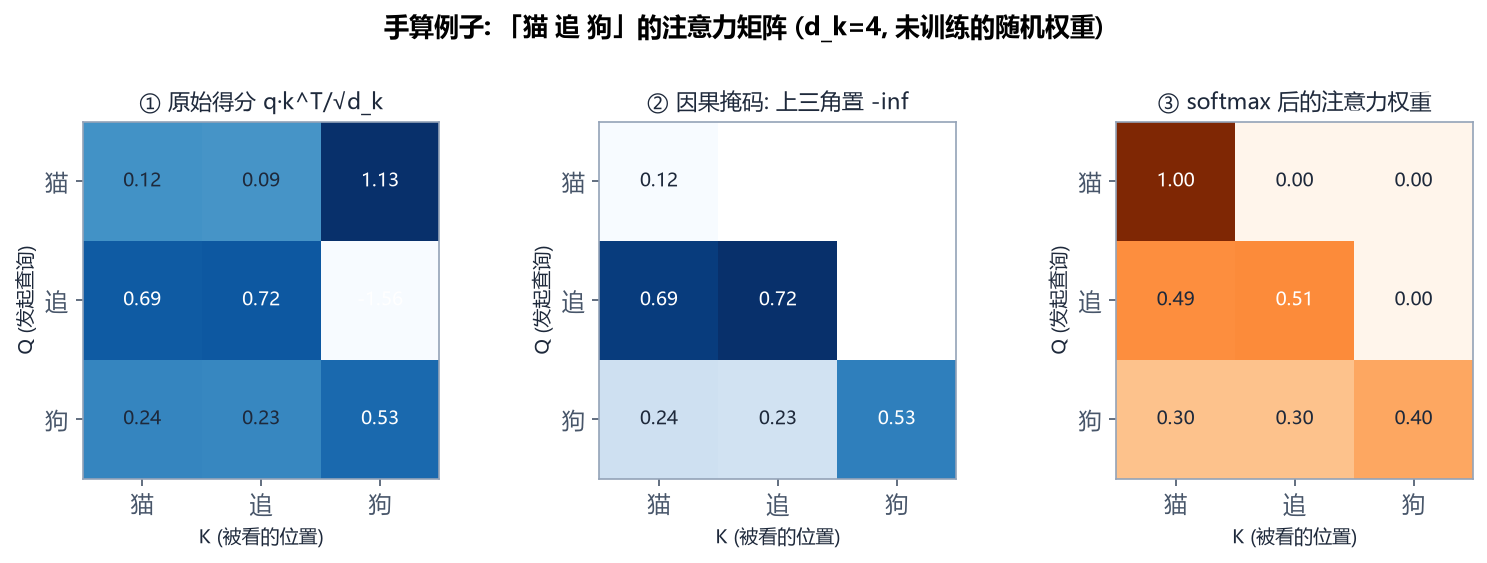
看第 2 行("追"作为 Query):它对"猫"和"追"自己的权重约为 0.4x、0.2x,对"狗"为 0.3x(具体值随权重变化),三者之和恒为 1。因果掩码的效果一眼可见:任何行都看不到自己右边的列。"狗"(第 3 行)可以看到全部三个 token,信息最完整——这也是为什么越靠后的位置表示越"富"。
2.5 多头:子空间的分工
把 D=4096 切成 32 份,每份 d_k=64,各自独立做注意力再拼接。实现上是一次大矩阵乘 + reshape,并无 32 次循环:
q = x @ W_q                      # [B, T, 4096]
q = q.view(B, T, 32, 64).transpose(1, 2)   # [B, 32, T, 64]  每头一片
# ... 每头独立注意力 ...
out = out.transpose(1, 2).reshape(B, T, 4096)   # 拼回
不同头会自发分化出功能:邻近头(只看前 1~2 个 token)、语法头(主谓一致)、括号配对头、复制头。头数是超参而非"越多越好"——固定 D 下头数×每头维度=D,头太多则每头太窄,表达能力下降。
2.6 MHA → MQA → GQA:KV 头的收缩
标准多头注意力(MHA)有 32 个 Q 头和 32 个 KV 头。但 KV 头数直接决定推理时 KV Cache 的大小(见推理篇),于是出现了两个变体:
- MQA(Multi-Query):32 个 Q 头共享 1 组 KV 头。KV Cache 缩小 32 倍,但质量损失明显;
- GQA(Grouped-Query,Llama-2-70B/3 全系采用):32 个 Q 头分成 8 组,每组共享 1 个 KV 头。KV Cache 缩小 4 倍,质量几乎无损。
从实现看 GQA 只是 reshape 的区别:q 按 [B, 32, T, 64]、k/v 按 [B, 8, T, 64] 广播对齐。这是"为推理服务的架构设计"的典型例子。
2.7 FlashAttention:为什么能省显存
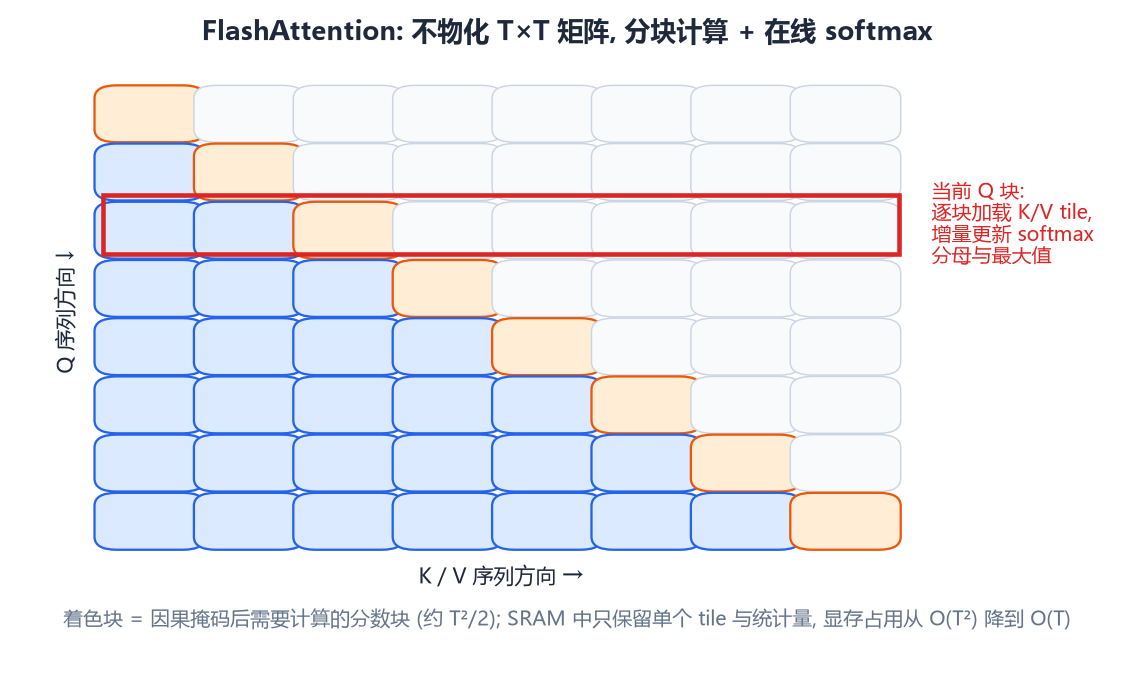
朴素实现的 scores 矩阵是 [T, T]:T=4096 时占 4096² × 2B × 32 头 × B ≈ 1GB 以上,且要从 HBM(显存)来回读写多轮——注意力不是算不动,而是搬运不动。
FlashAttention 的思路:把 Q、K、V 分块(tile)加载进 SRAM(片上高速缓存),在片上完成块内注意力,从不物化完整 T×T 矩阵。难点是 softmax 的分母需要全行信息,解决方案是在线 softmax:维护每个行的运行最大值 m 与分母 l,新块到来时按公式修正:
m_new = max(m_old, max(新块得分))
l_new = l_old · e^(m_old − m_new) + Σ e^(新块得分 − m_new)
I/O 复杂度从 O(T²) 降到 O(T²d/M)(M 为 SRAM 大小),实测训练提速 2~4 倍,且数学上与朴素实现严格等价——纯 IO 优化。现代实现(PyTorch 的 scaled_dot_product_attention)已内置,一行代码调用即可。
3. 位置编码:RoPE 为什么赢了
Attention 对顺序天然无感——"猫追狗"与"狗追猫"的 token 集合相同。位置信息必须显式注入,且理想情况下应让 QK 点积只依赖相对位置("追"看"猫",无论它们出现在句首还是句中,相关性应当一致)。
3.1 旧方案的问题
原始 Transformer 用绝对位置加法:x = x + P[m](P 为正弦表或可学习表)。加法扰动会流经所有后续计算,位置与内容纠缠;外推时没见过的位置编码导致性能骤降。
3.2 RoPE:把位置变成旋转
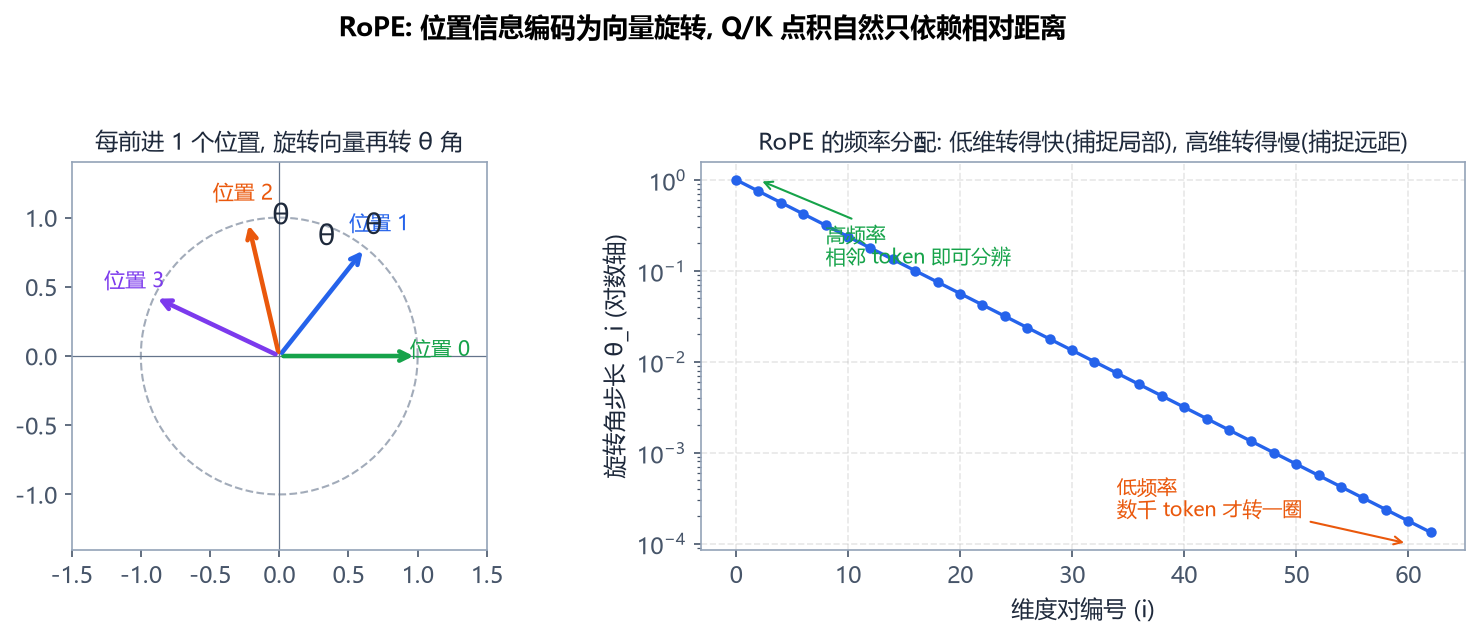
RoPE(Rotary Position Embedding)的构造极其漂亮:把每对维度 (x_{2i}, x_{2i+1}) 看成复平面上的一个点,对位置 m 的 token,把它的 Q 向量旋转 m·θᵢ,K 向量旋转 n·θᵢ(θᵢ = 10000^(−2i/d))。则:
⟨R(mθ)·q, R(nθ)·k⟩ = ⟨q, R((n−m)θ)·k⟩
旋转不改变内积的模,只改变夹角——点积自然只依赖相对距离 n−m。这就是"相对位置编码"却不需要改注意力公式的实现:只是在 q、k 上乘一个与位置相关的正交矩阵。
3.3 频率分配与长度外推
θᵢ = base^(−2i/d)(base=10000)让低维对转得快(高频,分辨相邻 token)、高维对转得慢(低频,波长可达数千 token,捕捉长程关系)。这是多尺度设计,与小波变换同源。
上下文扩展的本质就是拉伸这些频率:
- 位置内插(PI):位置除以 2(4K→8K),相当于所有频率减半——近程分辨率受损,需少量微调恢复;
- NTK-aware:只拉伸 base(10000→更大),高频几乎不动、低频大幅拉伸——近程能力保住,"零样本"外推可用;
- YaRN:在此基础上再对注意力温度做修正,外推 16~32 倍仍可用。
4. FFN:占 2/3 参数的事实记忆库
注意力之后的逐位置前馈网络,参数量常被低估。Llama 的 SwiGLU 变体:
FFN(x) = W_down · ( SiLU(W_gate·x) ⊙ W_up·x )
SiLU(a) = a · sigmoid(a)          # 平滑版 ReLU
⊙ 为逐元素乘 (门控)
三个矩阵 [11008×4096] 合计 1.35 亿/层,是同层注意力(6700 万)的两倍,全模型 64% 的参数在 FFN。为什么是 3 个矩阵而不是 2 个?门控结构需要 gate 与 up 两路投影再相乘;为了参数量与 2 矩阵版本持平,中间维从 4D 压到 8/3D(4096×8/3≈10923,取整 11008)。
功能视角:多项可解释性研究(ROME 等)表明 FFN 神经元编码了可检索的事实知识("巴黎→法国首都"这类键值对),定向编辑 FFN 权重可以增删模型记忆的事实。注意力负责"路由"(哪些 token 相关),FFN 负责"存取"(相关知识是什么)——两者分工明确。
5. 归一化与残差:百层网络的生命线
5.1 LayerNorm → RMSNorm
LayerNorm 对每个 token 向量做均值中心化 + 方差归一 + 仿射:y = γ·(x−μ)/σ + β。RMSNorm 砍掉中心化与偏置:
def rms_norm(x, weight, eps=1e-6):
    return weight * x * torch.rsqrt(x.pow(2).mean(-1, keepdim=True) + eps)
少一次均值计算、少一份偏置参数,效果几乎不掉——LLM 场景均值本就接近 0,中心化是冗余操作。Llama 全系、大部分开源模型都用 RMSNorm。
5.2 Post-Norm → Pre-Norm:梯度流的胜负手
原始 Transformer 把 Norm 放在残差相加之后:x = Norm(x + Sublayer(x))。层数一深,每个 Norm 都对梯度做缩放,反向传播到第 1 层时信号已衰减/爆炸,65 层以上几乎不可训。
Pre-Norm 把 Norm 移进子层之前:
x = x + Attention(RMSNorm(x))
x = x + FFN(RMSNorm(x))
残差主干上再无任何变换——反向传播时梯度沿 x = x + f(x) 的恒等通路无衰减直达底层(∂x_out/∂x_in = I + ∂f/∂x)。代价是表征的有效幅度随层数缓慢增长,由最终 RMSNorm 兜底。GPT-2 之后的所有主流模型都是 Pre-Norm。
5.3 残差流的物理意义
把 L 层展开:h = x₀ + f₁(x₁) + f₂(x₂) + … + f_L(x_L)——最终输出是初始 embedding 与每层贡献的加和。每层只需学习"增量修正"而非完整变换,这既让深层可训,也解释了为什么删掉个别层(layer-skipping 实验)模型只是变差而不会崩溃。
6. 完整实现:带形状断言的最小 Decoder
import torch, torch.nn as nn, torch.nn.functional as F

class Block(nn.Module):
    def __init__(self, d_model=4096, n_head=32, n_kv_head=8, d_ff=11008):
        super().__init__()
        self.n_head, self.n_kv, self.d_k = n_head, n_kv_head, d_model // n_head
        self.wq = nn.Linear(d_model, n_head  * self.d_k, bias=False)  # 4096→4096
        self.wk = nn.Linear(d_model, n_kv   * self.d_k, bias=False)  # 4096→1024 (GQA)
        self.wv = nn.Linear(d_model, n_kv   * self.d_k, bias=False)  # 4096→1024
        self.wo = nn.Linear(n_head  * self.d_k, d_model, bias=False)
        self.gate = nn.Linear(d_model, d_ff, bias=False)
        self.up   = nn.Linear(d_model, d_ff, bias=False)
        self.down = nn.Linear(d_ff, d_model, bias=False)
        self.norm1 = nn.RMSNorm(d_model)
        self.norm2 = nn.RMSNorm(d_model)

    def forward(self, x):                       # x: [B, T, 4096]
        B, T, D = x.shape
        h = self.norm1(x)
        q = self.wq(h).view(B, T, self.n_head, self.d_k).transpose(1, 2)  # [B,32,T,64]
        k = self.wk(h).view(B, T, self.n_kv,  self.d_k).transpose(1, 2)   # [B,8,T,64]
        v = self.wv(h).view(B, T, self.n_kv,  self.d_k).transpose(1, 2)   # [B,8,T,64]
        k = k.repeat_interleave(self.n_head // self.n_kv, dim=1)          # GQA 广播到 32
        v = v.repeat_interleave(self.n_head // self.n_kv, dim=1)
        # RoPE 作用在 q/k 上 (此处省略, 见上文公式)
        att = F.scaled_dot_product_attention(q, k, v, is_causal=True)     # FlashAttention
        att = att.transpose(1, 2).reshape(B, T, D)                        # 拼接头
        x = x + self.wo(att)                                             # 残差
        h = self.norm2(x)
        x = x + self.down(F.silu(self.gate(h)) * self.up(h))            # SwiGLU
        return x

# 冒烟测试: 单 block 前向 + 形状断言
blk = Block(d_model=512, n_head=8, n_kv_head=2, d_ff=1376)
x = torch.randn(2, 16, 512)
y = blk(x)
assert y.shape == (2, 16, 512), y.shape
print("Block forward OK:", y.shape)   # [2, 16, 512]
7. 参数量与显存的精确账本
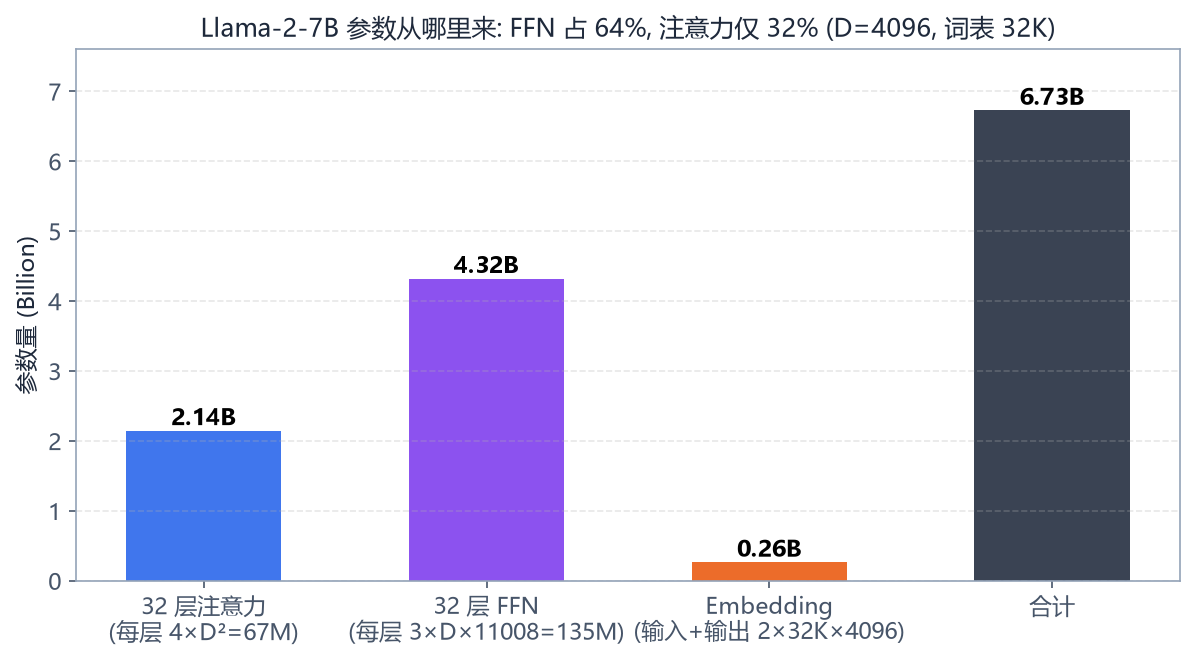
逐项清点 Llama-2-7B(D=4096,L=32,d_ff=11008,V=32000,GQA 8 组):
| 部件 | 公式 | 单层/总量 |
|---|---|---|
| 每层注意力 QKV+O | (D·D) + 2×(D·D/4) + (D·D) = 2.5D²(GQA) | 4200 万 |
| 每层 FFN | 3 × D × d_ff | 1.35 亿 |
| 32 层小计 | 32 × (2.5D² + 3D·d_ff) | 56.6 亿 |
| Embedding(tied) | V × D | 1.31 亿 |
| 合计 | — | ≈ 67.4 亿 ✓ |
训一个 7B 模型需要多少显存?按 AdamW 混合精度逐项算(每参数):
权重 (BF16)           2 字节
梯度 (BF16)           2 字节
优化器: master 权重 (FP32)   4 字节
        Adam 一阶动量 (FP32) 4 字节
        Adam 二阶动量 (FP32) 4 字节
─────────────────────────────────────
合计 16 字节/参数 → 7B × 16B = 112 GB (还没算激活!)
单张 80GB 的 A100 连权重加优化器都放不下——这就是训练篇要讲的 ZeRO/TP/PP 并行的直接动机。而推理时只需 2 字节/参数(14GB),瓶颈转移到 KV Cache 与带宽上——推理篇展开。
8. 现代架构的稳定性补丁
最后补几个 2023+ 模型(Qwen2.5、Llama-3.1 等)里的细节,它们解决的都是深层/长上下文训练的病:
- QK-Norm:对 q、k 在 RoPE 之前再做一次 RMSNorm,压制注意力 logits 的幅度漂移,深模型/长序列训练更稳;
- Logit soft-capping(Gemma-2):把注意力分数压进 [−cap, cap] 的 soft 饱和区,防止个别头垄断;
- 嵌入缩放:embedding 乘 √D 进入主干,让 embedding 幅度与残差流匹配。
这些补丁不影响对架构主线的理解,但读源码时会遇到,值得知道它们各自治什么病。
9. 小结
- 数据流主线:查表 → L×(Attention+FFN,Pre-Norm,残差) → 归一化 → 投影到词表,训练时每步 T 个位置并行出损失;
- 注意力三件套:√d_k 缩放(方差归一)、因果掩码(训练不泄题)、在线 softmax(FlashAttention 的分块根基);
- RoPE 用旋转编码相对位置,多尺度频率 + base 拉伸支撑 4K→128K 的上下文扩展;
- FFN 占 64% 参数、承担事实记忆;Pre-Norm + RMSNorm + 残差让 32~80 层可训;
- 参数与显存要会算:2.5D²+3D·d_ff 每层、16 字节/参数的 AdamW 训练开销——这两个数字是理解训练与推理两篇的地基。
下一篇:架构只是上限,怎么用万亿 token 把它训到位——预训练、SFT 与对齐的完整工程。