
千卡训练集群:互联网络、集合通信与故障容忍
训练篇算过账:7B 模型训练态 112GB,需要多卡;真实的大模型训练动辄几百上千张卡。这时瓶颈从"单卡算力"变成"卡间与节点间的数据搬运"——千卡集群的有效算力(MFU)一半取决于芯片,另一半取决于网络与通信算法。这篇把集群层彻底拆开:all-reduce 环算法的逐步推导与带宽公式、参数面网络的 spine-leaf 设计、三种并行的通信量账本、NCCL/HCCL 做了什么,以及千卡集群的故障容忍体系。
1. 问题:梯度同步到底要搬多少数据
数据并行最朴素的需求:每张卡算不同 batch,反传后各自手里的梯度必须变成全卡平均——这就是 all-reduce(全归约)。7B 模型 FP16 梯度是 14GB;8 卡朴素做法(全发到 0 号卡求和再广播):
0 号卡收: 7×14 = 98 GB, 发: 7×14 = 98 GB   ← 单点收发 196GB
其他卡带宽闲置, 0 号卡链路被打爆
树形(reduce-broadcast)改进了负载,但仍要求网络具备高扇出的交换能力。千卡场景的正确答案是环。
2. Ring All-Reduce:算法逐步拆解
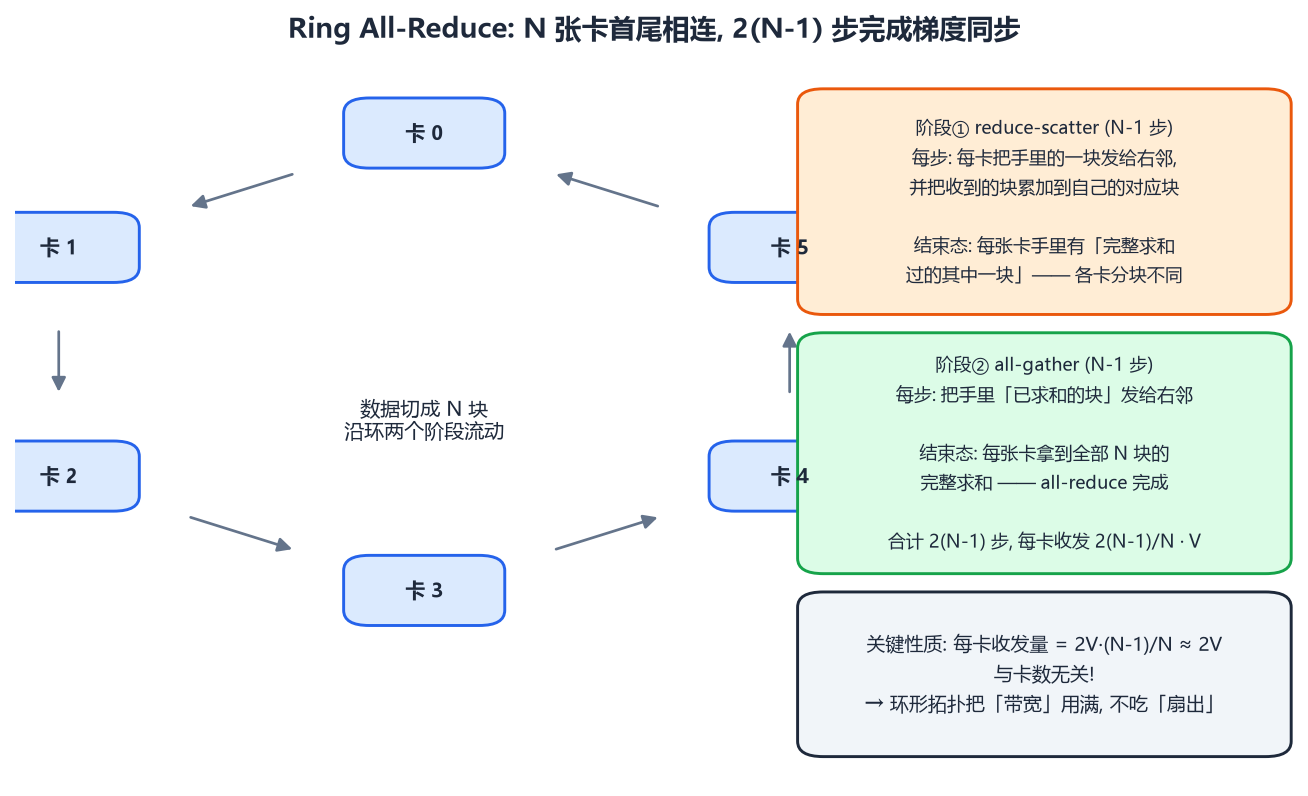
N 张卡首尾连成环,梯度切成 N 块。两个阶段、共 2(N−1) 步:
阶段① reduce-scatter(N−1 步):每一步,每张卡把自己"负责"的块发给右邻,并把收到的块累加到自己的对应块上。N−1 步后,每张卡手里恰好有一块是全局求和完整的(各卡负责的块不同)。
阶段② all-gather(N−1 步):把手里那块"已求和"的块沿环传 N−1 步,人人拿到全部 N 块的完整求和。完成。
关键性质一行算清:
每卡总收发量 = 2 × V × (N−1)/N ≈ 2V (V 为梯度总量)
与卡数 N 无关——8 卡和 1024 卡,每卡搬运的总量几乎一样,只随步数增加而拉长时间。这就是环形算法的价值:把同步成本从"扇出受限"变成"带宽受限",而带宽恰好是网络可以堆的东西。
2.1 分块数:一个真实存在的甜点
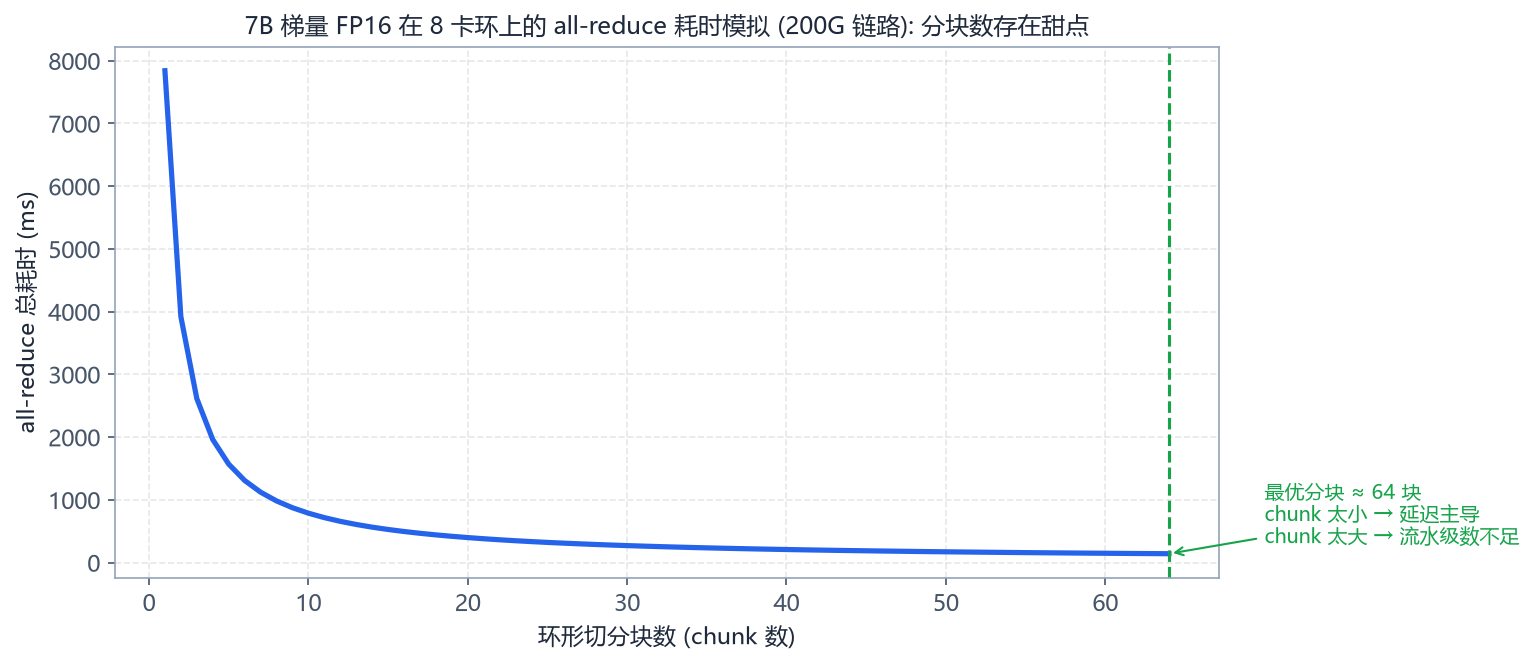
整块数据不能一次塞进网卡收发:切太少,每步消息太大,流水级数不足;切太碎,每步固定延迟(逐跳 latency)累积主导。上图是 7B 梯度、8 卡、200G 链路的模拟——分块数存在明显甜点,这正是 NCCL/HCCL 这类通信库内部要自动搜索的参数之一(chunk 大小、并行环数、协议切换 point-to-point / 简单算法的边界)。
2.2 NCCL / HCCL 做了什么
通信库的职责清单:探测拓扑(NVLink/HCCS 机内环 + 跨机环)→ 选择算法(ring / tree / 双环并行)→ 搜索分块与通道参数 → 暴露 all_reduce() 一个调用给框架。两套栈(NCCL 对 GPU、HCCL 对昇腾)在这层的算法与数学完全同源,差异在拓扑适配与调优经验——这呼应上一篇"CUDA→NPU 迁移清单"里的通信回归项。
3. 参数面网络:spine-leaf 的必然性
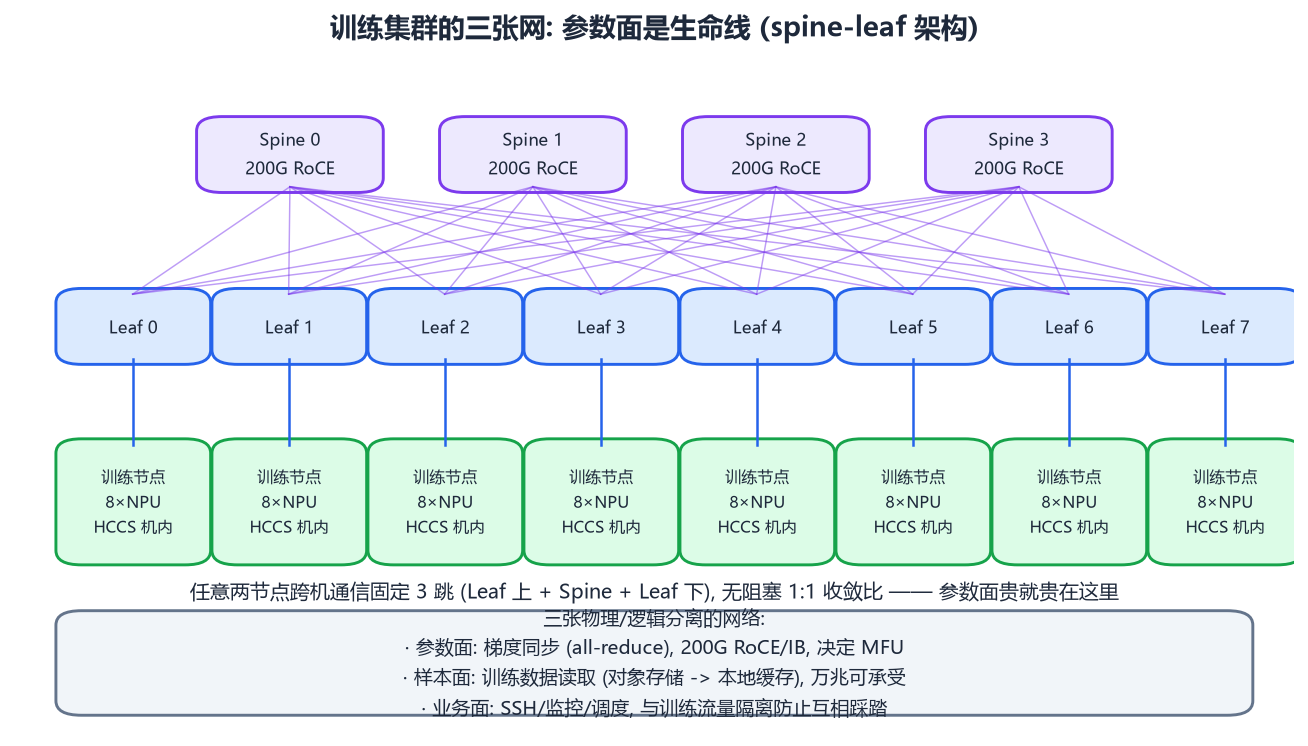
集群实际跑着三张逻辑网:
- 参数面:承载 all-reduce 梯度流量,200G RoCE(或 IB)每卡,1:1 无阻塞收敛比——贵,且必须 spine-leaf 两层架构保证任意两节点固定 3 跳、无超订;
- 样本面:训练数据从对象存储拉到本地缓存(数据管线),万兆/25G 可承受;
- 业务面:SSH、监控、调度指令,与训练流量隔离,防止一次大文件 scp 拖慢全局梯度同步。
RoCE(RDMA over Converged Ethernet)的意义:内核旁路 + 零拷贝,把 TCP 栈几十微秒的软件开销压到微秒级,同时绕过 CPU——千卡同步是每秒都在发生的事,这个开销乘以步数就是天文数字。与之配套的还有 PFC/ECN 流控(无损以太网)、以及交换机缓冲的水线配置——参数面的稳定性工程(不丢包)是训练稳定性的隐形地基,很多"莫名 loss spike"最后定位到网络层微突发丢包重传。
机内与跨机的分工(呼应硬件篇):机内 8 卡走 NVLink/HCCS 全互联(数百 GB/s),跨机走 200G RoCE(25GB/s)——相差一个数量级,这就是 TP 锁在机内、PP/DP 承担跨机的物理原因。
4. 三种并行的通信量账本
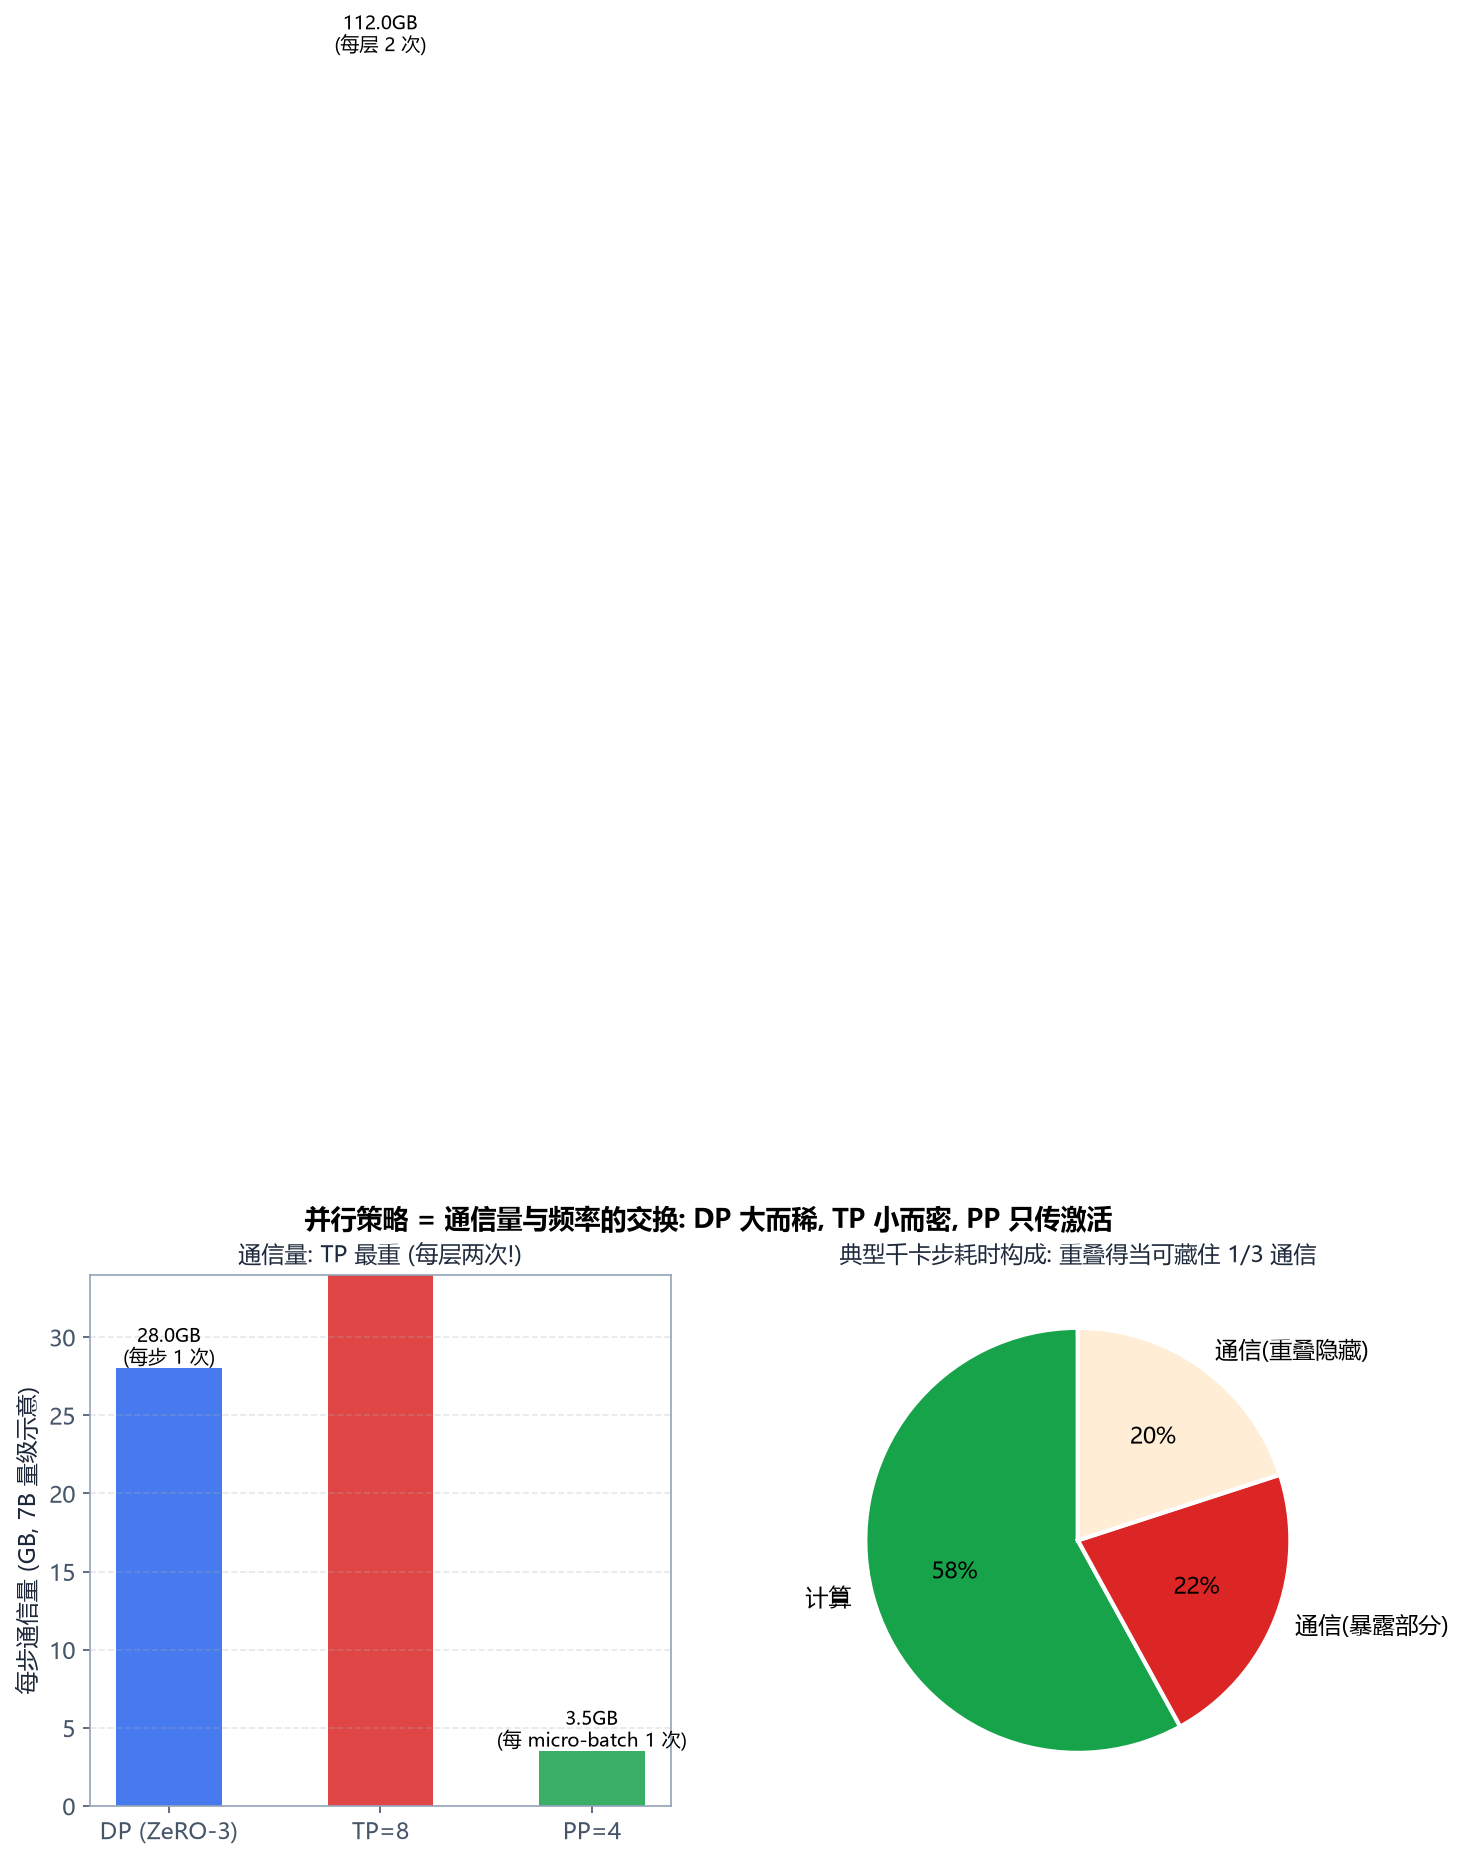
把训练篇的并行策略翻译成通信语言(7B 量级、每步):
| 并行 | 通信内容 | 频率 | 量级 | 承载网络 |
|---|---|---|---|---|
| DP(ZeRO-3) | 梯度/参数/优化器分片 all-reduce+all-gather | 每步 1 次 | ~2V(V=分片总量) | 跨机参数面 |
| TP=8 | 每层前向/反向各两次 all-reduce | 每层 2 次 | 单次小但极频繁 | 机内 NVLink/HCCS |
| PP=4 | 层间激活(micro-batch 传给下一段) | 每 micro-batch | 激活大小 | 机内或相邻机 |
结论三条:
- TP 通信最密,必须待在机内高速互联上(几百 GB/s 才喂得起每层两次的 all-reduce);
- DP/ZeRO 通信最大但稀(每步一次),跨机 200G 网络刚好对口;
- PP 最省(只传激活),但要吃流水线空泡((p−1)/(m+p−1))——所以超大模型跨机时 PP 是受欢迎的跨机组网维度。
重叠是第二半工程:通信与计算并行执行(反向传播到哪一层,哪一层的梯度就先发出去),典型系统可把 1/3 的通信时间藏进计算里。 MFU 的公式里因此有两项:MFU = 计算时间 / (计算时间 + 暴露的通信时间)——调优目标就是把"暴露"那部分压到最小。
5. 故障容忍:千卡集群的日常
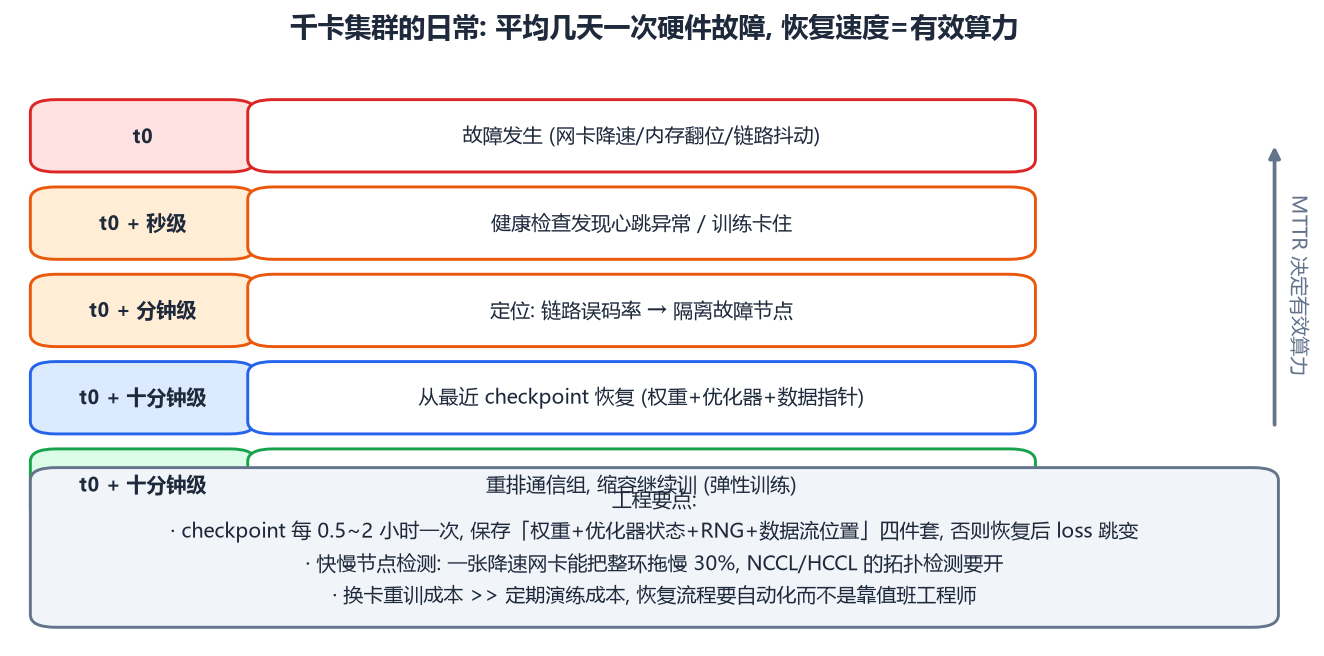
一个不太直觉的事实:千卡集群平均几天就会遇到一次硬件故障(内存翻位、网卡降速、光模块劣化、链路抖动)。故障不是异常,是常态——于是MTTR(平均恢复时间)直接等于有效算力:
- 检测:心跳 + 集合通信超时。一张"变慢但没死"的网卡最阴险——环上所有卡陪它降速,吞吐掉 30% 却不报警,需要 NCCL/HCCL 的健康检查与误码率监控来抓;
- 定位:链路层工具看 CRC 错误计数,快速隔离故障节点;
- 恢复:从最近 checkpoint 加载四件套——模型权重、优化器状态(Adam 动量!丢了它 loss 会跳变)、RNG 状态(保证数据流与 dropout 可续)、数据流位置。checkpoint 间隔(0.5~2 小时)是"恢复损失"与"写盘开销"的折中;
- 弹性:现代框架支持缩容/换卡续训(重排通信组),不必整集群重启。
把这条流水线自动化(而不是靠值班工程师手搓)是训练平台团队的核心产出之一。
6. 存储与数据面:别让 GPU 等饭
数据面虽然带宽要求低,但喂不上数据 = 全集群空转:
- 训练数据放对象存储(S3/OBS),计算节点本地 SSD 做 LRU 缓存——epoch 2 起命中率接近 100%;
- 数据集预打包成 tokenized 的二进制分片(如 webdataset 风格),避免训练时临时解压/分词——把数据管线的计算挪到训练之前;
- 混合精度训练时 DataLoader 的
pin_memory+ 预取流水(页锁定内存直达 DMA,呼应 CANN 篇的 Host 内存分配)。
7. 一张账本收尾
7B 模型、512 卡、A100/910B 级算力(量级推算):
每步计算量      ≈ 6 × 7e9 × 512 × 4096(token/step 全局 batch) ≈ 8.8e16 FLOP
每卡每步计算    8.8e16 / 512 = 1.7e14 → 400 TFLOPS 卡需 0.43s (100% 利用)
实际 MFU 45%    → 每步 ~0.95s
每步通信(暴露)  ~0.2s: ZeRO-3 梯度量 28GB/卡 ÷ 25GB/s ≈ 1.1s, 重叠藏掉 80%
账本能立刻暴露瓶颈在哪:是算力(MFU 低)、通信(暴露多)、还是数据供给(GPU 利用率间歇掉零)——先算账再调优,与推理篇的方法论一脉相承。
8. 小结
- all-reduce 环算法把每卡搬运量压到 ≈2V 与卡数无关,reduce-scatter + all-gather 两阶段 2(N−1) 步;
- 分块数有甜点,NCCL/HCCL 的核心工作是拓扑感知的算法与分块搜索;
- 参数面 spine-leaf 无阻塞 + RoCE 微秒级延迟 + 三网隔离,网络稳定性是训练稳定性的隐形地基;
- 通信量排序:TP 密而重(锁机内)、DP/ZeRO 大而稀(对口跨机)、PP 最省但有空泡;重叠隐藏决定 MFU;
- 千卡集群故障是常态,MTTR=有效算力:检测-定位-checkpoint 四件套-弹性恢复全链自动化。
硬件、单机软件栈、集群都有了,最后一块拼图是"运营"——下一篇:算力调度、NPU 切分与推理集群的 K8s 化部署。