
AI 算力硬件:从 CPU 的三堵墙到 NPU 的达芬奇架构
前面七篇把 LLM 的模型与系统层走完了,从这篇开始进入支撑一切的AI Infra(AI 基础设施)。第一站是硬件:为什么 CPU 跑不动大模型、GPU 凭什么成为主力、NPU(以昇腾达芬奇架构为例)又用什么样的设计哲学换取能效,以及端侧 NPU(RK3588 这类)的取舍。仍然是从晶体管分配讲到数据流,全部落到可计算的数量级上。
1. 三堵墙:一切硬件设计的出发点
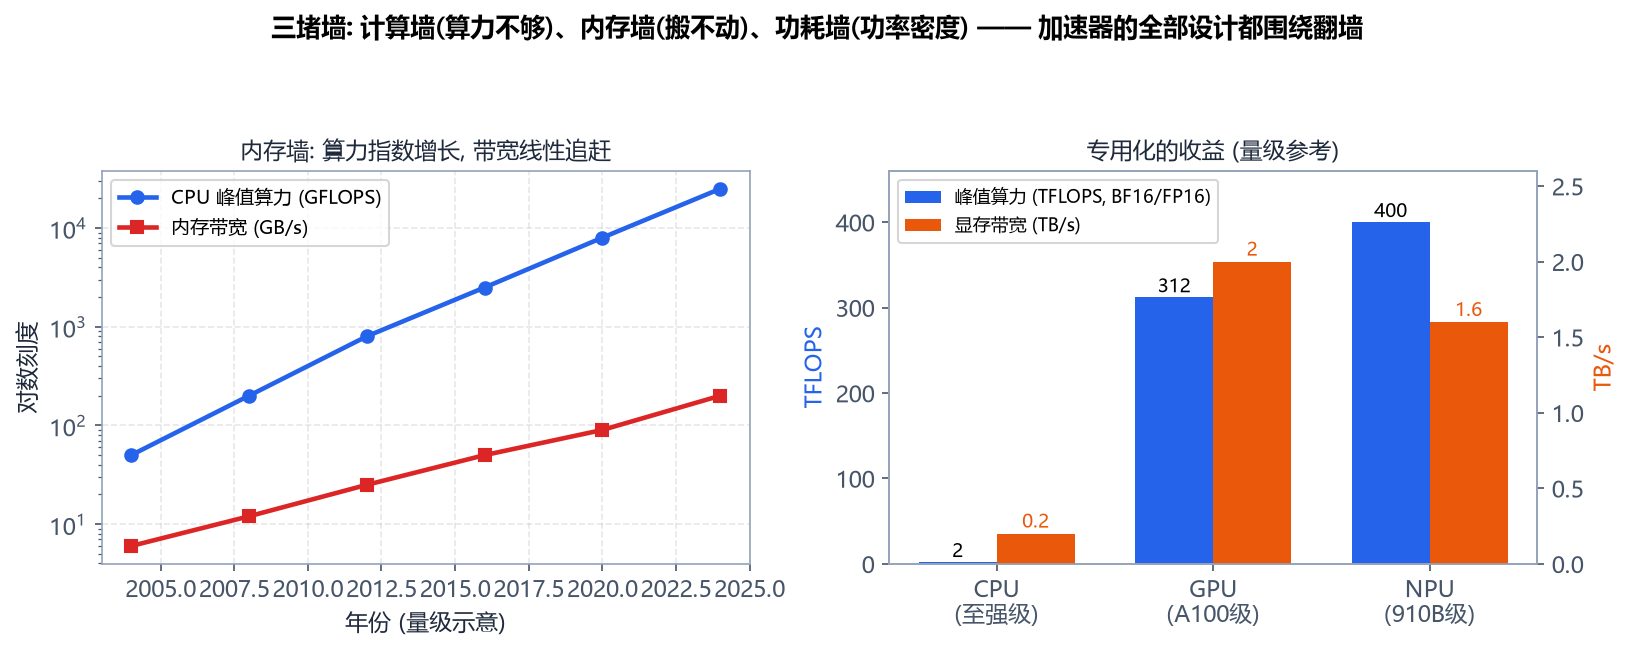
计算墙:一个 7B 模型训练一次约需 10²¹ FLOPs 量级的计算(按 Chinchilla 法则 6ND 估算:6 × 7e9 × 2e12 ≈ 8.4e22,即数万卡·月)。一颗通用 CPU 的峰值算力是 TFLOPS 级,差了十几个数量级——必须用大规模并行。
内存墙:二十年来处理器算力指数增长,内存带宽却近乎线性(图左)。回顾推理篇的结论:decode 阶段算术强度 ≈ 1 FLOP/Byte,而现代加速器"跑满算力"需要 100~300 FLOP/Byte 的强度——搬运能力的缺口决定了大芯片的大部分面积要花在缓存与互联上。
功耗墙:机房供电与散热有硬上限。同样 1 焦耳能量,专用芯片能完成的 MAC 次数可以是通用芯片的数倍到数十倍——能效比(TFLOPS/W)是数据中心和端侧共同的第一性指标。
三堵墙共同指向一个答案:把晶体管从"通用控制逻辑"挪给"乘加阵列 + 数据搬运"。GPU、NPU、ASIC 的差异只是这条路线走得有多坚决。
2. CPU 为什么不行:晶体管花在了哪
一颗现代服务器 CPU 的晶体管预算大致分配:大半在缓存(L1/L2/L3 可占 30~50%)与控制(分支预测器、乱序执行窗口、重命名寄存器),真正做运算的 ALU 只占一小部分。这套设计为的是单线程延迟——任何一段串行代码都快。
它对付矩阵乘的姿势:一条 AVX-512 指令一次算 16 个 FP32 FMA(32 FLOP),核数 × 频率 × 向量宽度拼出峰值。问题有三:
- 算力密度低:数十核 × 每周期数百 FLOP,总量停在 TFLOPS 级;
- 带宽配不上:DDR 通道数百 GB/s,喂饱上述算力需要的 TB/s 级;
- 能效差:大量功耗消耗在"让指令流跑起来"而不是计算本身。
矩阵乘是高度规则、海量数据并行的负载——为串行延迟优化的 CPU 拿到它,就像用轿车拉砂石。
3. GPU:吞吐型并行的成熟答案
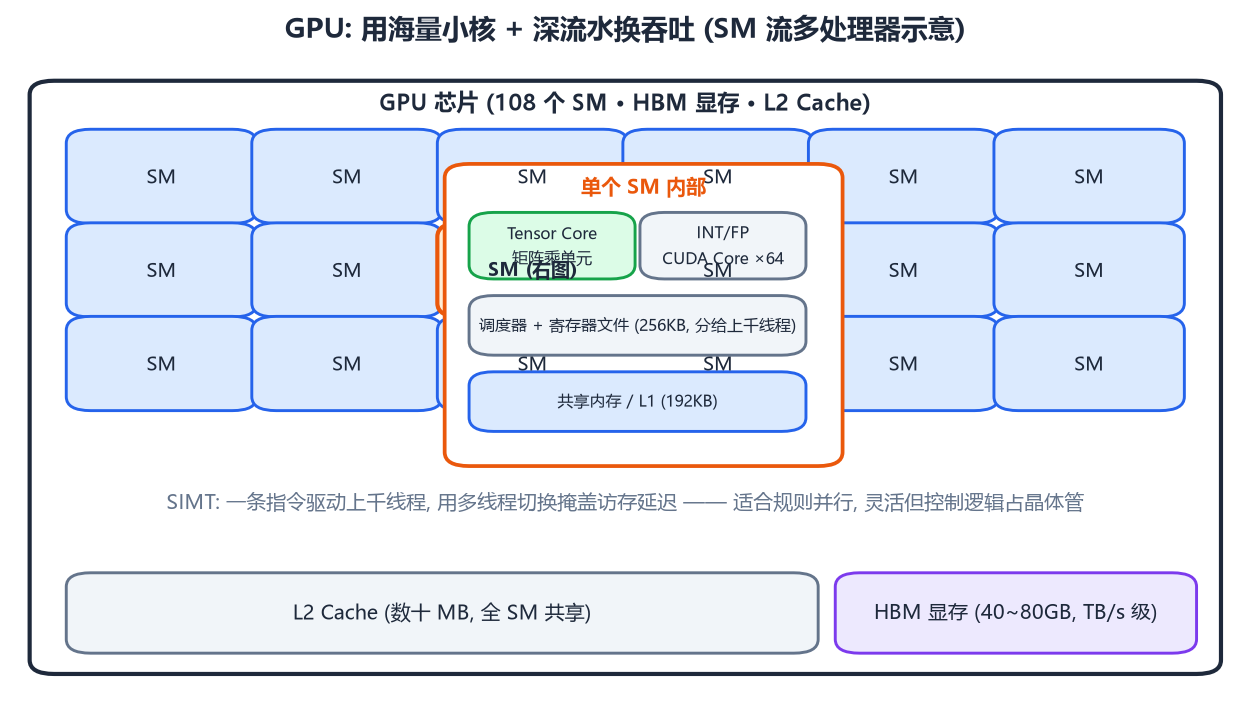
GPU 的思路是用 thousands of threads 淹盖延迟(SIMT 模型):一颗芯片上百个 SM(流多处理器),每个 SM 承载上千线程;某批线程等显存时,调度器零开销切到另一批——不需要大缓存,靠并行度把访存延迟藏掉。
为 AI 带来质变的是 Tensor Core:一条指令完成一个小矩阵块的乘累加(如 16×8×16 的 MMA),把"乘加阵列"固化成硬件单元。A100 级别的 BF16 峰值 312 TFLOPS,其中绝大多数由 Tensor Core 贡献——CUDA Core 只是配角。配合 HBM(2TB/s 级)与数十 MB L2,Transformer 的大 GEMM(通用矩阵乘)正好是它的甜点负载。
GPU 的代价:SIMT 的灵活性(任意 kernel、任意访存模式)需要完整的硬件线程调度、寄存器堆、指令缓存——这些晶体管不直接产出 FLOPS,能效比天然低于专用架构。NPU 的机会就在这里。
4. NPU 设计哲学:以昇腾达芬奇架构为例
国产 NPU 里生态最完整的是华为昇腾。它的核心计算IP叫达芬奇架构,设计哲学一句话:假定负载就是神经网络算子,把一切资源向矩阵乘与数据搬运倾斜。
4.1 三种计算单元:各干一件事
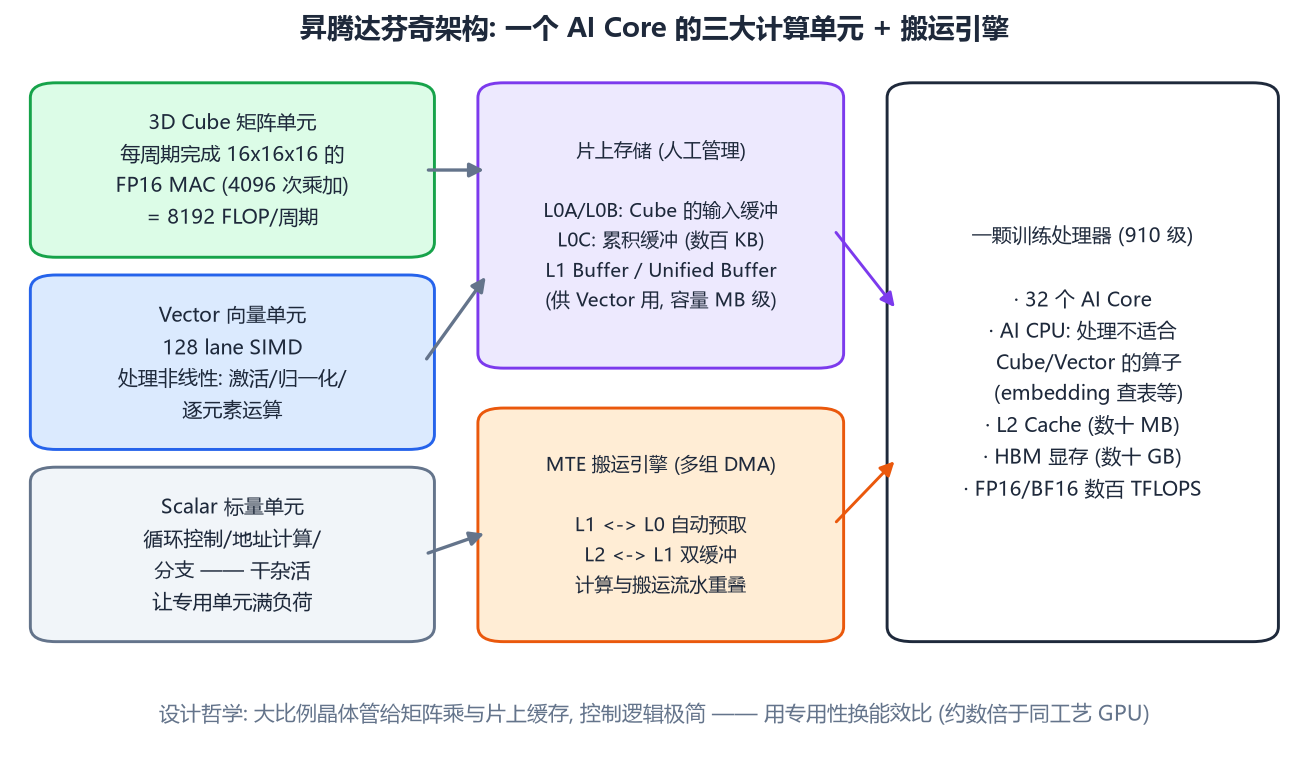
每个 AI Core 内有三类单元,一个 kernel 里三类单元同时流水:
- 3D Cube(矩阵单元):架构的灵魂。一个周期完成一个 16×16×16 的乘累加块——输出平面上 256 个输出、每个输出 16 次 MAC,共 4096 次 MAC(8192 FLOP)/周期。这比向量单元乘同样规模的矩阵快一个数量级;
- Vector(向量单元):128 lane 的 SIMD,处理激活函数、LayerNorm/RMSNorm、逐元素加减——矩阵乘之外的"非线性杂活";
- Scalar(标量单元):循环控制、地址计算、分支。专门有个单元干这个,是为了让 Cube 和 Vector 不被控制流打断——专用化的意义就是互不等待。
不适合 Cube/Vector 的算子(embedding 查表、动态形状控制)交给旁边的 AI CPU(常规 CPU 核),不占 AI Core。
4.2 Cube 一个周期在算什么
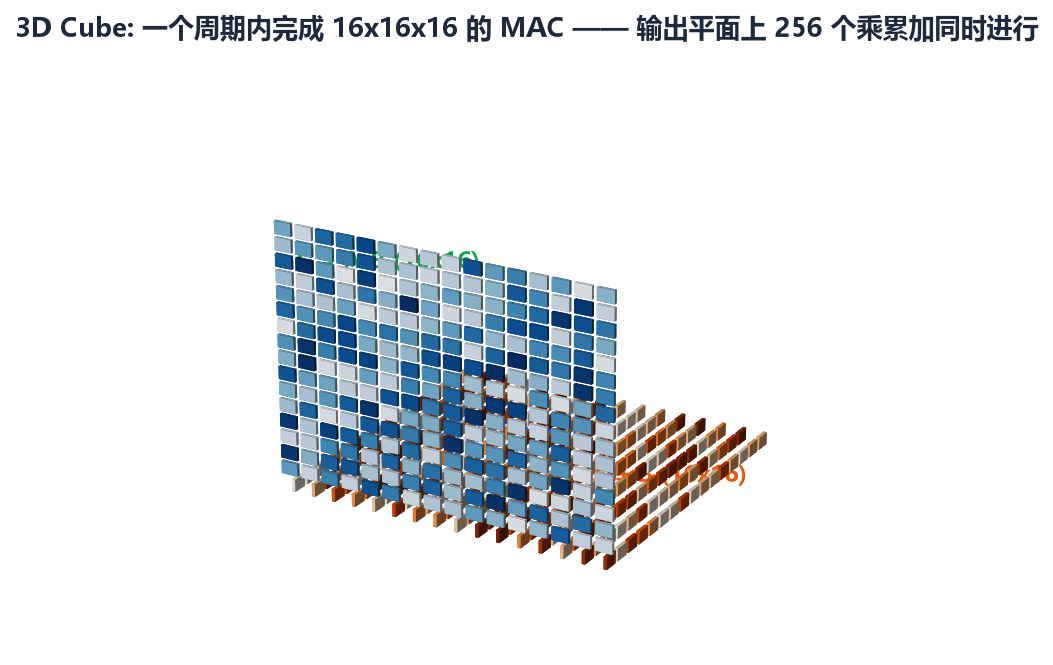
大矩阵乘 C=A·B 被切分成 16×16 的小块:Cube 每周期取 A 的一个 16×16 面、B 的一个 16×16 面,累加进 C 的 16×16 面(L0C 累积缓冲)。软件(算子编译器)的工作就是把这个分块循环、L0A/L0B 的预取、L0C 的写出编排成无缝流水。这本质上是把脉动阵列(systolic array)的思想做成了固定功能单元——数据进阵列后在内部流动复用,控制开销接近零。
4.3 存储层次:手动管理的金字塔
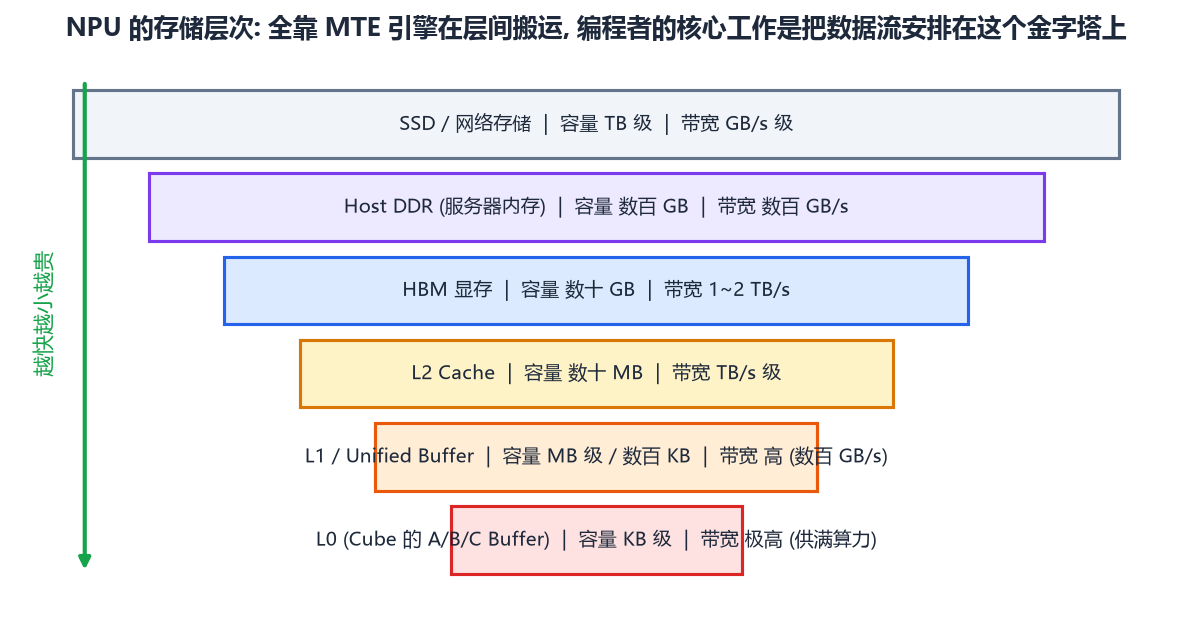
与 GPU"缓存对程序员透明"不同,达芬奇的 L0A/L0B/L0C、L1/Unified Buffer 对算子开发者可见可控,配合多组 MTE 搬运引擎(DMA)做双缓冲:Cube 在算第 N 块时,MTE 已经在搬第 N+1 块。计算与搬运完全重叠——这是能效的另一个来源:没有缓存命中率的赌局,只有确定性的数据流编排。
一颗 910 级训练处理器:32 个 AI Core + AI CPU + 数十 MB L2 + 数十 GB HBM,FP16/BF16 数百 TFLOPS 量级;更新的 910B 级别把 BF16 算力推到 400 TFLOPS 量级、HBM 扩到 64GB——对标国际旗舰 GPU 的训练规格。
4.4 与 GPU 的本质区别
| 维度 | GPU | 达芬奇 NPU |
|---|---|---|
| 并行模型 | SIMT,线程调度硬件化 | 数据流编排,编译期静态调度 |
| 矩阵乘 | Tensor Core 指令 | Cube 固定单元 + 分块流水 |
| 片上存储 | 缓存层次,透明 | L0/L1 显式管理 |
| 灵活性 | 任意 kernel | 面向 NN 算子族 |
| 能效 | 基准 | 同工艺下约数倍 |
| 生态 | CUDA 城墙 | CANN 追赶中 |
一句话:GPU 是"并行的通用机",NPU 是"神经网络的专用机"。专用性换来能效与成本,代价是生态——下一篇讲 CANN 如何在软件上补这块短板。
5. 卡间互联:另一条胜负手
单颗芯片放不下大模型(训练篇:7B 需要 112GB 训练态),卡间带宽成为集群性能的一部分:
PCIe 4.0 x16     ≈ 32 GB/s    —— GPU 传统连接, TP 并行下严重不够
NVLink (A100)    ≈ 600 GB/s   —— 8 卡全互联, 机内
HCCS (昇腾)      ≈ 数百 GB/s  —— 机内卡间高速互联
跨机             RoCE/IB 200G  —— 参数面网络 (集群篇展开)
TP 并行每层要做两次卡间通信,PCIe 的 32GB/s 会把数百 TFLOPS 的算力饿死——机内高速互联(NVLink/HCCS)是训练卡与推理卡的本质区别之一,这也是为什么"8 卡机"是并行策略的最小完整单元。
6. 端侧 NPU:另一个极端的设计
写这篇的读者里应该不少玩过 RK3588——它就是端侧 NPU 的典型样本:
- 3 个 NPU 核、合计 6 TOPS(INT8):注意单位是 TOPS 不是 TFLOPS——端侧靠 INT8 量化拿算力(INT8 吞吐是 FP16 的 2~4 倍),呼应量化篇的结论:端侧部署 = 量化 + 轻量化模型 + NPU;
- 工具链 RKNN-Toolkit2:ONNX → RKNN 转换 + 量化(PTQ/QAT)+ 仿真 + 板端部署,思路与云端一致但更强调"转换即部署";
- 设计取舍:无 HBM(共享 DDR,带宽是最大约束)、Cube 规模小、追求 TOPS/W 而非绝对算力。跑 7B 级 LLM 需要到 4bit 量化 + 内存带宽的极限优化——端侧 LLM 至今仍是"带宽问题"多过"算力问题"。
端侧/嵌入式背景的工程师切入 AI Infra,路径通常是:RKNN 部署小模型 → 量化与算子适配 → 云端训练/推理集群——这条线正好把量化篇和本系列连起来。
7. 选型:什么任务用什么芯片
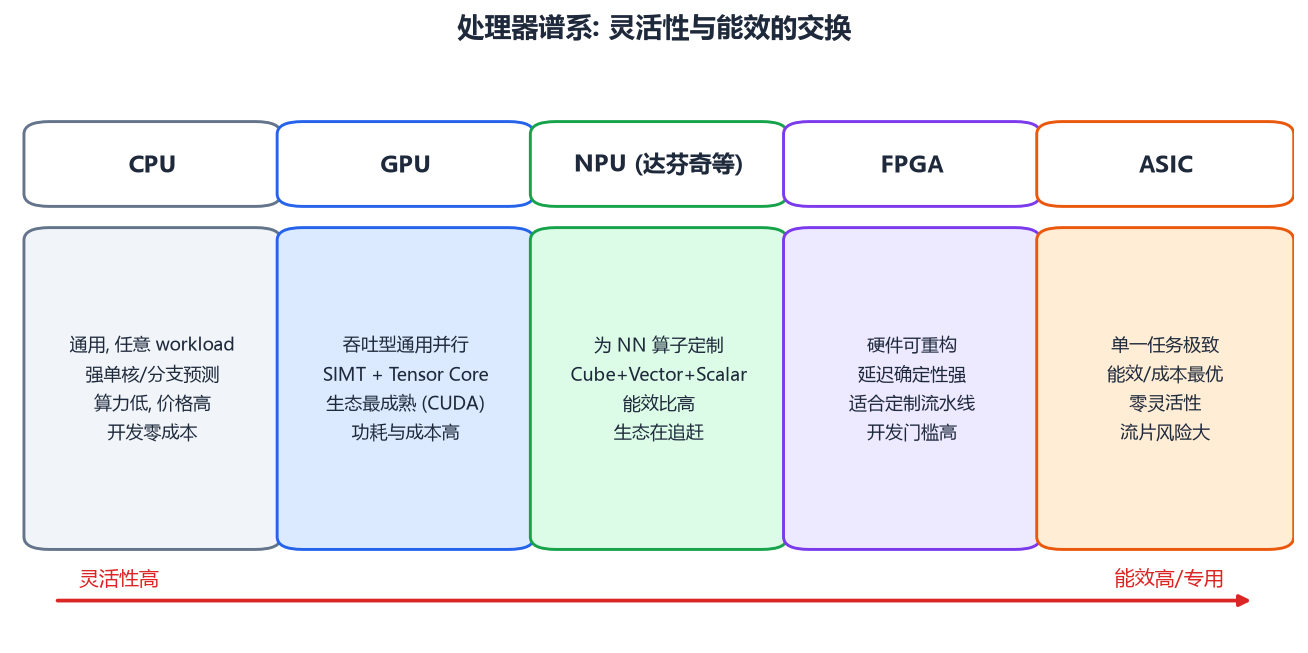
- 云训练/大规模推理:GPU 或训练级 NPU(910B 类),看算力、HBM 容量、卡间互联与生态支持;
- 私有化中等规模推理:推理卡(310B 类:高能效、多卡密度)或国产 GPU,重点算 token 成本;
- 端侧/嵌入式:RK3588 NPU、Jetson、专门的 LLM 端侧芯片——INT8/4bit 生态成熟度是第一考量;
- 非 NN 的高吞吐定制负载(低延迟转发、特定信号处理):FPGA 仍有一席之地。
8. 小结
- 三堵墙(计算/内存/功耗)决定了 AI 芯片把晶体管从控制逻辑挪向乘加阵列与数据搬运;
- GPU 用 SIMT 线程淹没延迟 + Tensor Core 固化矩阵乘,生态(CUDA)是其最深护城河;
- 达芬奇 NPU 用 Cube/Vector/Scalar 三单元分工 + 显式存储层次 + MTE 双缓冲,拿专用性换能效;
- 机内互联(NVLink/HCCS)是训练卡的生死线,跨机参数面是集群篇的主题;
- 端侧 NPU 是"带宽受限下的量化艺术",RKNN 工具链是嵌入式工程师的切入起点。
硬件给了算力,但让 32 个 AI Core 或 108 个 SM 干活的是软件栈——下一篇:以昇腾 CANN 为例拆解 NPU 编程栈,逐层对照 CUDA。