
大模型训练全景:预训练、SFT 与 RLHF/DPO 对齐的完整链路
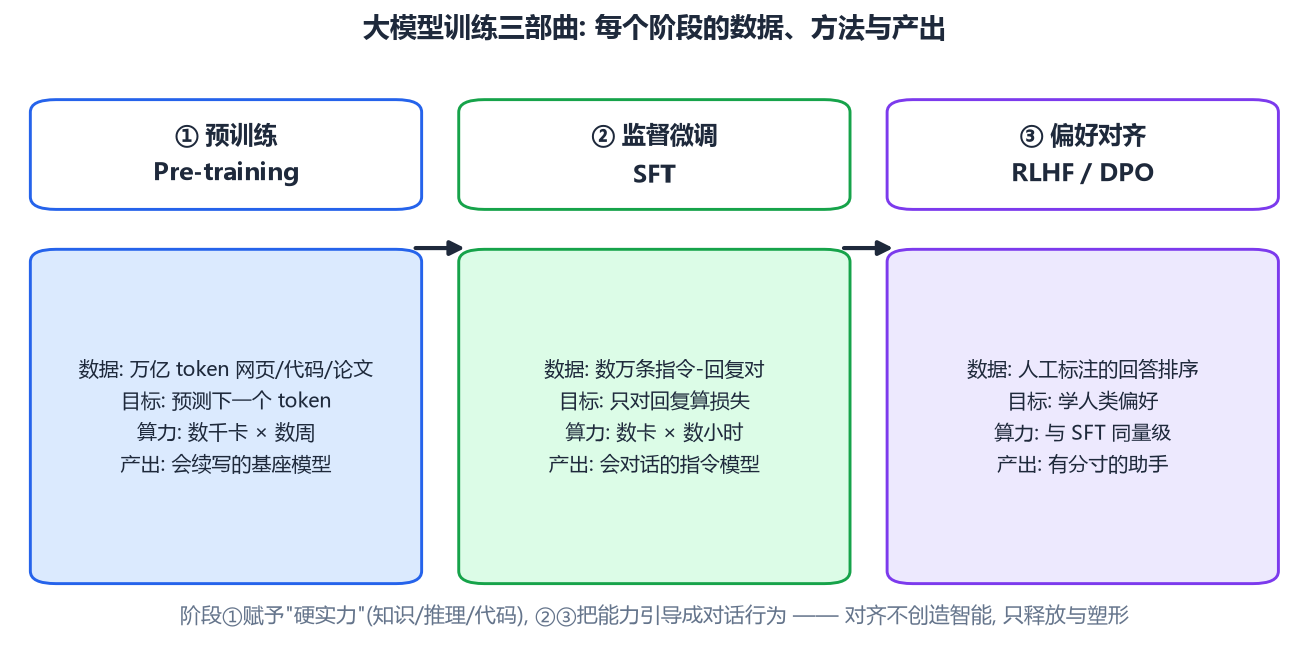
有了架构只是有了"一台没装系统的电脑"。从基座模型到能对话、能干活的助手,要经历三个阶段:预训练 → 监督微调(SFT)→ 偏好对齐(RLHF/DPO)。这篇把每个阶段拆到公式与字节级:目标函数怎么写、数据管线怎么洗、AdamW 状态为什么吃 12 字节/参数、ZeRO/TP/PP 各切什么、LoRA 的低秩数学、RLHF 的 Bradley-Terry 模型与 DPO 的闭式推导,以及 loss spike 怎么救。
1. 预训练:下一个 token 预测
1.1 目标函数与它的交叉熵本源
给定语料 x₁..x_T,预训练最大化对数似然,等价于最小化逐 token 交叉熵:
L = −(1/T) · Σ_t log P(x_t | x_<t ; θ)
实现上:模型每个位置输出 logits [V] → softmax → 取"真实下一个 token"那一项的 −log p。没有标签、没有人工,互联网本身就是无穷监督信号。这个任务看似简单,但预测下一步的最优策略隐含了对世界的建模:要续写"E=mc"就得懂相对论,要续写 def binary_search 就得懂算法——能力是压缩的副产品。
训练日志里看到的 loss ≈ 2.0 是什么概念?交叉熵 2.0 nat ≈ 每 token 平均不确定性 e²≈7.4 个等概率选项;GPT-4 级模型在干净文本上可到 1.0~1.5。perplexity = e^loss,是评测预训练质量的第一指标。
1.2 数据管线:垃圾进、垃圾出
Llama-3 用了 15T+ token,管线五步:
- 抓取过滤:Common Crawl → 语言分类器 → 质量打分(用小模型训练"好页面"分类器)→ 剔除成人/暴力/模板页;
- 去重:MinHash + LSH 近似去重。原理:对文档的 k-gram 集合算一组哈希"指纹",指纹相近即判重复,避免两两比对 O(n²)。web 级数据通常能去掉 30%~50% 冗余——重复是"背原文"和过拟合的头号元凶;
- 配比:网页 ~60%、代码 ~15%、数学、论文、多语言。代码对推理能力的提升有充分实证(消融实验中去掉代码语料,GSM8K 类推理基准明显掉点);
- 课程/退火:训练末期把高质量数据(数学、代码、精选网页)比例调高,学习率已低,好的数据"淬火"效果最好;
- 毒性与安全过滤:预训练阶段只做轻量过滤(过狠会伤能力),重活留给对齐阶段。
配比是各家最核心的商业机密——同样的算力与架构,配比差异足以造成代差。
1.3 batch 组织:packing 与文档隔离
训练序列长度固定(如 8192),而文档长度参差。packing 把多个短文档拼进一条序列填满窗口,但必须配文档边界掩码:注意力计算时阻止跨文档可见,否则模型学到"上一篇的结尾影响下一篇的开头"这种伪关联。显存紧张时也有人干脆不隔离(Llama-1 论文承认没做),损失一点纯净度。
1.4 混合精度:BF16 为什么赢了 FP16
| 格式 | 指数位 | 范围 | 尾数位 | 精度 |
|---|---|---|---|---|
| FP32 | 8 | ±3.4e38 | 23 | 高 |
| FP16 | 5 | ±65504(易溢出) | 10 | 中 |
| BF16 | 8 | ±3.4e38 | 7(粗) | 低 |
训练的数值动态范围大(梯度可以小到 1e-8、大到 1e4),FP16 的窄指数位动不动上溢/下溢,需要动态 loss scaling 补救;BF16 指数位与 FP32 相同,牺牲尾数精度换范围,配合 Adam 的自适应学习率完全够用。A100/H100 之后 BF16 是绝对主流。
1.5 AdamW:12 字节/参数的优化器
AdamW 每步更新(θ 为参数,g 为梯度):
m = β₁·m + (1−β₁)·g          一阶动量 (梯度的滑动平均)
v = β₂·v + (1−β₂)·g²         二阶动量 (梯度平方的滑动平均)
m̂ = m/(1−β₁ᵗ),  v̂ = v/(1−β₂ᵗ)  偏差校正 (早期步的修正)
θ ← θ − lr · m̂/(√v̂ + ε)      逐参数自适应步长
训练态显存逐项清点(这是所有并行设计的出发点):
权重 BF16            2 字节
梯度 BF16            2 字节
master 权重 FP32     4 字节   (更新必须在高精度做, 否则误差累积)
Adam 一阶动量 FP32   4 字节
Adam 二阶动量 FP32   4 字节
──────────────────────────
合计 16 字节/参数 → 7B 模型 = 112 GB, 单张 A100-80G 放不下
1.6 学习率调度
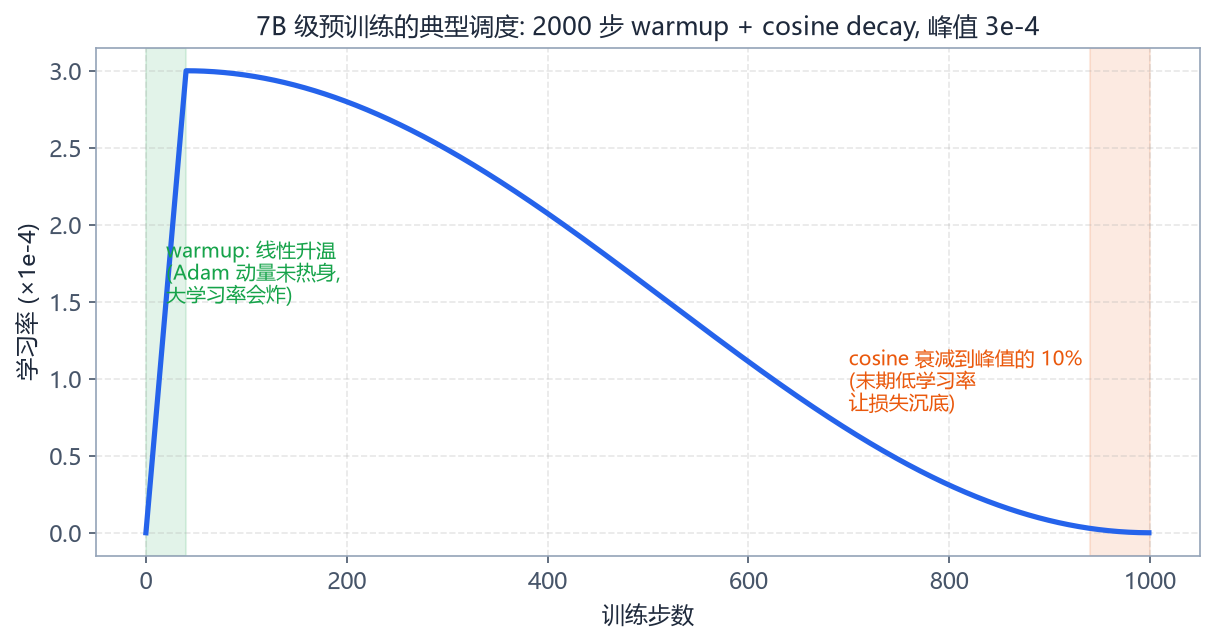
warmup 期间 Adam 的动量估计还没"热身"(偏差校正不足),大学习率直接把权重推飞——前几千步线性升温是标配;随后 cosine 衰减到峰值的 10% 左右,末期低学习率让损失沉底。7B 典型:峰值 3e-4、warmup 2000 步。梯度和学习率之外还有一道保险:梯度裁剪(全局范数 >1.0 时等比例缩回),防止个别异常 batch 摧毁训练。
1.7 并行策略:DP、ZeRO、TP、PP
朴素数据并行(DP):每卡持完整模型,各算不同 batch,梯度 all-reduce 同步。问题就在上节——每卡 112GB 放不下 7B 训练态。
ZeRO(零冗余优化器)按"切什么"分三级:
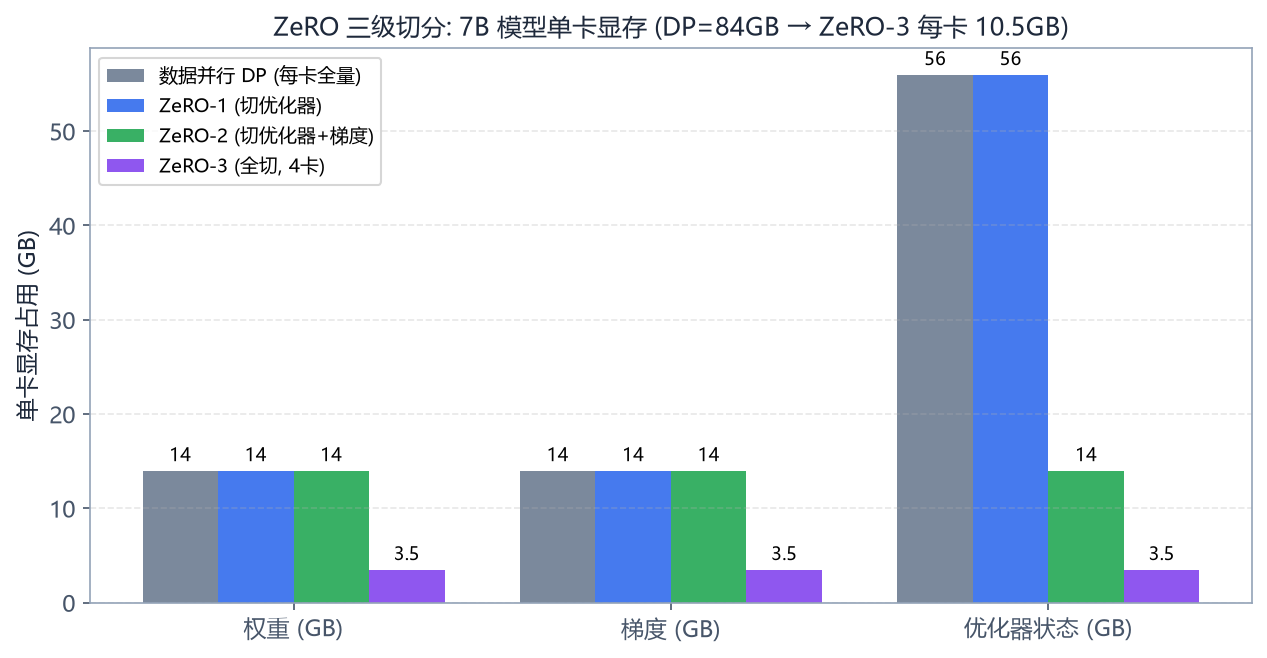
- ZeRO-1 切优化器状态(56GB → 4 卡各 14GB):每卡只负责 1/4 参数的更新,用前临时 all-gather 权重;
- ZeRO-2 再切梯度:不需要全量梯度,算完本卡负责的那部分参数的梯度就丢弃其余;
- ZeRO-3 连权重也切:极致省显存,但通信量增加 ~50%。配合 CPU offload(DeepSpeed ZeRO-Offload)甚至能在单卡 + 大内存上慢速训练大模型。
张量并行(TP):把单个矩阵乘按列/行劈到多卡——X·[W1|W2] = [X·W1 | X·W2],每卡算一半列,一次 all-reduce 汇总。通信发生在每一层每一次前向,必须走机内 NVLink,实践中 TP=8(单机 8 卡)封顶。
流水线并行(PP):把 L 层切段,各卡负责一段,微批(micro-batch)像流水线一样流过。空泡(bubble)占比 ≈ (m−1)/(m+m−1)... 精确为 (p−1)/(m+p−1)(p 段数、m 微批数),增加微批数可稀释。
3D 组合是千卡训练的标准答案:TP 锁机内 8 卡 → PP 跨机切层 → DP 最外层复制。
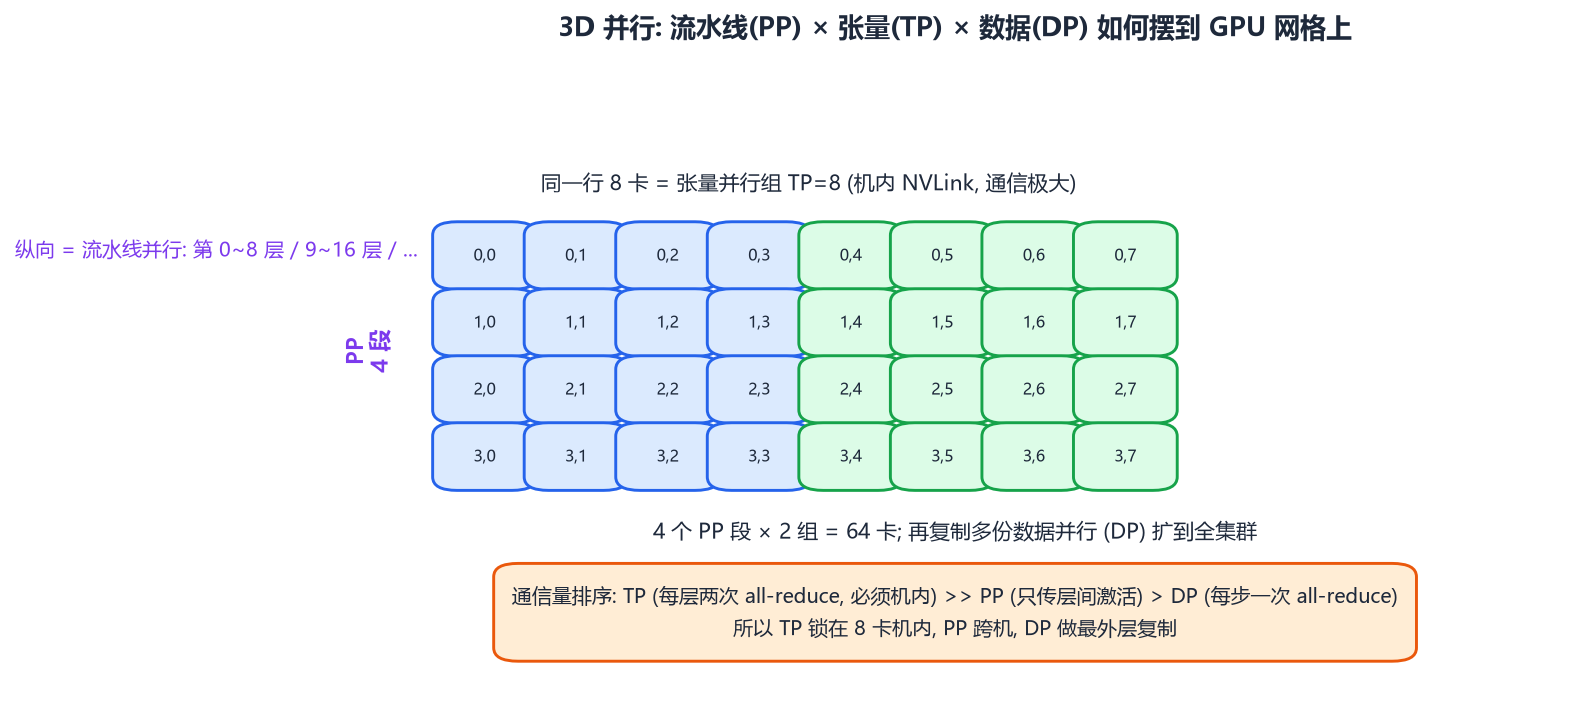
衡量效率用 MFU(Model FLOPs Utilization):实际每秒 FLOPs ÷ 硬件峰值 FLOPs。7B 级健康值 40%~55%,其余时间在通信与同步里。
1.8 Loss Spike:夜半惊魂
万亿 token 训练数周,loss 突然暴涨是最常见事故。处理剧本:回滚到最近的健康 checkpoint → 跳过疑似数据段( spike 常由脏数据触发)→ 学习率降半重跑几百步 → 恢复。GPT-4、Llama 的技术报告都记录过多次 spike。稳定压倒一切:QK-Norm、logit soft-cap、z-loss(惩罚 logits 幅度)都是为此生的补丁。
2. SFT:从续写机器到助手
2.1 Chat Template 与 Loss Masking
预训练模型见到"写一首诗"会续写"的十个理由"——它是续写器不是助手。SFT 用标注的指令-回复对教它扮演助手,关键在只对回复部分计算损失:
<|system|> 你是一个乐于助人的助手 <|endoftext|>     ← 不计损失
<|user|> 写一首关于秋天的诗 <|endoftext|>            ← 不计损失
<|assistant|> 秋风起时 <|endoftext|>                 ← 每个 token 计损失
若对全部 token 计损失,模型会分宝贵容量去学"用户怎么提问"的分布,还容易被模板 token 主导(模板 token 占比高但无信息量)。loss mask 在实现上就是一个与 logits 同长的 0/1 权重向量。
数据侧的共识:质量 >> 数量。LIMA 论文用 1000 条精标数据微调出接近 GPT-4 的对话体验;而数十万条平庸数据反而拉低上限。好的 SFT 集:难度有阶梯、回复有格式规范、拒绝/澄清等行为有覆盖。
2.2 灾难性遗忘与再混入
SFT 学新行为时会冲掉预训练能力(事实问答变差、代码能力退化)。对策:再混入(replay)——SFT 数据里掺 5%~30% 的预训练语料一起训,锚住旧分布;同时学习率压到预训练峰值的 1/10、只训 2~3 epoch。
2.3 LoRA:低秩适应的数学
全参数微调 7B 需要 112GB 优化器状态;LoRA 的假设是:微调引起的权重变化 ΔW 是低秩的——行为调整不需要动整个 4096×4096 空间,一个 r=16 的子空间就够了。
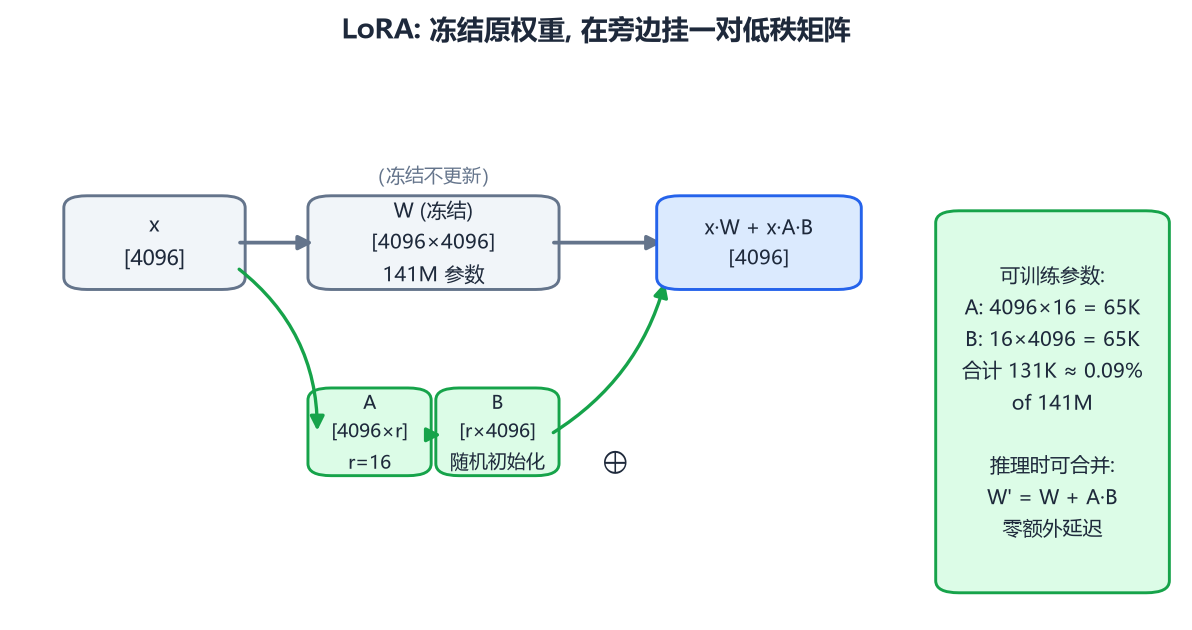
前向:  y = x·W + x·A·B        W 冻结, A∈[4096×r], B∈[r×4096]
初始化: A 高斯随机, B 全零      (起点 = 原模型, 训练稳定)
参数:  2×4096×16 = 131K ≈ W 的 0.09%
部署:  W' = W + A·B  合并后与原模型同构, 零额外推理延迟
为什么低秩有效?把微调看作在预训练权重流形上的小位移,任务迁移需要的自由度远小于参数总量("本征维度"实验:很多任务在 <1% 子空间就能达到 90% 性能)。秩 r 是超参:r=8~64 覆盖大多数场景,任务差异越大需要的 r 越高。
QLoRA 更进一步:基座量化成 4bit NF4(正态分位数量化,见量化篇)冻住,只训 LoRA 旁路——7B 微调进单张 24GB 消费卡,效果接近全参微调。
3. 对齐:RLHF 与 DPO
SFT 教会"能答",对齐教"答得好"——在多个都对的回答里挑人类偏好的那个。
3.1 偏好数据与奖励模型
标注员对同一 prompt 的多个回答排序(比打绝对分可靠得多,人对相对判断稳定)。奖励模型从排序学打分,用的是 Bradley-Terry 模型:假设人类偏好概率只依赖分差——
P(y_w ≻ y_l | x) = σ( r(x, y_w) − r(x, y_l) )
训练 RM 就是最大化标注排序的似然。RM 通常由 SFT 模型改造:把 LM head 换成标量输出头,只训这一部分。
3.2 PPO:四模型架构
RLHF 的标准实现要把四个模型同时放进显存:
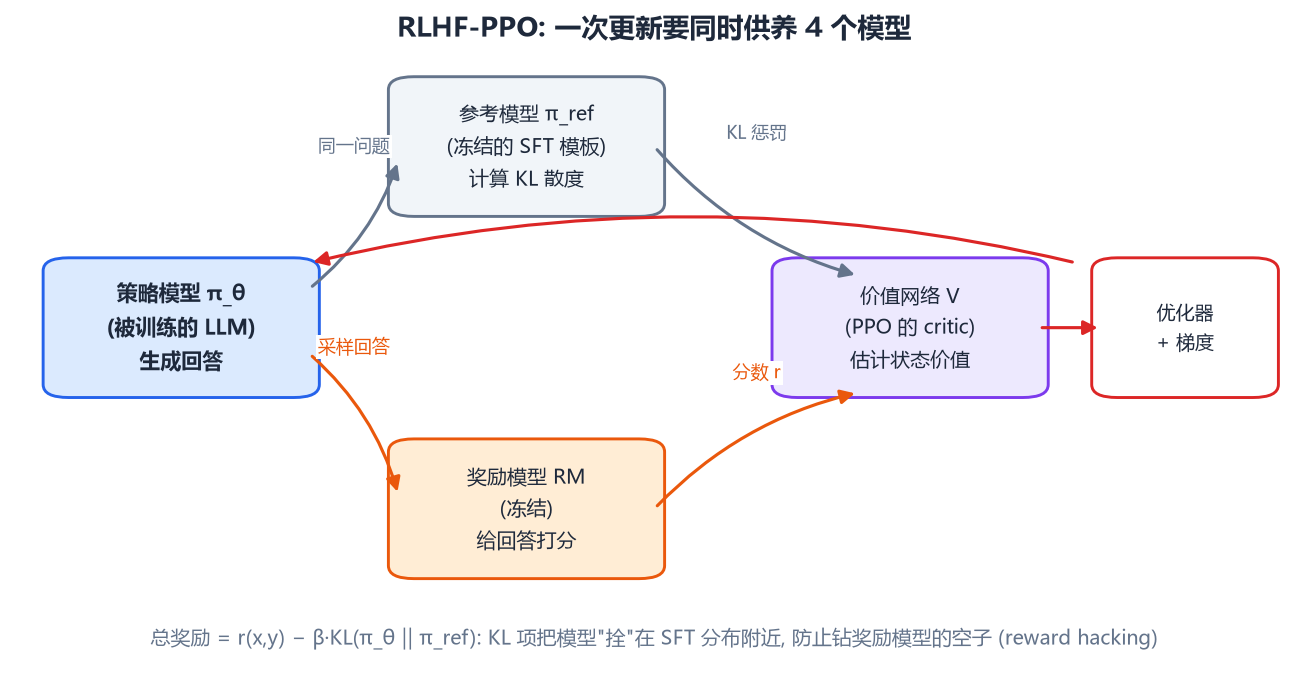
优化目标是奖励最大化 + KL 锚定:
max_θ E[ r(x, y) ] − β · KL( π_θ ‖ π_SFT )
没有 KL 项会怎样?Reward hacking:RM 是学出来的、有缺陷的打分器,策略模型会精准找到它的盲区刷分——输出冗长却空洞、堆砌列表、无脑迎合(sycophancy)。KL 项把策略拴在 SFT 分布附近,β 控制绳长。
PPO 本身来自游戏 RL:价值网络估计每步好坏、clip 机制限制单步策略更新幅度,防止 collapse。四模型 + 复杂超参(β、clip、GAE λ)让 RLHF 工程难度臭名昭著。
3.3 DPO:把 RL 变成有监督
DPO(Direct Preference Optimization)的核心观察:RLHF 的"奖励最大 + KL 约束"问题有闭式最优解,可以从最优解反解出奖励 r(x,y) = β·log(π*(y|x)/π_SFT(y|x)) + 常数。把它代回 Bradley-Terry,直接得到一个只用偏好对 (y_win, y_lose) 的损失:
L_DPO = −log σ( β · [ log(π_θ(y_w|x)/π_SFT(y_w|x)) − log(π_θ(y_l|x)/π_SFT(y_l|x)) ] )
直觉:拉近赢家的对数概率比、推远输家的,同时以 SFT 模型为锚防漂移。没有奖励模型、没有 PPO、没有价值网络——两份模型(策略 + 参考)、一个普通分类式损失。β 对应 RLHF 的 KL 强度。DPO 训练稳定性与效果与 PPO 相当,已成为开源社区默认选择。
3.4 可验证奖励:RLVR 与 GRPO
对数学/代码这类结果可自动判定的任务,奖励不必学——答案对错、测试通过与否就是完美奖励(无 hacking 空间)。DeepSeek-R1 用 GRPO(Group Relative Policy Optimization:同 prompt 采样一组回答,组内相对优势做策略梯度,省掉价值网络)大规模 RL,把推理链长度训得显著变长, reasoning 能力大幅提升。这是 2024→2025 训练范式的最大变化:对齐阶段从"学品味"扩展成"练能力"。
4. 各阶段贡献与评估
| 能力 | 主要来源 |
|---|---|
| 语言流畅、世界知识 | 预训练 |
| 指令遵循、对话格式 | SFT |
| 回答质量分寸、安全 | 偏好对齐 |
| 数学/代码硬推理 | 预训练配比 + RLVR |
评估分三层:perplexity(预训练健康度,但不能跨 tokenizer 比较)、静态 benchmark(MMLU 知识、GSM8K/MATH 数学、HumanEval 代码——注意数据污染:测试题混进训练集会让分数虚高)、人工/模型对比评(Chatbot Arena 式盲测,最接近真实体验)。
5. 小结
- 预训练 = 万亿 token 上的 next-token 交叉熵,数据管线的去重与配比是隐形护城河;16 字节/参数的训练态账本推导出 ZeRO/TP/PP 的必然性;
- SFT 用 loss masking 只学"回答",LoRA 的低秩假设把微调门槛降到消费级显卡;
- RLHF 的四模型架构 + KL 锚定对抗 reward hacking;DPO 用闭式解把对齐简化成有监督损失;
- RLVR/GRPO 把"可验证任务"变成完美奖励信号,对齐阶段开始直接练硬实力。
模型训好了,接下来是怎么把它便宜地跑起来——推理引擎篇:KV Cache、PagedAttention 与连续批处理。