
算力调度与推理集群:K8s、NPU 切分与弹性部署
前两篇解决了"单机软件栈"与"集群互联",但真实的数据中心还有一层运营问题:几十个团队、几百张卡、训练与推理混跑、白天与夜间负载差 10 倍——谁先用、用多少、出了问题谁管。这篇讲 AI 算力的"操作系统":K8s 如何接入 NPU(Device Plugin)、算力切分(vNPU 动态虚拟化)、训练作业的成组调度(Volcano)、推理服务的弹性伸缩,以及三层可观测体系。这是 AI Infra 系列的收官篇。
1. 为什么 AI 算力需要专门的调度层
裸机直用(SSH 上去跑脚本)在小规模下没问题,超过一个机柜就出现经典四问:
- 碎片化:8 卡机器被切给三个团队各 2~3 张,剩下的卡谁也用不了;
- 利用率:推理服务白天满载夜间闲置、训练任务排队等卡,两者互不知道;
- 隔离:一个实验把驱动搞挂,整节点所有任务陪葬;
- 审计:谁的作业占了多少卡小时、花了多少钱,没有账本。
答案与云计算十年前的答案相同:容器化 + 调度器。差异在于 AI 负载有三个特殊点:设备重(NPU/GPU 直通与拓扑)、成组性(训练作业要整组起)、冷启动重(加载模型权重以分钟计)。
2. K8s 接入 NPU:Device Plugin 机制
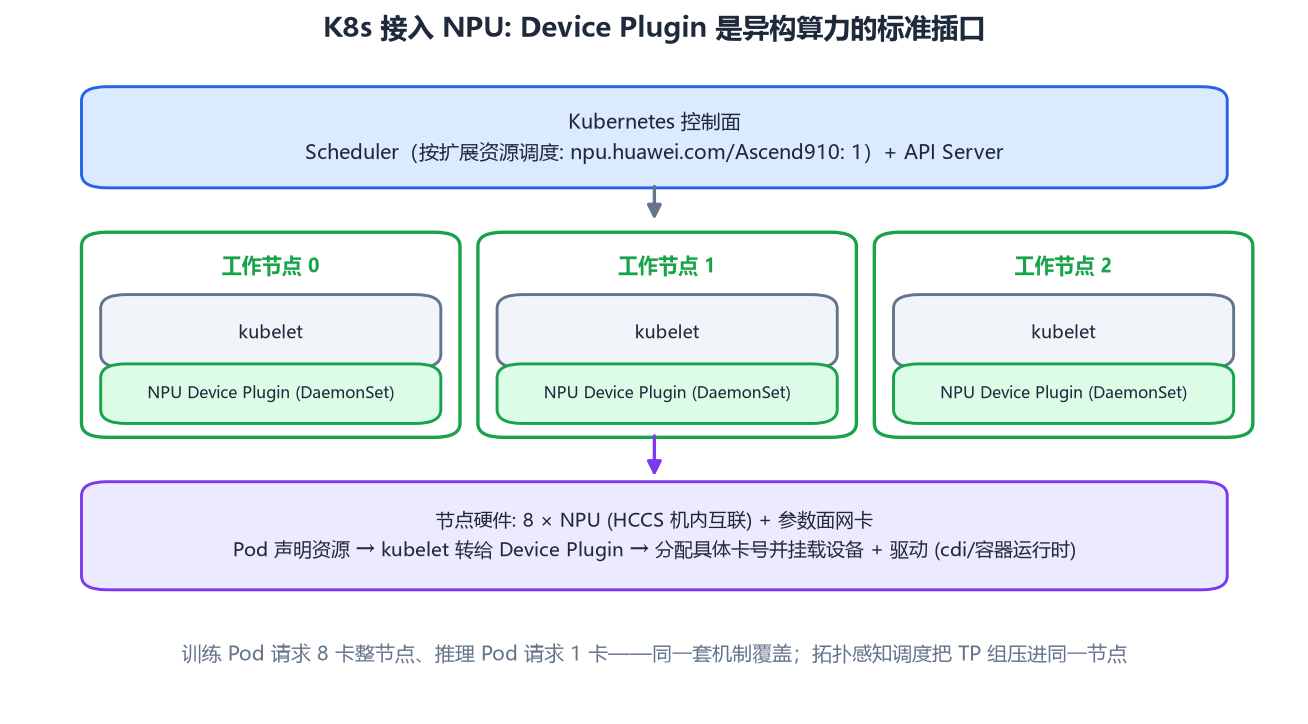
Kubernetes 本体只认识 CPU/内存,异构算力通过 Device Plugin 框架插入,机制四步:
- 插件以 DaemonSet 跑在每个节点上,向 kubelet 注册扩展资源(如
npu.huawei.com/Ascend910,容量 8); - Pod 的资源声明里写这个扩展资源("我要 8 张 NPU"),Scheduler 按总账调度到合适的节点;
- kubelet 请求插件分配具体设备——插件决定给你哪几张卡(这一步可以做拓扑对齐:让同一 TP 组的卡在同一 HCCS/NVLink 域内);
- 容器运行时把设备文件与驱动挂进容器(CDI 机制),Pod 内进程看到的就是
/dev/davinci0..7。
对用户的直接意义:Pod YAML 里一行 resources 声明,就把"哪台机器哪张卡"的问题交给调度器;而 NPU 厂商的 K8s 插件(昇腾的 volccano 生态组件、NVIDIA 的 k8s-device-plugin)本质都是在实现这套插口。训练 Pod 要整卡整节点,推理 Pod 可以只要 1 张卡或 1/4 张——同一套机制覆盖。
3. 算力切分:一张 NPU 当多张用
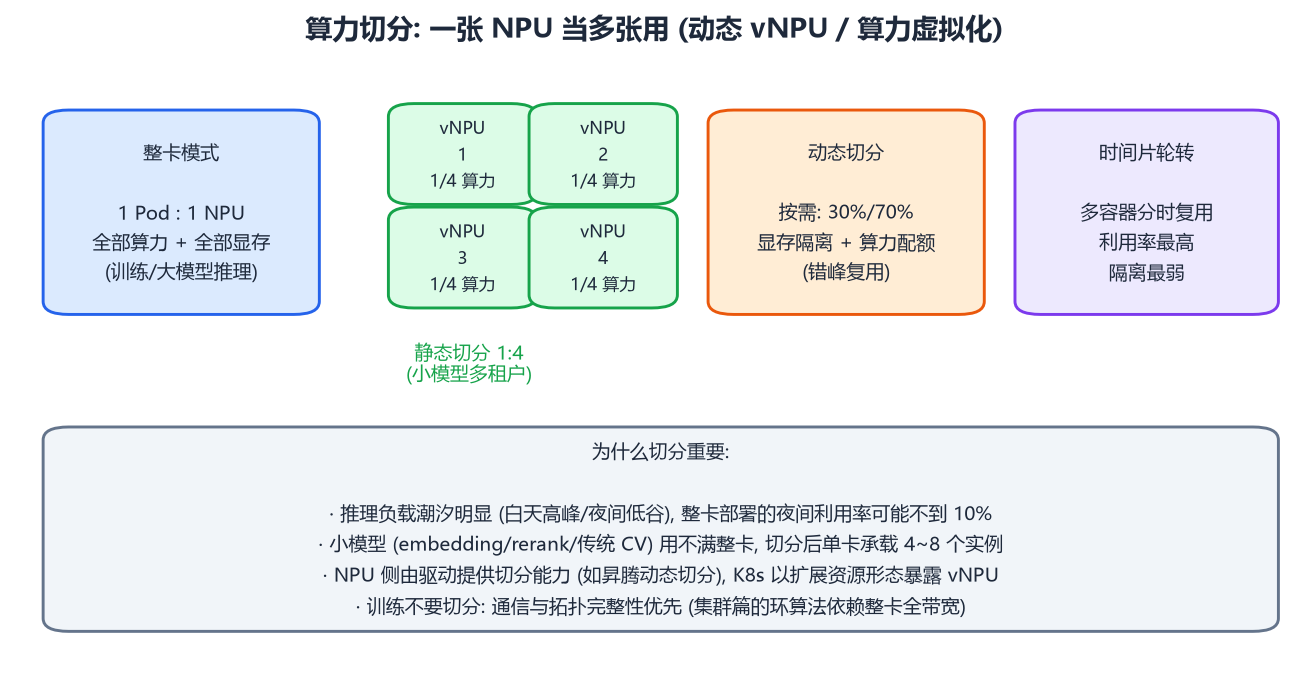
推理场景的矛盾:小模型(embedding、rerank、传统 CV)用不满一整张数百 TFLOPS 的卡,但租户又需要独占的显存与 QoS。三种切分粒度:
- 静态切分(1:2 / 1:4):驱动把一张物理卡注册成多个 vNPU,各自有独立的显存配额与算力份额,K8s 侧表现为更多的"卡"。隔离强、灵活性差;
- 动态切分:按比例(如 30%/70%)在线调整配额,配合潮汐负载错峰复用——白天推理多切给在线、夜间切给离线评估;
- 时间片轮转:多容器分时复用整卡。利用率最高、隔离最弱(一个邻居的尖峰延迟会传导给你),只适合不在乎尾延迟的批处理。
边界也很清楚:训练不要切分。切分破坏了卡间全带宽(集群篇的环算法依赖它),TP 组被切开等于自废武功。切分是推理与多租户场景的工具。
4. 训练作业调度:成组起、成组死
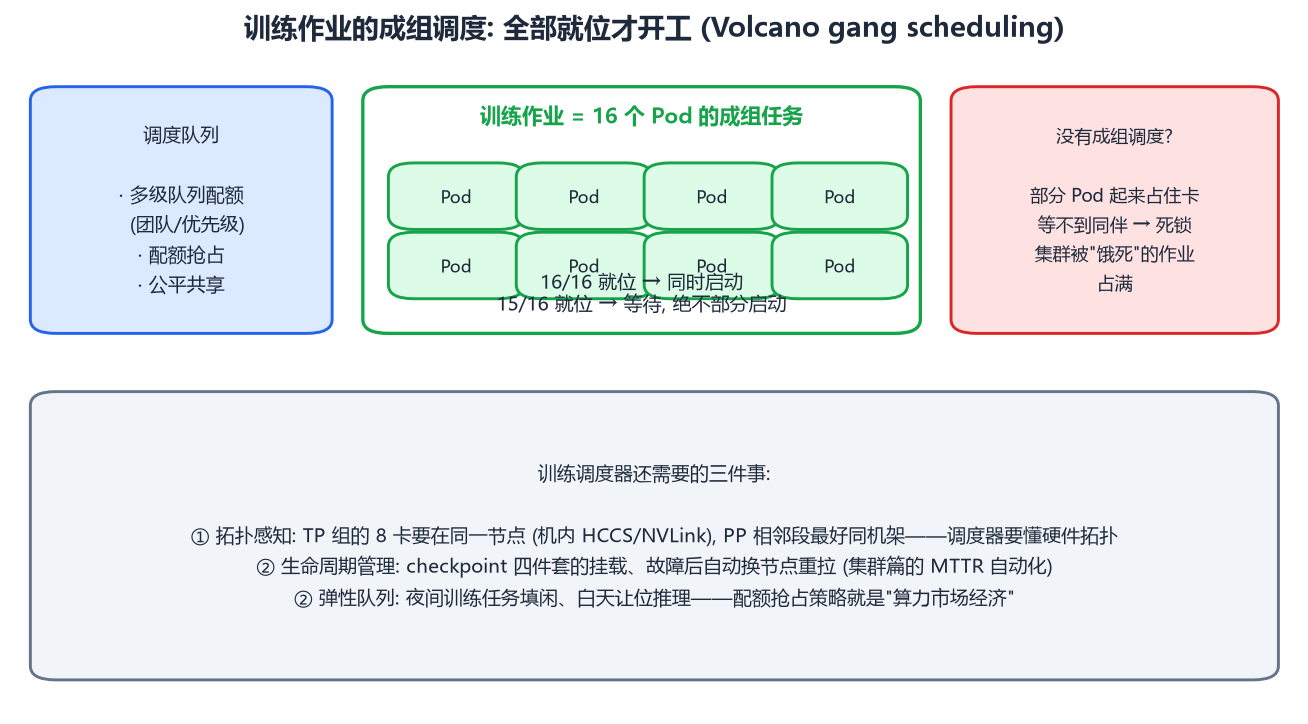
一个 16 节点的训练作业提交后,如果默认调度器"有多少资源起多少 Pod",会发生经典死锁:起了 15 个 Pod 各占一节点,第 16 个怎么也排不上(被别的作业占了),15 个 Pod 干占着卡等同伴,集群吞吐归零。
解法是成组调度(gang scheduling):作业的所有 Pod 作为一个整体,凑齐才启动、起不来就全不启动(排队等待)。Volcano(及 k8s 原生演进出的 coscheduling)在此之上补齐训练场景的另外三块:
- 多级队列与配额:按团队/优先级分配配额,支持抢占(高优作业可以"买断"低优作业的资源,低优作业回到队列);
- 拓扑感知调度:把 TP 组压进同一节点、PP 相邻段放进同机架——调度器必须"懂"上一章的网络拓扑,否则给你 8 张横跨三台机器的"TP 组",每层 all-reduce 都在跨机链路上爬;
- 作业生命周期:故障节点自动换机重拉(集群篇 MTTR 自动化的落地)、checkpoint 卷的挂载继承。
一句话:通用 K8s 把容器放到节点上,AI 调度器把"一个作业的拓扑"放到"一个集群的拓扑"上。
5. 推理集群:弹性与多模型共存
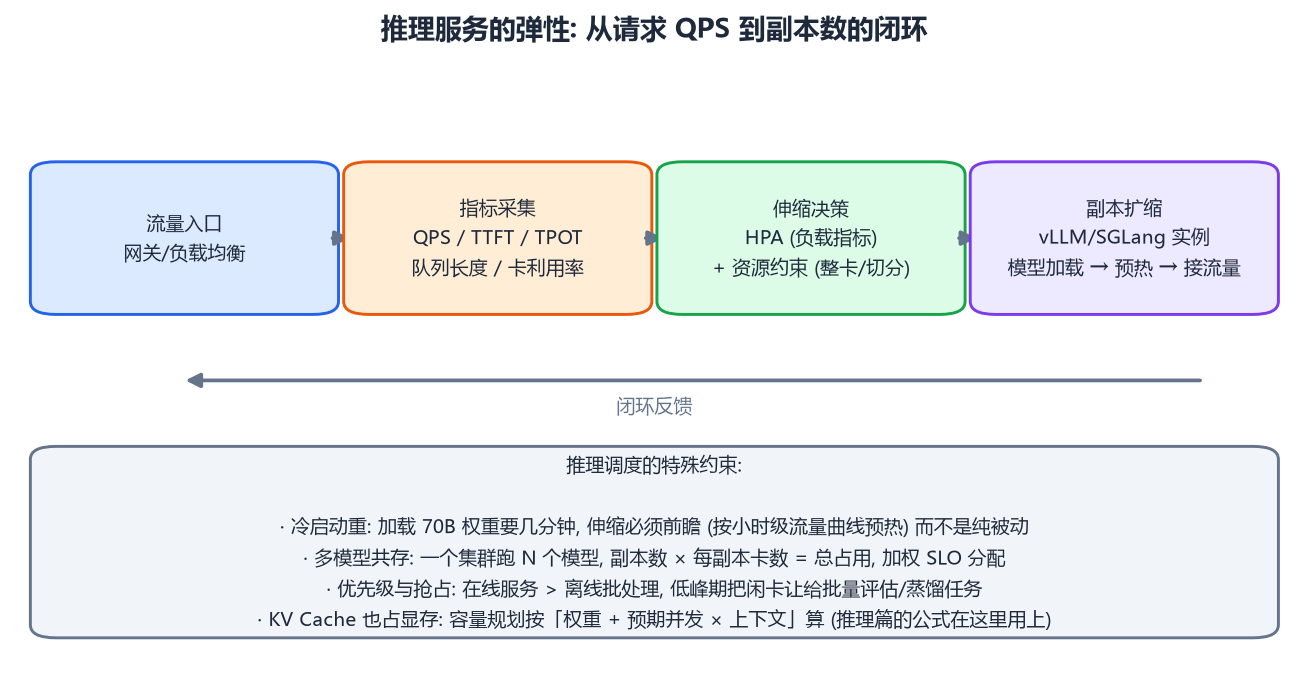
推理侧的调度目标是 SLO(TTFT/TPOT 分位值)下的成本最小化。标准闭环:流量入口 → 指标采集(QPS、队列深度、卡利用率)→ 伸缩决策(HPA 按自定义指标)→ 副本扩缩(新起 vLLM/SGLang 实例 → 加载权重 → 预热 → 接流量)。
AI 推理区别于普通微服务的三个现实:
- 冷启动以分钟计:加载 70B 权重 + 图编译(CANN 篇的预热)。伸缩必须前瞻——按小时级流量曲线提前扩,而不是等 P99 报警再扩;
- 容量 = 权重 + KV Cache:容量规划要用推理篇的公式(并发 × 上下文 × 每 token 缓存量),而不是"每实例 X QPS"这种拍脑袋数;
- 多模型加权:一个集群跑 N 个模型,副本数 × 每副本卡数的总盘子在 SLO 约束下分配;低峰期把闲卡让给离线批量(评估、蒸馏语料生成),白天抢占回来——配额与抢占策略就是集群内部的"算力市场"。
6. 可观测:三层指标各回答一个问题
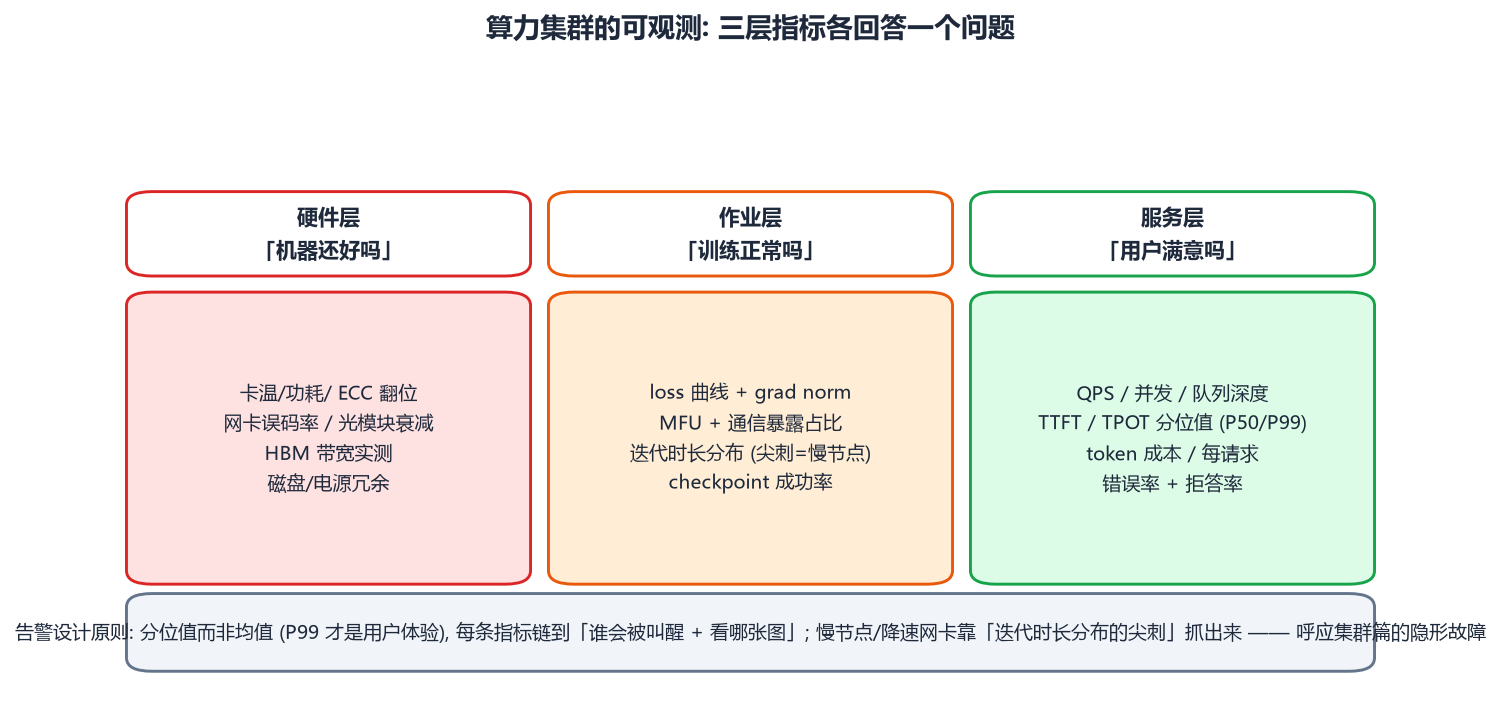
- 硬件层(机器还好吗):卡温/功耗/ECC 翻位计数、网卡误码率、光模块衰减、HBM 带宽实测——集群篇那些"隐形故障"(降速网卡)就靠这层数据 + 迭代时长分布的尖刺抓出来;
- 作业层(训练正常吗):loss 曲线与 grad norm(spike 预警)、MFU 与通信暴露占比、迭代时长分布、checkpoint 成功率;
- 服务层(用户满意吗):QPS、队列深度、TTFT/TPOT 的 P50/P99、每请求 token 成本、错误率与拒答率。
告警设计两条铁律:看分位不看均值(P99 才是用户体验,均值是自我安慰);每条告警都能回答"谁被叫醒、看哪张图、执行什么动作"——否则就是噪音制造机。
7. 一个最小参考架构
把四篇 Infra 拼成一个可落地的参考栈(自建或评估云上方案都适用):
【硬件】  8 卡 NPU 节点 (HCCS 机内) × N + spine-leaf 200G 参数面 + 对象存储
【系统】  K8s + NPU device plugin + Volcano (队列/成组/拓扑) + 监控栈
【训练】  PyTorch + torch_npu + HCCL + DeepSpeed/Megatron + 弹性恢复
【推理】  vLLM/SGLang 类引擎 + 图模式预热 + 前缀缓存 + 切分多租户
【运营】  配额账本 (卡小时/团队) + 三层可观测 + 前瞻伸缩
评估任何"智算平台"方案时,就按这五层对号入座:每层都有明确的技术点与替代品,缺哪层、哪层是自研哪层是开源,一目了然。
8. 小结
- Device Plugin 是异构算力进 K8s 的标准插口:扩展资源声明 → 插件分配具体卡 → 设备挂载进容器;
- 切分(静态 vNPU/动态配额/时间片)服务推理与多租户,训练坚持整卡整拓扑;
- 训练调度三件套:gang scheduling(凑齐才起)、队列配额与抢占、拓扑感知放置;
- 推理伸缩要前瞻(冷启动分钟级),容量规划 = 权重 + KV Cache,多模型在 SLO 下加权共存;
- 可观测分硬件/作业/服务三层,分位值优先,每条告警绑定责任人与动作。
至此 AI Infra 四部曲(硬件 → 软件栈 → 集群 → 调度运营)完结,加上前七篇的模型层(分词器 → 架构 → 训练 → 推理 → 量化 → RAG → Agent),这个系列从晶体管到应用层的完整地图就画完了。祝构建愉快。