
NPU 编程栈拆解:以昇腾 CANN 为例,对照 CUDA 生态
硬件篇结尾留了个钩子:NPU 用专用性换能效,代价是生态。这篇就讲补齐生态的软件层——以昇腾 CANN(Compute Architecture for Neural Networks)为例,把 NPU 编程栈逐层拆开,并与 CUDA 生态逐条对照:从 torch_npu 适配层、图引擎 GE、TBE 算子开发,到 AscendCL 运行时五要素与 HCCL 集合通信,最后给一份 CUDA→NPU 的迁移工程清单。读完你应该能回答:在 NPU 上写一行 model.to('npu') 之后,代码究竟经历了什么。
1. 异构编程栈的通用骨架
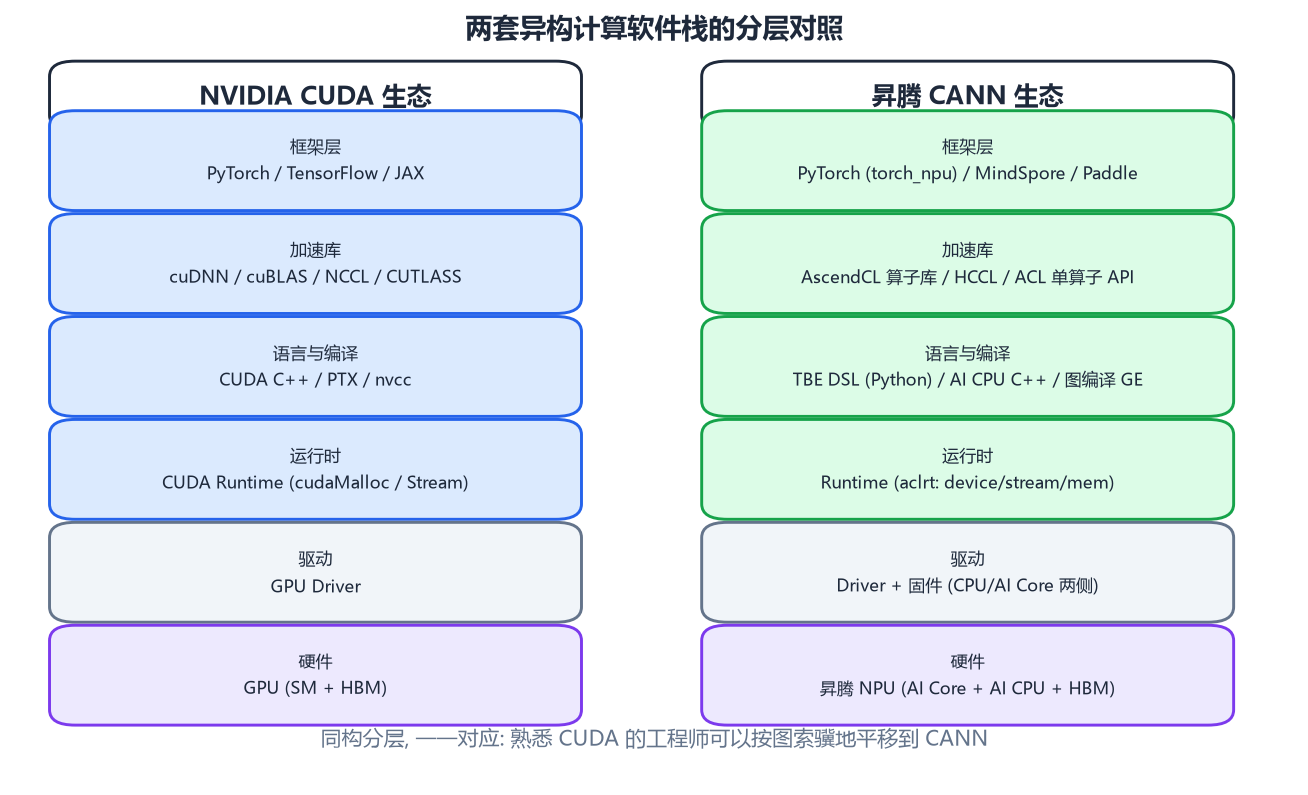
任何 CPU+XPU 的异构计算栈都长成同一个形状,自上而下:
框架层     PyTorch / MindSpore / TensorFlow     写模型的人
加速库     算子库 + 集合通信库                   调性能的人
编译层     图优化 + kernel 编译 (tiling)          做优化的人
运行时     device/stream/memory 管理             每个人都在用
驱动+硬件  真正干活的芯片
CUDA 生态的每一层(cuDNN/cuBLAS/NCCL、nvcc/PTX、CUDA Runtime)在 CANN 里都有对应物(ACL 算子库/HCCL、TBE/GE、aclrt)。分层对照着学,第二套异构栈的成本远比想象中低——这也是本篇的组织方式。
2. 一行 model.to('npu') 的完整旅程
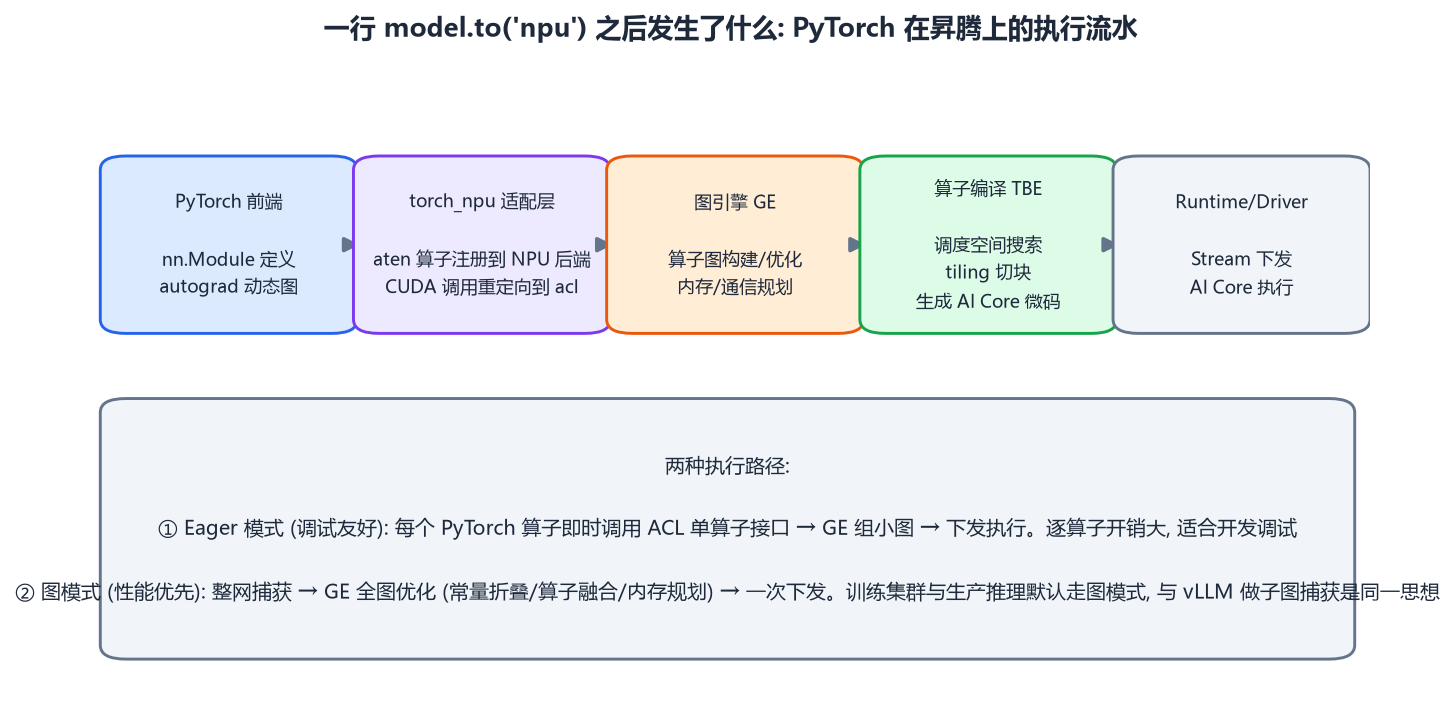
PyTorch 用户几乎不需要改模型代码,秘密在适配层:
- torch_npu 插件把 PyTorch 的 aten 算子注册一份"NPU 后端实现"——
torch.add的分发目标从 CUDA kernel 换成 ACL 算子调用,模型代码零感知; - 图引擎 GE(Graph Engine)把算子流组织成计算图,做常量折叠、算子融合、内存与通信规划;
- 算子编译 TBE(Tensor Boost Engine)为每个算子生成 AI Core 上真正跑的微码——核心工作是 tiling:把逻辑上的大张量按 L0A/L0B/L0C、Unified Buffer 的物理容量切块,编排"搬运-计算-写出"的流水(硬件篇的存储金字塔在这里落地);
- Runtime(aclrt)与驱动把编译产物放进 stream 队列,驱动 32 个 AI Core 执行。
两条执行路径要分清:
- Eager 模式:每个算子即时编译即时执行,逐算子开销大——开发调试用;
- 图模式:整网捕获、全图优化、一次下发——生产训练/推理用。这与 GPU 侧
torch.compile、vLLM 子图捕获是同一个思想:把 Python 的动态性挡在编译期之外。
3. AscendCL:运行时编程五要素
写原生 NPU 程序(类似写 CUDA C++)时面对的是 AscendCL 接口层,五个概念撑起全部骨架:
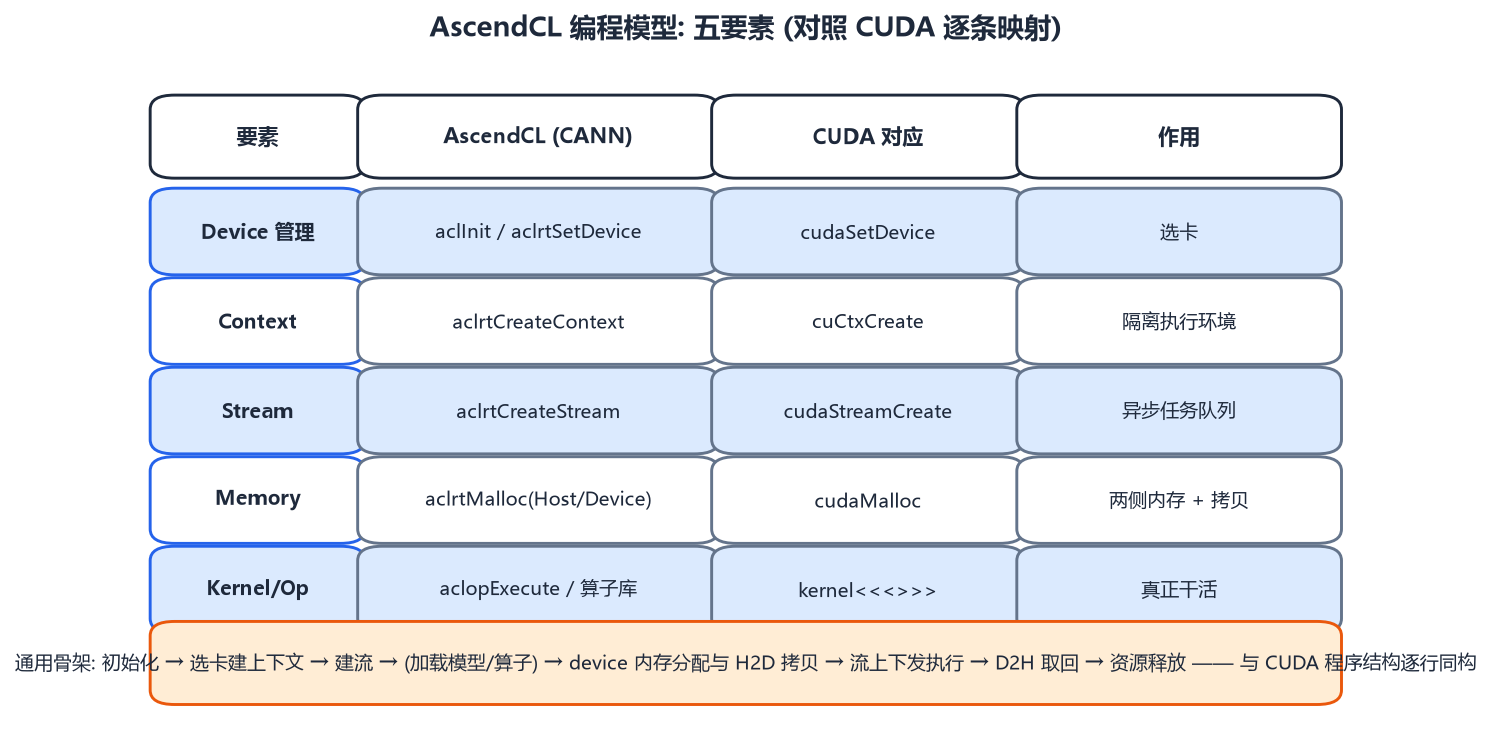
| 要素 | AscendCL | CUDA 对应 | 作用 |
|---|---|---|---|
| Device | aclrtSetDevice |
cudaSetDevice | 选卡 |
| Context | aclrtCreateContext |
cuCtxCreate | 隔离执行环境 |
| Stream | aclrtCreateStream |
cudaStreamCreate | 异步任务队列 |
| Memory | aclrtMalloc(Host/Device) |
cudaMalloc | 两侧内存与 H2D/D2H 拷贝 |
| Op 执行 | aclopExecute / 模型 API |
kernel<<<grid,block,stream>>> |
下发计算 |
一个最小骨架(结构上与 CUDA 程序逐行同构):
import acl

# 初始化 → 选卡 → 上下文 → 流
acl.init()
device_id = 0
acl.rt.set_device(device_id)
context, _ = acl.rt.create_context(device_id)
stream, _ = acl.rt.create_stream()

# device 内存 + H2D 拷贝 (对照 cudaMalloc / cudaMemcpy)
w_dev, _ = acl.rt.malloc(16 * 1024 * 1024)
w_host, _ = acl.rt.malloc_host(...)          # 或 numpy 池化内存
acl.rt.memcpy(w_dev, ..., w_host, ...,
              kind=acl.rt.MEMCPY_HOST_TO_DEVICE)

# 下发算子 (对照 kernel<<<...>>>)
acl.op.execute(op_handle, inputs, outputs, stream)
acl.rt.synchronize_stream(stream)            # 对照 cudaStreamSynchronize

# 资源释放 (顺序与创建相反)
acl.rt.destroy_stream(stream)
acl.rt.destroy_context(context)
acl.rt.reset_device(device_id)
acl.finalize()
两处与 CUDA 微妙的差异值得注意:Host 侧内存要经 aclrt 分配(走 DMA 直达通道,比普通 malloc 拷贝快);以及 NPU 上"算子"比"kernel"更上层——单算子执行内部还带着格式推导与小图优化,这为图模式做了铺垫。
4. 算子开发:TBE 与"搬运即编程"
需要在 NPU 上写一个新算子(没有现成实现时),TBE 的开发模型最能体现达芬奇架构的特点:
# TBE DSL 形态 (示意): 用 Python 描述一个向量加算子
import tbe.dsl as tbe

def add_compute(x, y, shape, dtype):
    return tbe.vadd(x, y)              # Vector 单元的向量加

def add_schedule(out, shape):          # 调度: 决定 tiling 与流水
    ...                                # 按 UB/L1 容量切块, 编排 MTE 双缓冲
- compute(算什么):
vadd/vmul这类原语映射到 Vector 单元,矩阵乘走 Cube 的matmul原语; - schedule(怎么搬怎么切):这部分才是 NPU 算子开发的主体——把数据流按硬件篇的 L0/L1/UB 金字塔编排,让 Cube 计算时 MTE 在预取下一块。调优一个 GEMM 算子,九成时间花在 tiling 与流水排布上;
- 纯 Python 描述 + 编译期生成微码,迭代速度比写 PTX 友好;调度空间大时配合 auto-tune 搜索。
这套"显式数据流编程"是 NPU 与 GPU 生态最大的心智差异:CUDA 程序员优化的是线程块与共享内存的映射,TBE 程序员优化的是搬运与计算的流水重叠——对象不同,目标一致:喂饱专用计算单元。
5. 图编译与算子融合
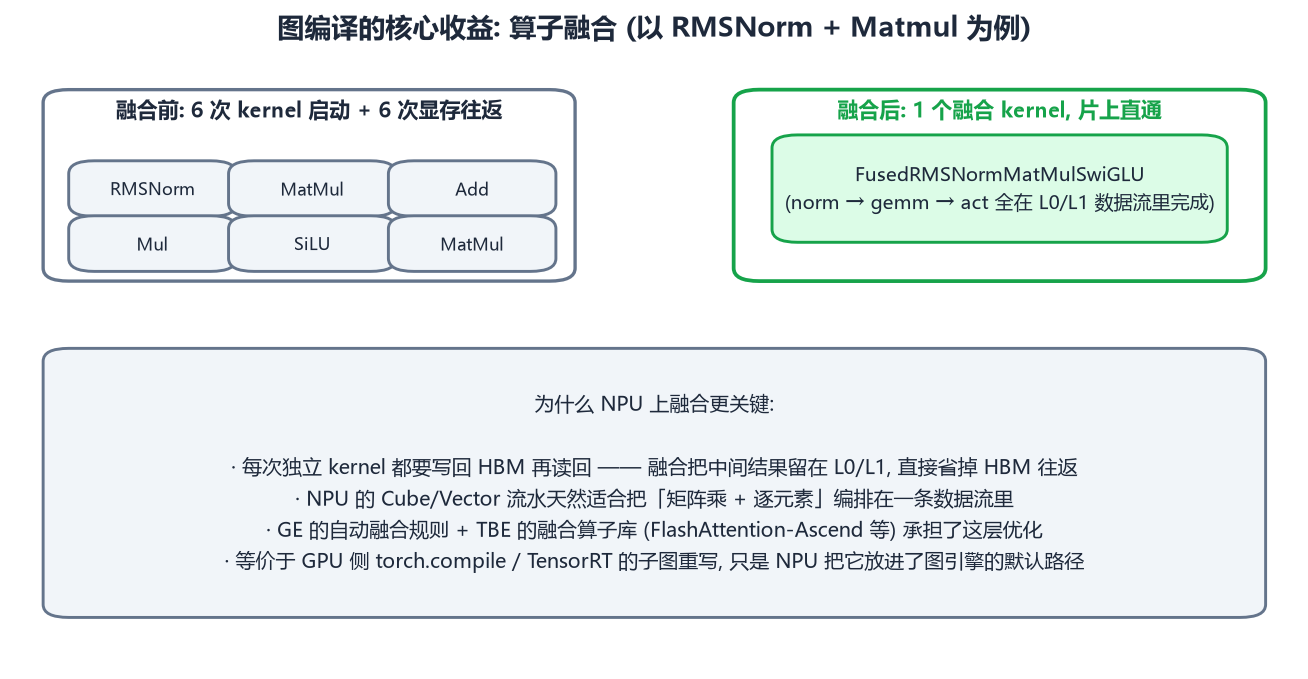
GE 图引擎的核心价值是算子融合:RMSNorm→MatMul→SiLU→Mul 这些小算子如果各自独立执行,每个都要写回 HBM 再读回;融合成一个 kernel 后中间结果留在 L0/L1 片上直通——对 decode 这种带宽受限负载(推理篇),融合直接决定吞吐。NPU 上这层优化比 GPU 更关键:达芬奇的显式存储层次天生适合把"矩阵乘+逐元素"编排在一条数据流里,FlashAttention 的 Ascend 版本就是把 softmax 的在线更新整个塞进 Cube/Vector 流水。
对框架用户的直接建议:生产路径尽量走图模式并预热——动态 shape 每出现一个新形状都可能触发一次图编译,用 shape 分桶 + warmup 把编译成本挡在服务前。
6. HCCL:集合通信的 NPU 侧实现
多卡程序里 NCCL 的对应物是 HCCL(Huawei Collective Communication Library):all-reduce/all-gather/reduce-scatter/broadcast 的 API 形态与 NCCL 基本对齐,底层走 HCCS(机内)与 RoCE 参数面(跨机)。迁移多卡训练时的实践要点:
- 通信组创建(
init_process_group走 hccl backend)与 NCCL 用法一致,PyTorch 代码通常只改 backend 与 device; - 回归测试重点:超大消息的 all-reduce 分档、梯度桶大小与通信-计算重叠是否生效(NPU 上的 bucket 合并策略可能与 NCCL 调参不同);
- 集群篇会展开算法层(ring 等),那一层与硬件无关,两套栈共用同一套数学。
7. CUDA → NPU 迁移清单
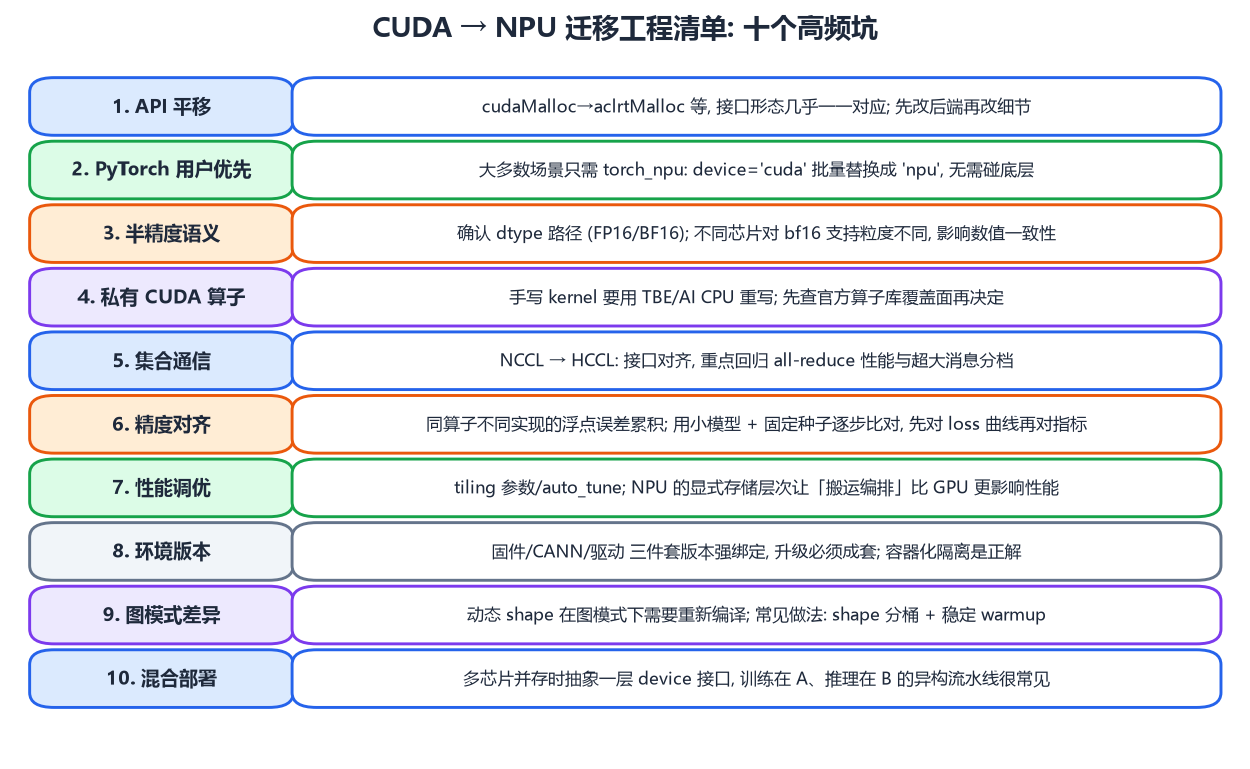
把清单里的高频项展开成判断题:
- 你只是用 PyTorch 训练/推理?→
pip install torch_npu,device 字符串'cuda'→'npu',大概率当天跑通;精度对齐做一轮(小模型、固定种子、比 loss 曲线再比指标); - 你有自定义 CUDA kernel?→ 成本大头。先查官方算子库与 TBE 融合算子覆盖面,覆盖不到的用 TBE/AI CPU 重写——这一步的工作量按算子数量线性计;
- 你在做性能敏感的服务?→ 图模式 + auto-tune + tiling 调优,重点盯"搬运编排";profile 工具看 AI Core 利用率与 MTE 空闲期,而不是只看 FLOPS;
- 运维环境?→ 固件/驱动/CANN 版本强绑定,升级必须成套验证;用容器(镜像内置匹配版本)隔离,这是多团队协作的救命绳。
8. 生态视角:如何客观看待两套栈
CUDA 的护城河不在某一项技术,而在十五年积累的算子覆盖、文档、Stack Overflow 答案与人才市场。CANN 的追赶策略清晰:兼容 PyTorch 主路径(torch_npu)、对齐 NCCL 形态(HCCL)、图模式吃性能、算子库补高频缺口。现实结论:
- 标准 workload(主流 LLM 训练/推理)上,NPU 路径已可用,瓶颈在长尾算子与调优经验;
- 越非标的负载,迁移成本越接近"重写";
- 对工程师个人:第二套异构栈的边际学习成本很低(骨架同构),而"懂两套栈"在当前环境里是稀缺能力。
9. 小结
- 异构栈分层同构:框架→加速库→编译→运行时→驱动,CANN 与 CUDA 可逐层对照学习;
model.to('npu')背后:torch_npu 算子注册 → GE 图优化 → TBE tiling 编译 → aclrt 下发,eager 调试、图模式上生产;- AscendCL 五要素(device/context/stream/memory/op)与 CUDA 逐条映射,注意 Host 侧 DMA 内存与"算子比 kernel 更上层"两个差异;
- NPU 算子开发的主体是 schedule:把数据流编排进 L0/L1 存储层次,让计算与搬运流水重叠;
- 算子融合是图引擎的核心收益,也是 NPU 存储层次的天然优势;迁移成本集中在自定义 kernel 与精度/性能双对齐。
单机讲完了,几百张卡怎么连成一台"计算机"——下一篇:训练集群的互联网络与集合通信。