
LLM 的底层基石:Tokenizer 与 BPE 分词算法的设计与实现
当我们向 ChatGPT 输入一句话时,模型看到的不是文字,而是一串整数 ID;API 按量计费的"量"、上下文窗口的"窗口"、甚至模型会不会做算术,全都由这串 ID 的组织方式决定。把文本切分成最小处理单元并映射到 ID 的组件,就是 Tokenizer(分词器)——大模型技术栈的最底层。这篇文章从表示论困境讲起,完整推导 BPE 算法(含手推例子与可直接运行的实现),再到 GPT-2 的 Byte-level 方案、SentencePiece 的 Unigram 替代路线、ChatML 模板与词表工程账本,把这一层彻底讲透。
1. 为什么"怎么切"是个根本问题
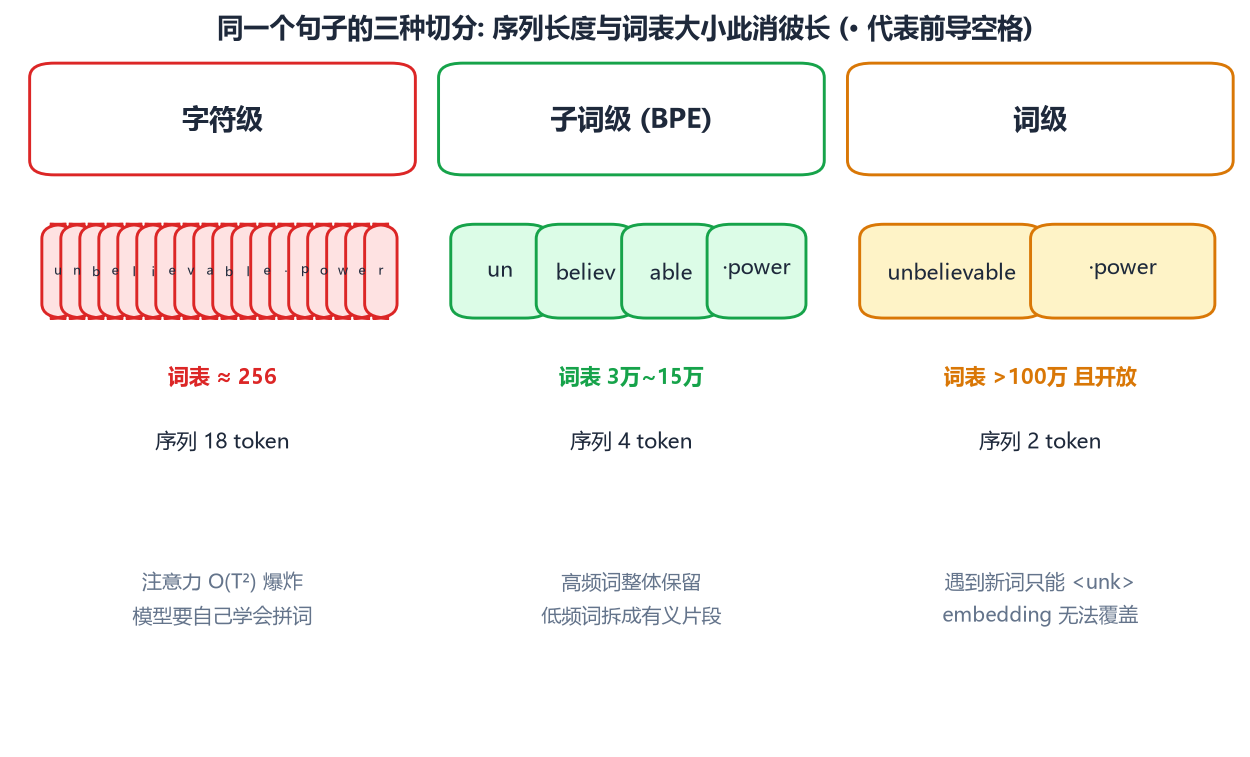
分词器决定了三件事,每一件都直达成本与能力:
- 序列长度。Self-Attention 的计算量是 O(T²)、KV Cache 与序列长度成正比。同样一句话切出 18 个 token 还是 4 个 token,推理成本差 4 倍以上;
- 词表大小。词表直接决定 embedding 矩阵的行数:一个 128K 词表、4096 维的模型,输入输出两份 embedding 合计约 10.5 亿参数;
- 学习效率。切分粒度决定了模型要花多少容量去"记住字符组合"。把
unbelievable拆成 12 个字符,模型必须用宝贵的参数去学"u-n-b-e-l-i-e-v-a-b-l-e 经常一起出现";而把它作为一个 token,这部分统计就固化在了词表里。
1.1 两个失败方案
字符级(hello → h,e,l,l,o):词表极小(英文 26 字母 + 标点),永远不会 OOV,但一个英文单词 2~6 个 token、一个汉字 1~3 个字节。更糟的是组合爆炸:语言的有效单元是词而非字符,字符序列里"下一个字符"的分布高度多义,模型被迫先学会拼词再学会语义,10 层 Transformer 里可能有 3 层在干拼词的活。
词级(hello world → hello,world):序列最短,但词表是开放集合——新词、专有名词、错别字、变体(e-mail/email)层出不穷。给 100 万词表也总会有没见过的,只能映射成 <unk>,信息直接丢失;而且 100 万行的 embedding 在 softmax 输出层上每步都要算 100 万次点积。
1.2 Zipf 定律给了出路
自然语言的词频分布高度倾斜:极少数词覆盖了大部分语料,极大量的词各自只出现几次。f(r) ∝ 1/r^s(r 为词频排名,s≈1)。这提示了一个聪明的折中:高频词整体保留,长尾词拆成片段——高频词数量少,全收进词表不占多少行;长尾词虽然多,但它们的片段(词根、词缀、常用汉字)复用率极高。
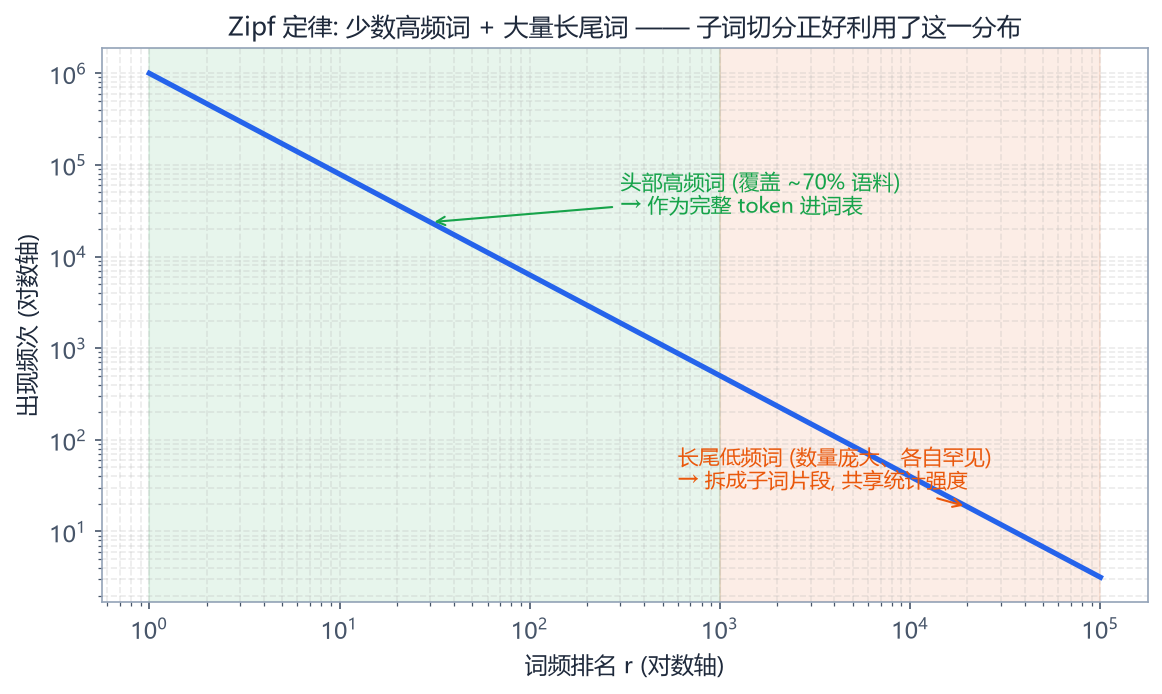
这就是子词切分(Subword Tokenization):它不是在"字符"和"词"之间选边,而是让数据自己决定每个词该被切到多细。unbelievable → un + believ + able,三个片段在其他词里也大量出现,统计强度得以共享,而任何没见过的新词都能被表示成已有片段的序列——OOV 问题从根上消失。
2. BPE:算法完整推导
BPE(Byte Pair Encoding)1994 年作为压缩算法提出,2016 年 Sennrich 等人引入 NLP,GPT 系列沿用至今。它的表述出人意料地简单:
从字符序列出发,每轮把整个语料中出现频率最高的相邻符号对合并成一个新符号,重复直到词表达到目标大小。
2.1 为什么"频率最高"是合理的贪心策略
回到 BPE 的压缩本源:语料被表示成符号串,合并一对 (a,b)→ab 意味着语料中每个出现处少一个符号。若该对出现 f 次,则总符号数减少 f。每轮选频率最高的对,就是在"新增 1 个词表项"的固定成本下,最大化当前语料长度的削减量——这是对"词表大小 vs 语料长度"这条权衡曲线的贪心逼近。虽然不保证全局最优(字典构造是 NP 难问题),但它简单、确定、单调有效。
2.2 手推一个完整例子
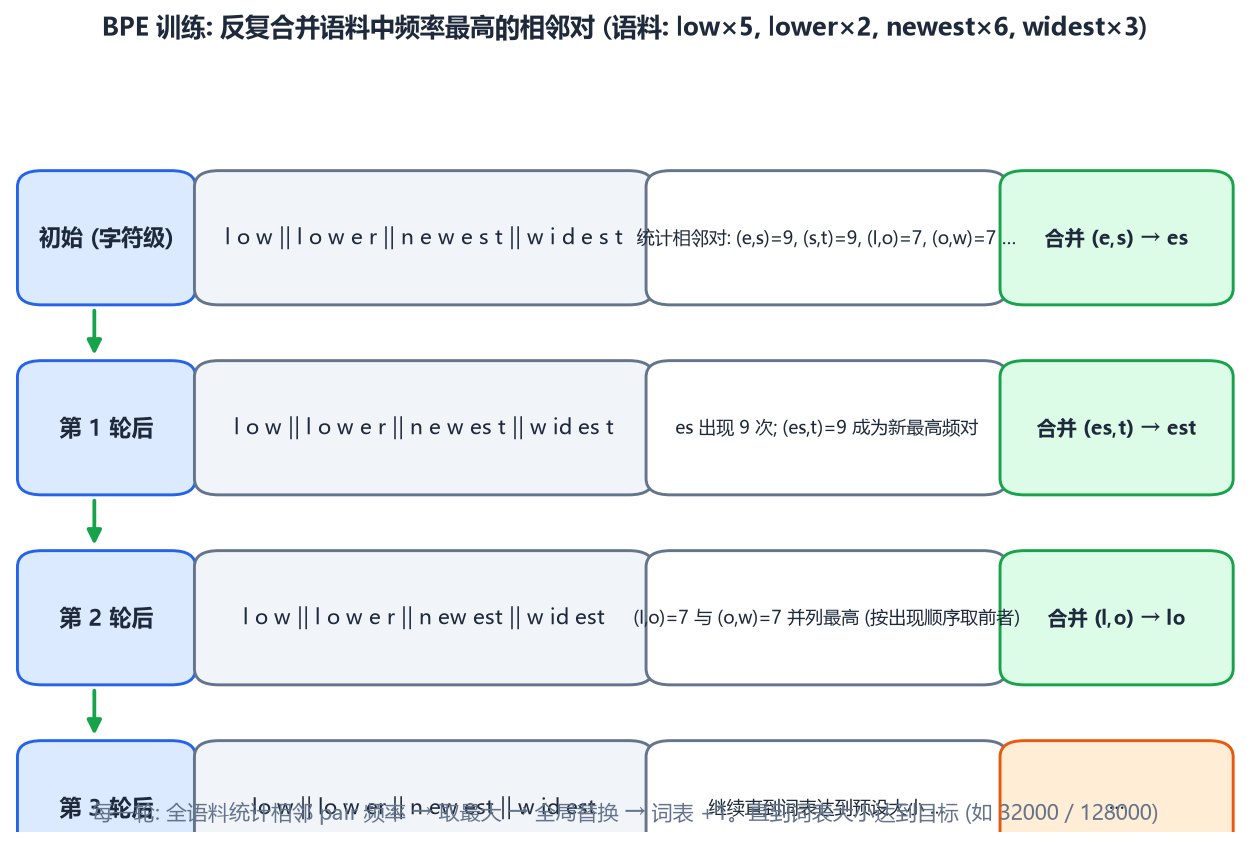
语料:low×5、lower×2、newest×6、widest×3。初始每个词拆成字符序列:
low:    l o w           × 5
lower:  l o w e r       × 2
newest: n e w e s t     × 6
widest: w i d e s t     × 3
第 0 轮统计(在全部出现次数上聚合,不是在词列表上去重):
(e,s)=6+3=9   (s,t)=6+3=9   ← 并列最高, 按惯例取先出现的 (e,s)
(l,o)=5+2=7   (o,w)=5+2=7   (n,e)=6   (e,w)=6   (w,e)=2+6=8 ← 注意是 8 不是 6
...
容易算错的地方:(w,e) 出现在 lower(2 次) 和 newest(6 次) 中共 8 次,跨词累加是新手最常犯的错误。取 (e,s) 合并为 es:
low:    l o w           × 5
lower:  l o w e r       × 2
newest: n e w es t      × 6
widest: w i d es t      × 3
第 1 轮:最高频对变成 (es,t)=9(est 在两个词里共出现 9 次),合并 → n e w est、w i d est。
第 2 轮:(l,o)=7 与 (o,w)=7 并列,按统计顺序取 (l,o) → lo。语料变为:
lo w ×5 lo w er ×2 n e w est ×6 w i d est ×3
继续下去会依次得到 low、new、wid、low er……高频模式被逐步固化。整个过程的可视化:
2.3 复杂度与工程化要点
朴素实现的每轮统计是 O(语料符号总数),共需 O(目标词表) 轮——对万亿 token 语料显然不可行。实际训练器(HF tokenizers 的 Rust 实现、SentencePiece 等)做了两件事:
- 增量更新:维护"词 → 频率"词典与"pair → 出现词集合"倒排索引,合并一个 pair 只影响包含它的词,每轮只更新受影响条目;
- 预切分(pre-tokenization):先用正则把语料切成"词"(见 3.1 节),BPE 统计与合并在词内进行,词与词之间永不合并。这把统计对象从十亿级 token 降到百万级词类型。
3. 完整可运行的 BPE 实现
下面这份实现包含训练与编码,可独立运行:
import re
from collections import Counter

# GPT-2 风格的预切分: 空格归属后面的词, 缩写/字母/标点分离
PRE_TOKEN = re.compile(r"""'(?:[sdmt]|ll|ve|re)| ?\w+| ?[^\w\s]+|\s+(?!\S)|\s+""")

def to_word_freqs(text):
    """文本 → {词(tuple of 字符): 频率}"""
    wf = Counter()
    for m in PRE_TOKEN.findall(text):
        wf[tuple(m)] += 1
    return wf

def merge_word(corpus, pair):
    """把 corpus 中所有出现的 pair 替换为合并符号"""
    out = {}
    for word, freq in corpus.items():
        buf, i = [], 0
        while i < len(word):
            if i < len(word) - 1 and (word[i], word[i+1]) == pair:
                buf.append(word[i] + word[i+1]); i += 2
            else:
                buf.append(word[i]); i += 1
        out[tuple(buf)] = out.get(tuple(buf), 0) + freq
    return out

def train_bpe(text, vocab_size):
    corpus = to_word_freqs(text)
    vocab = {c for w in corpus for c in w}    # 初始词表: 全部单字符
    merges = []                               # 有序合并规则
    while len(vocab) < vocab_size:
        pairs = Counter()
        for word, freq in corpus.items():
            for i in range(len(word) - 1):
                pairs[(word[i], word[i+1])] += freq
        if not pairs:
            break
        best = max(pairs, key=pairs.get)      # 频率最高; 并列取先统计到的
        corpus = merge_word(corpus, best)
        vocab.add(best[0] + best[1])
        merges.append(best)
    return vocab, merges

def encode_word(word, merges):
    """编码单个预切分词: 按训练顺序依次应用合并规则"""
    symbols = tuple(word)
    for pair in merges:                       # 顺序即优先级, 不可乱
        new, i = [], 0
        while i < len(symbols):
            if i < len(symbols) - 1 and (symbols[i], symbols[i+1]) == pair:
                new.append(symbols[i] + symbols[i+1]); i += 2
            else:
                new.append(symbols[i]); i += 1
        symbols = tuple(new)
    return list(symbols)

def encode(text, merges):
    ids = []
    for w in PRE_TOKEN.findall(text):
        ids.extend(encode_word(w, merges))
    return ids
用小语料验证:
corpus_text = ("low low low low low lower lower "
               "newest newest newest newest newest newest "
               "widest widest widest")
vocab, merges = train_bpe(corpus_text, vocab_size=20)
print(merges[:5])       # [('e','s'), ('es','t'), ('l','o'), ('lo','w'), ('n','e')]
print(encode("the newest low", merges))
# ['the', ' ', 'n', 'e', 'w', 'est', ' ', 'low']   ← 新词按已学规则切分
注意 encode 的一个关键性质:合并规则必须按训练得到的顺序应用。同一对符号在不同轮次进入词表的优先级不同,乱序应用会得到与训练分布不一致的切分——这是把 BPE 从训练器移植到推理侧时最经典的 bug。
3.1 预切分正则在做什么
看 PRE_TOKEN 的分支:'(?:[sdmt]|ll|ve|re) 处理英文缩写;?\w+ 让空格归属后面的词(the 是一个 token,而非 the + 单独的空格 token——空格单独进词表会浪费大量行数);?[^\w\s]+ 把连续标点聚成一组;\s+(?!\S) 处理末尾空白。为什么必须预切分?若不切,BPE 可能把 dog. 与 cat 之间的边界合并出 g. c 这类跨词碎片,词表被无意义组合污染,编码新文本时几乎无法命中长 token。
4. Byte-level BPE:GPT-2 的关键一步
原始 BPE 以 Unicode 字符为基础符号,遇到中文需要先分字(这本身是个 NLP 难题!),遇到生僻字或 emoji 直接崩掉。GPT-2 的解法干净利落:
先把文本按 UTF-8 字节编码,在字节序列上跑 BPE。
- 基础词表只有 256 个字节值,任何合法字符串——中文、emoji、二进制乱码——都能编码,永不 OOV;
- 词表大小从此完全可控(GPT-2: 50257,Llama-3: 128256),无需任何语言学先验;
- 代价:低资源语言的字可能被拆成 2~3 个字节 token,序列变长、语义单元被打散。早期 GPT 系列"中文能力弱、中文费 token"的直接原因就在这里——常用汉字没有被合并成完整 token。
补救方式是在更大更多样的语料上训练词表:Llama 词表从 32K(英文为主)扩到 Llama-3 的 128K(多语言占比大幅提升),中文压缩率接近翻倍;Qwen 用 150K 词表强化中英代码混合场景。词表是为训练语料配比定制的,这也解释了为什么更换词表几乎必然要重新预训练——embedding 的行都对不上了。
5. 另一条路:SentencePiece 与 Unigram
BPE 之外,Llama/Gemma/Mistral 系列用的 SentencePiece 框架里,默认算法 Unigram 走了完全不同的路线:
- 假设每个候选 token 有一个概率 p(t),一句话某切分的概率 = 各 token 概率之积;
- 最优切分 = 概率最大的切法,用 Viterbi 动态规划求解,复杂度 O(词长 × 候选数);
- 训练用 EM 迭代:固定词表估计各 token 概率 → 按概率重新切分语料 → 裁掉对似然贡献最小的 token;
- 初始词表取超大(百万级),逐步裁剪到目标大小。
Unigram 的优势:切分是全局概率最优而非贪心;天然支持一个词多种候选切法(训练时的 subword regularization,提升鲁棒性);空格编码为普通符号 ▁(U+2581)参与合并,不需要 GPT 那套预切分正则,语言无关。BPE 的优势:训练简单、行为确定、推理端编码极快。两条路线在各自生态里都工作得很好——词表质量的决定因素是语料配比与清洗,而不是 BPE 与 Unigram 之争。
6. 特殊 Token 与对话模板
现代词表里除了学出来的子词,还有一批特殊 token:<|begin_of_text|>、<|im_start|>、<|eot_id|>……它们有专属 ID、永不参与 BPE 合并、在 embedding 表里有自己的向量。它们存在的意义是给结构留出无歧义的标记位。
一次对话请求实际编码出的 token 流(ChatML 风格):
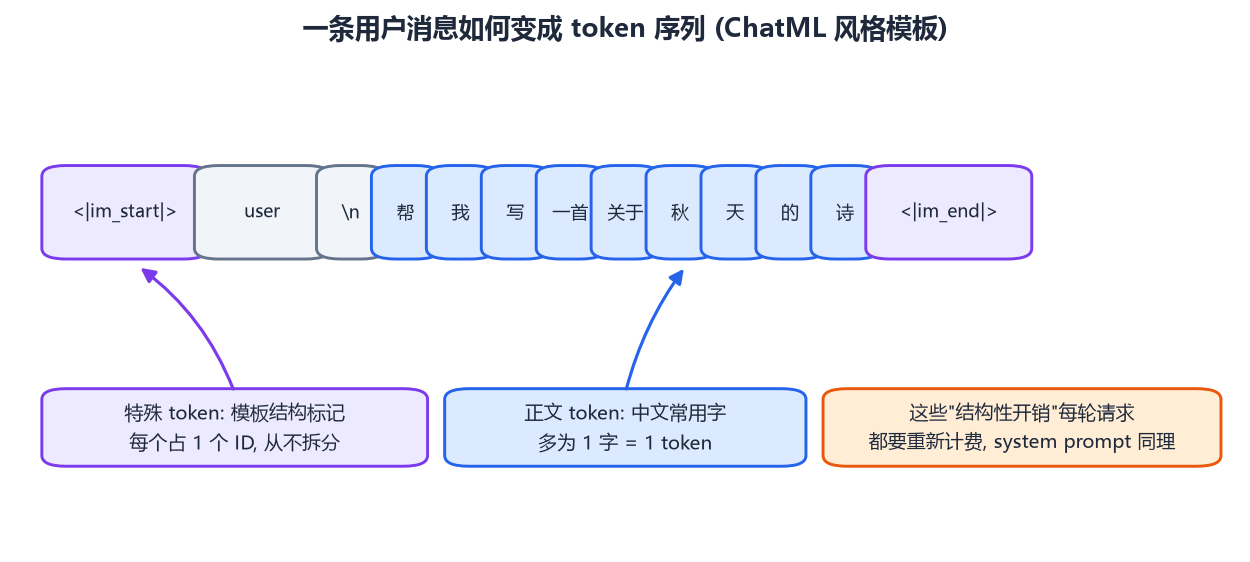
这带来两个容易被忽视的事实:
- 模板开销每轮都计费。system prompt + 模板标记在每次请求都要重新过一遍 prefill(除非服务端做了前缀缓存),一个 2000 token 的 system prompt 意味着每轮多 2000 token 的输入成本;
- 不同模型的模板互不兼容。同样的对话,Llama-2、Llama-3、Qwen、ChatGLM 的包装格式各不相同——把 A 模型的模板用在 B 模型上,等于给模型喂了一篇"结构错乱"的文本,轻则性能下降,重则直接拒绝回答。这也是推理框架都要按模型配置 chat template 的原因。
7. 词表的工程账本
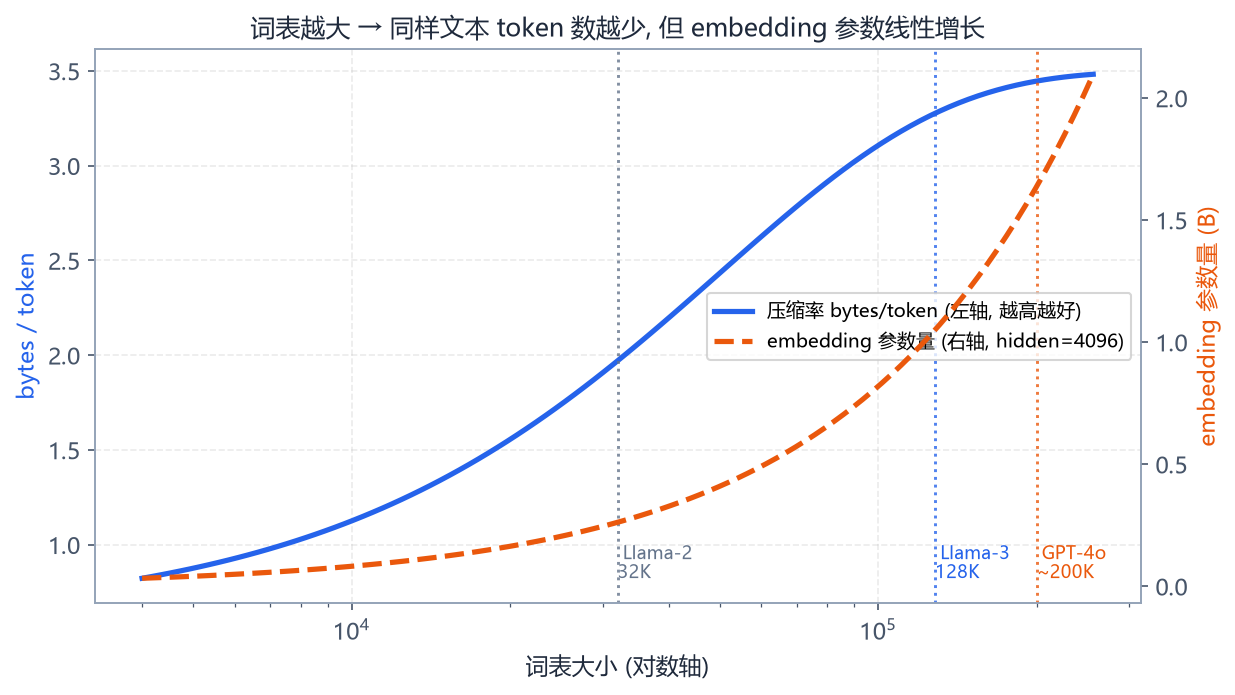
参数量:embedding = 词表 V × 隐藏维 D,输出层若不与输入共享(untied)再乘 2。以 4096 维为例:
| 词表 | 输入+输出 embedding 参数 |
|---|---|
| 32,000 (Llama-2) | 2 × 32K × 4096 ≈ 2.6 亿 |
| 128,256 (Llama-3) | 2 × 128K × 4096 ≈ 10.5 亿 |
对 70B 模型这不算什么;但对 1~2B 的小模型,一份大词表能吃掉 20% 以上的参数预算——这是小模型词表设计的核心约束。
压缩率:衡量指标是 bytes per token——同一段语料编码后,平均每个 token 承载的 UTF-8 字节数。实测方法几行就够:
import tiktoken
enc = tiktoken.get_encoding("cl100k_base")          # GPT-3.5/4 系列
text = open("sample.txt", encoding="utf-8").read()
nbytes, ntok = len(text.encode("utf-8")), len(enc.encode(text))
print(f"压缩率: {nbytes / ntok:.2f} bytes/token")    # 中英混合约 2.5~3.5
同样 8K 上下文窗口,压缩率 3.0 比 1.5 的 tokenizer 能多装一倍信息——上下文的"长度"是 token 数,不是字符数。两个模型比上下文窗口大小,若压缩率差一倍,这种比较毫无意义。
8. 分词器如何影响模型能力
几个反直觉的底层联系:
- 算术:若数字按位切分(Llama-2 风格把
12345切成1``2``3``4``5),模型能较容易学到对位操作;若切成123``45这类任意片段,多位数加减法准确率显著下降。GPT-4、Qwen 等把数字按 3 位一组编码,是刻意为之; - 拼写类任务(数单词字母、反转字符串):模型看到的是 token 而非字符,一个 token 化的 "strawberry" 根本不暴露内部字母,模型需要"脑内解码"回字节序列才能数 r 的个数——著名的 strawberry 翻车案例根源在此,而非"推理能力不足";
- 跨语言公平性:同样的意思,缅甸语的 token 数可能是英语的 5~10 倍,API 成本与上下文占用同步膨胀——tokenizer 训练语料的语言配比,直接决定了服务定价的隐性不平等;
- token 边界效应:关键概念恰好被切断在两个 token 边界上时,涉及它的检索与复制都会变差。这也是 prompt 工程"把关键词放在自然位置"背后的微观原因。
9. 小结
- 子词切分在序列长度、词表大小、OOV 三个约束间取得平衡,其可行性由 Zipf 分布保证;
- BPE 以"合并最高频相邻对"的贪心策略从语料中学习切分,规则序列本身就是词表的构造历史,编码必须按序应用;
- Byte-level 化让词表对任意文本闭合;Unigram 用概率模型 + Viterbi 提供了另一条等价可用的路线;
- 特殊 token 与对话模板是模型间的"接口约定",模板错配等于结构错乱;
- 词表大小同时影响参数量与压缩率,数字切分、token 边界这些细节会传导为实打实的模型能力差异。
下一篇,token ID 流将进入模型本体——Transformer:从 embedding 查表、QKV 注意力到 RoPE 与残差流,逐个张量拆解。