
LLM 推理引擎设计:KV Cache、PagedAttention 与连续批处理
模型训好了,怎么把它便宜、快速地跑起来?一次 API 调用背后,推理系统在毫秒级延迟与最大吞吐之间做无数权衡。这篇从 GPU 执行模型和 roofline 分析讲起,把 vLLM 三大支柱——KV Cache、PagedAttention、Continuous Batching——拆到字节与调度循环级,再覆盖投机解码的接受概率数学、采样参数与生产选型。
1. 先建立直觉:decode 阶段 GPU 在干什么
一个反直觉的事实:生成 token 时,GPU 的计算单元大部分时间在空转,真正卡住的是显存带宽。要理解这一点需要两个数字:
- 每 token 前向的浮点量 ≈ 2 × 参数量(每个参数参与一次乘 + 一次加)。7B 模型 = 14 GFLOP/token;
- 每 token 前向要读的权重量 = 参数量 × 每参数字节数。FP16 下 7B = 14 GB/token。
A100 的算力是 312 TFLOP/s、显存带宽 2 TB/s。算一下 batch=1 生成一个 token 需要多久:
算力视角:   14 GFLOP ÷ 312 TFLOP/s = 0.045 ms   ← 如果算力是瓶颈
带宽视角:   14 GB    ÷ 2.0 TB/s    = 7.0 ms     ← 实际耗时, 慢 150 倍!
带宽是瓶颈:权重从 HBM 搬进计算单元的时间,是算完这些乘加所需时间的 150 倍。算术强度(FLOP/Byte)只有 14G/14G = 1,而"算力跑满"需要的强度是 312T/2T ≈ 153。
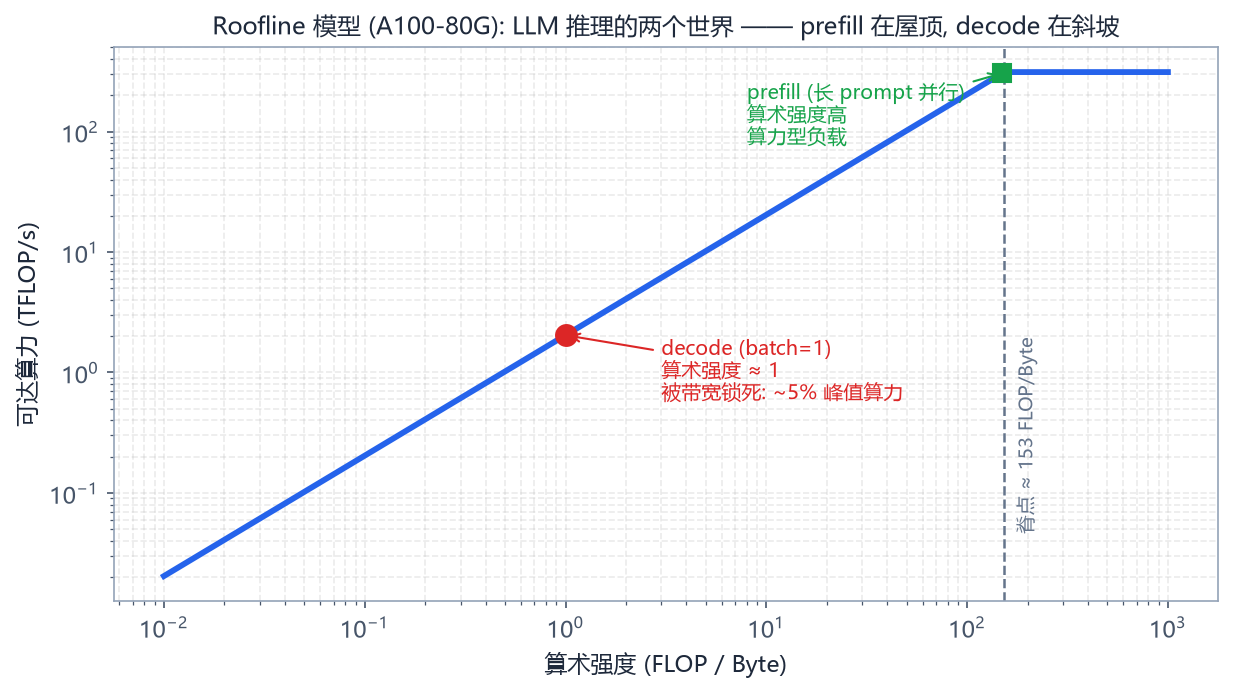
提高 batch size 是免费的午餐:batch=8 时一次搬运 14GB 权重服务 8 个请求,算术强度×8,吞吐接近×8,而延迟几乎不变(计算单元反正闲着)——直到跨过脊点变成算力受限。这就是推理引擎拼命做批处理的根本动力。
2. 两阶段:Prefill 与 Decode
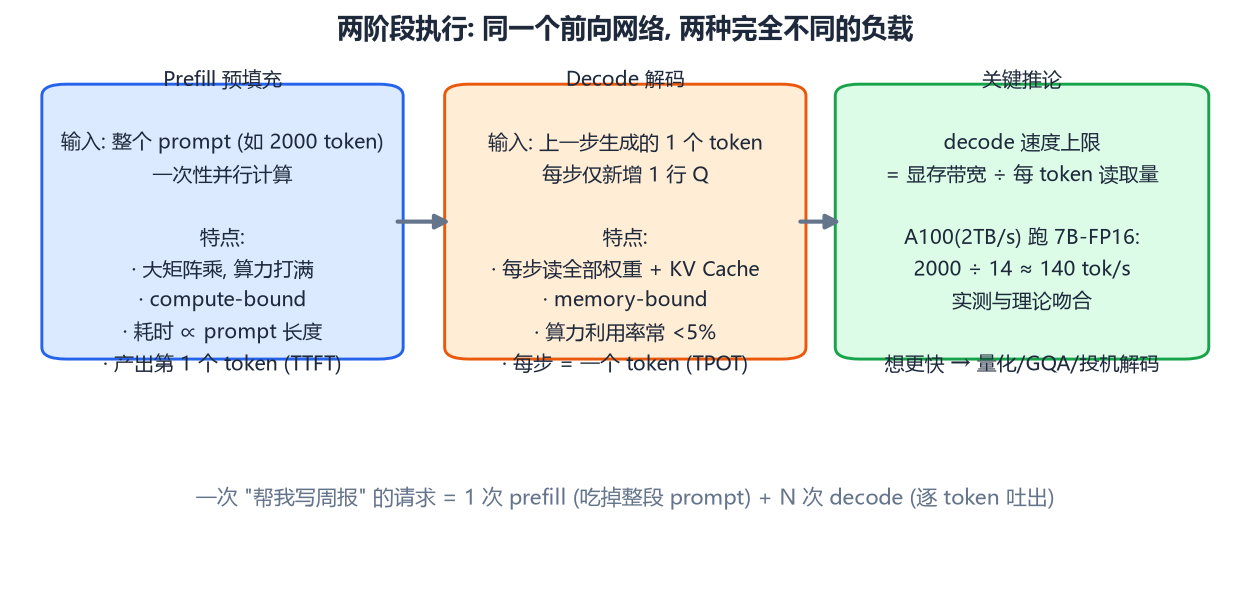
Prefill(预填充):处理输入 prompt,T 个位置的 Q 一次并行算完。矩阵形状是 [T, 4096]×[4096, 4096]——大矩阵乘,算力打满(compute-bound)。耗时与 prompt 长度成正比,决定TTFT(Time To First Token,首 token 延迟)。这就是 API 定价里"输入 token 比输出便宜"的物理依据:prefill 是算力型负载,单位 token 的边际成本远低于 decode。
Decode(解码):每步只有 1 个新 token 参与前向,但每步都要读全部权重 + 全部 KV Cache——memory-bound,算力利用率常低于 5%。每步耗时决定 TPOT(Time Per Output Token,吐字间隔)。
用户体感:TTFT 决定"转圈多久才出字",TPOT 决定"出字后流式有多顺"。两者的优化手段完全不同:TTFT 靠 chunked prefill、prompt 缓存、更快的 kernel;TPOT 靠量化、GQA、投机解码、更大 batch。
3. KV Cache:空间换时间的推导
3.1 为什么可以缓存
因果注意力保证:位置 i 的 K、V 向量一旦算出,后续所有步都不变(它们只依赖位置 ≤i 的输入)。不缓存则第 T 步要重算全部 T 个位置的 K/V——O(T²) 次矩阵乘。缓存后每步只算 1 个新位置的 q/k/v,再让新 q 与缓存里全部 k 做注意力。
3.2 缓存多大:逐字节推导
每个 token 每层要存 K 和 V 各一个 [d_model] 向量(GQA 下是 [n_kv × d_k]):
KV 字节/token = 2 (K和V) × L (层数) × n_kv × d_k × 每元素字节数
             = 2 × 32 × 1024 × 2B   (7B GQA: 8 头×64维)
             = 0.125 MB/token
注意 d_model = n_head × d_k = 4096,GQA 把 n_kv 从 32 降到 8,缓存就缩小 4 倍——GQA 是为 KV Cache 而生的架构设计。
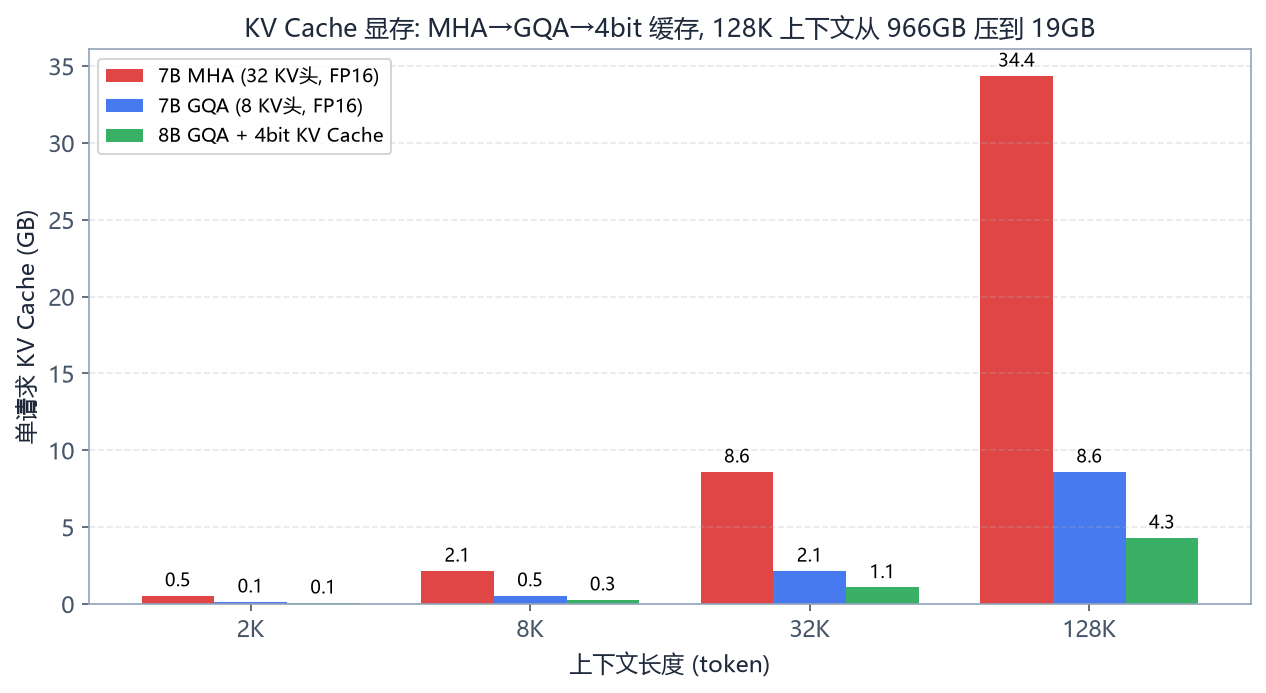
看这张图的震撼之处:MHA 模型跑 128K 上下文,单请求 KV Cache 要 966GB——根本不可能;GQA + 4bit KV 缓存压到 19GB,128K 才变得可服务。长上下文的成本大头从来不是权重,是缓存。
3.3 权重与缓存的预算分配
一张 80GB A100 部署 7B(FP16 权重 14GB)后,剩余 ~60GB 全给 KV Cache 与激活。按 0.125MB/token,能容纳 48 万 token 的并发上下文——听起来很多,但 4K 上下文的请求只能塞 120 个。推理引擎的本质工作,就是管理这个稀缺的缓存池。
4. PagedAttention:操作系统分页的完美移植
4.1 传统方案的浪费
朴素实现按最大序列长度预分配连续显存:请求一来先预留 max_len(如 4K)的 KV 空间。实际生成往往 500 token 就结束——预留的 4/5 全程闲置(内部碎片);加上不同请求长度不一,连续块之间还产生外部碎片。vLLM 论文实测:传统方案 60%~80% 的 KV 显存被浪费,等于把最贵的资源扔掉大半。
4.2 分页:块表 + 按需分配
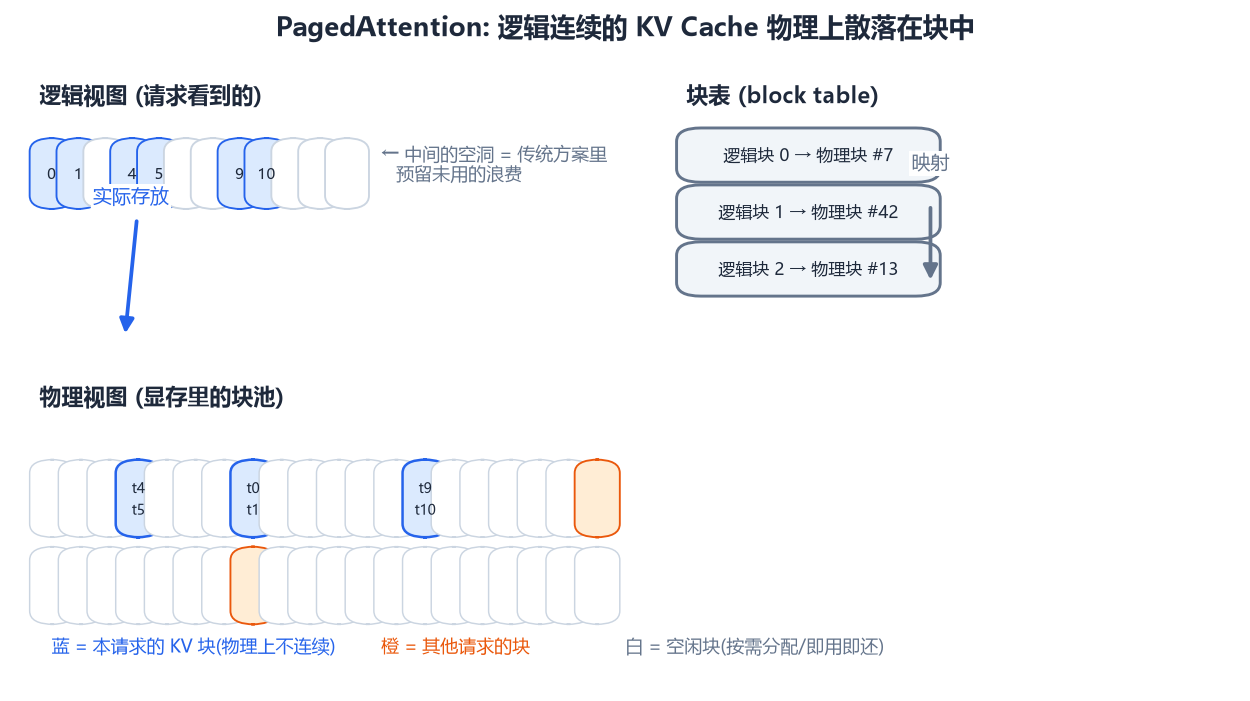
PagedAttention 把 OS 虚拟内存整套搬过来:
- KV Cache 切成固定大小的块(block,默认 16 token);
- 每个请求的 KV 逻辑连续、物理分散,映射关系存在块表里;
- 生成到第 17 个 token 才分配第 2 块,序列结束立刻回收块进池子。
浪费从 60%+ 降到 4% 以下(只有最后一块的尾部空隙),同等显存并发能力翻 2~4 倍。
分页还顺手解决了两个问题:
- 前缀共享(copy-on-write):100 个请求共用同一个 2K 的 system prompt 时,共享部分的 KV 块只存一份、只算一次,请求间分裂后才复制——vLLM 的 automatic prefix caching 就是它;
- 并行采样/beam search 共享:同一请求的 4 个候选序列共享已生成的 KV 块,各自只追加自己的增量。
注意力 kernel 也为分页重写:Q 与"通过块表间接寻址的 K/V 块"做注意力,物理不连续对 kernel 透明。
5. Continuous Batching:调度粒度革命
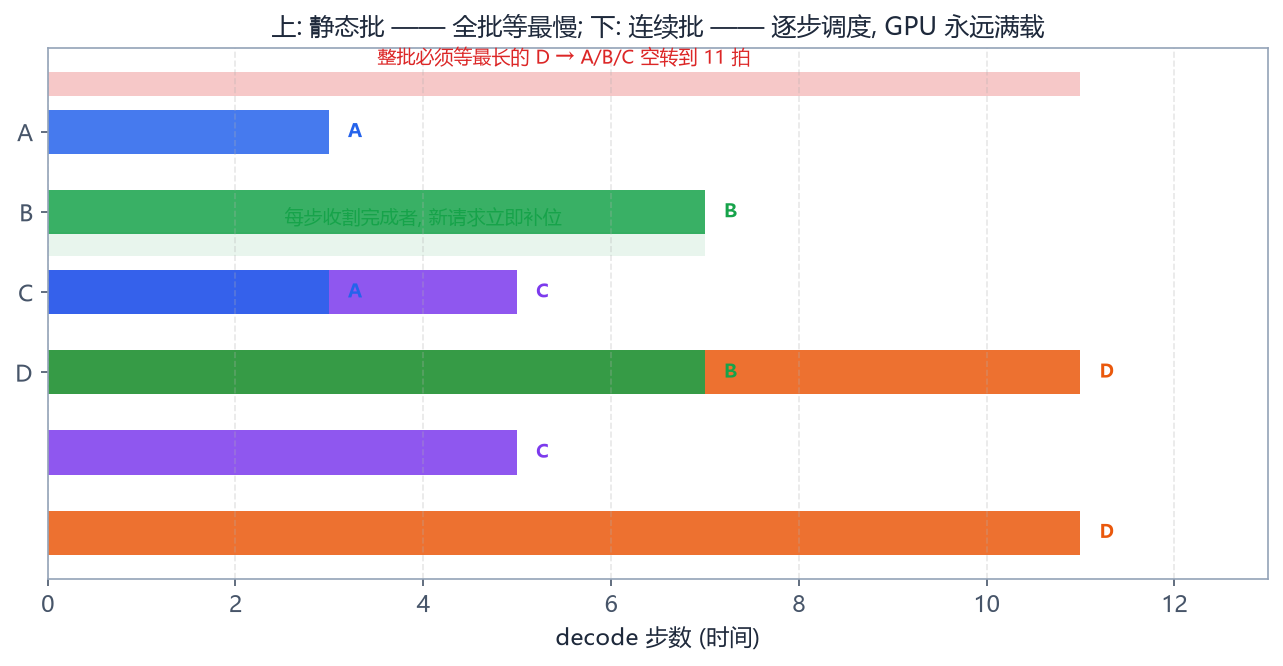
静态批:攒 N 个请求成一个 batch,全组生成完一起返回。两个致命伤:短请求陪长请求干等(图上部,A 3 拍完成却等了 11 拍);批满期间新请求只能排队。
连续批(iteration-level scheduling):调度粒度从"整批"细化到"每一步":
每轮 decode 迭代:
  1. 收割: 检查 batch 中每个请求, 生成 EOS/达到上限者移出, 结果立即返回
  2. 补位: 等待队列的新请求做 prefill, 填进空槽
     (若新请求的 KV 分配不出, 则先挂起, 不阻塞整批)
  3. 对当前 batch 统一执行一步 decode
  4. prefill 与 decode 混排时, 按 chunked prefill 把长 prompt 切片
     分摊到多步, 避免一次大 prefill 卡住所有人的 decode
第 4 点是 vLLM --enable-chunked-prefill 的内容:一个 20K token 的 prefill 若独占一步,批内其他请求的 TPOT 会突然恶化;切成 2K 一片混进 decode 步里,延迟抖动被抹平。
实测收益:连续批比静态批吞吐高一个数量级,这也是 vLLM 论文标题里 "Easy, Fast, and Cheap" 的主要来源。
6. 投机解码:无损加速的数学
Decode 的算力利用率不到 5%——那 95% 的闲置算力能不能换速度?投机解码(Speculative Decoding)的答案是能:
- 用一个 10~50 倍小的草稿模型连续自回归猜 k 个 token(读的是 1.4GB 而非 14GB,便宜);
- 用大模型一次前向并行验证这 k 个 token——并行计算对 memory-bound 的大模型几乎免费;
- 从左到右接受与大模型分布一致的 token,首个分歧点丢弃,并从大模型分布采样一个"纠正 token"。
关键定理:接受规则经过精心设计(按 min(p/q) 概率接受 + 拒绝时重采样),最终输出的分布与直接用大模型采样严格相同——零质量损失,纯粹的时间搬家。
期望加速 = 草稿命中率 × 长度增益。代码、JSON、固定格式文本这类"可预测"内容草稿命中率高达 80%+,实测加速 2~3 倍;自由创作命中率低,增益有限。变体:Medusa(在主模型上加多个解码头同时预测未来 token,无需独立草稿模型)、EAGLE(在特征层而非 token 层做投机,命中率更高,当前 SOTA)。
7. 采样:从 logits 到 token 的最后一公里
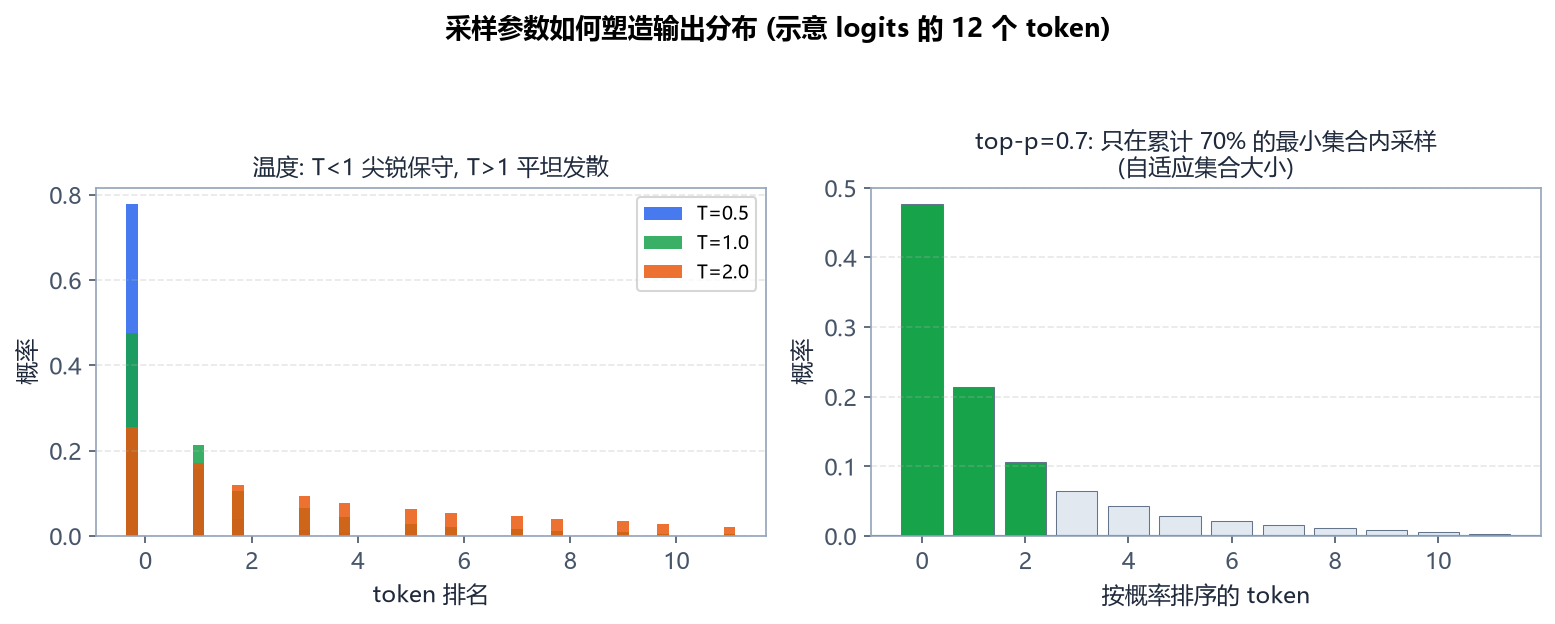
logits 变成 token 的三件套:
- Temperature T:logits ÷ T 再 softmax。T→0 退化为 argmax(贪心,适合代码);T=1 原始分布;T>1 平坦化(更有创意,更易胡说)。数学上 T 改变的是分布的"锐度";
- Top-k:只保留概率前 k 个 token 再归一化采样。简单粗暴,但最优 k 因分布形状而异;
- Top-p(nucleus):保留累计概率达 p 的最小集合——分布尖锐时候选少、分布平坦时候选多,自适应优于固定 k。p=0.9~0.95 是通用推荐。
工程细节两条:repetition penalty 对已出现 token 的 logits 除以惩罚因子再归一化,抑制复读,但调太猛会破坏代码中必要的重复结构;seed 固定时同一请求可复现(greedy 或固定采样器),调试与评测依赖这一点。
8. 生产选型速查
| 引擎 | 特点 | 适合 |
|---|---|---|
| vLLM | PagedAttention、连续批、前缀缓存、生态最全 | 在线服务首选 |
| SGLang | RadixAttention 前缀树缓存、结构化输出极快 | 复杂 Agent/多轮前缀复用 |
| TensorRT-LLM | NVIDIA 官方、kernel 极致、in-flight batching | 追求极限性能、愿意调参 |
| llama.cpp / Ollama | CPU/GPU 混合、量化格式全 | 本地与边缘部署 |
运维三个数:TTFT(目标 <500ms)、TPOT(<50ms/token 接近人阅读速度)、吞吐(token/s/GPU)。三者互相牵制(大 batch 提吞吐但抬 TPOT),按业务定 SLO 再调引擎参数。
9. 小结
- decode 是带宽瓶颈(强度≈1,脊点 153),速度上限 = 带宽 ÷ 每 token 读取量,batch 提升强度是免费午餐;
- KV Cache 每层 2×n_kv×d_k 字节/token,GQA 与 4bit 缓存是长上下文的生死线;
- PagedAttention 用块表消灭 60%+ 的碎片浪费并天然支持前缀共享;连续批把调度细化到每步,吞吐翻一个量级;
- 投机解码用闲置算力做"草稿-验证",输出分布严格无损;
- 采样参数是应用层最直接的模型行为旋钮。
模型本身还能再省一半显存吗?下一篇讲量化:数值格式、GPTQ/AWQ/GGUF 与选型。