
大模型量化:从 INT8、GPTQ 到 GGUF 的压缩实践
7B 模型 FP16 要 14GB 显存,一台 16GB 内存的笔记本想跑本地大模型,唯一出路是把权重压到 4bit(约 4GB)。量化(Quantization)用更低的数值精度表示权重,用可控的精度损失换 2~4 倍显存节省和接近线行的解码加速。这篇从 IEEE 754 的位布局讲起:量化数学(scale/zero-point 推导、误差分析)、LLM 特有的离群点难题、GPTQ 的 Hessian 补偿、AWQ 的激活感知、GGUF 的混合分块,附真实模拟实验与选型决策。
1. 数值的地基:位布局决定一切
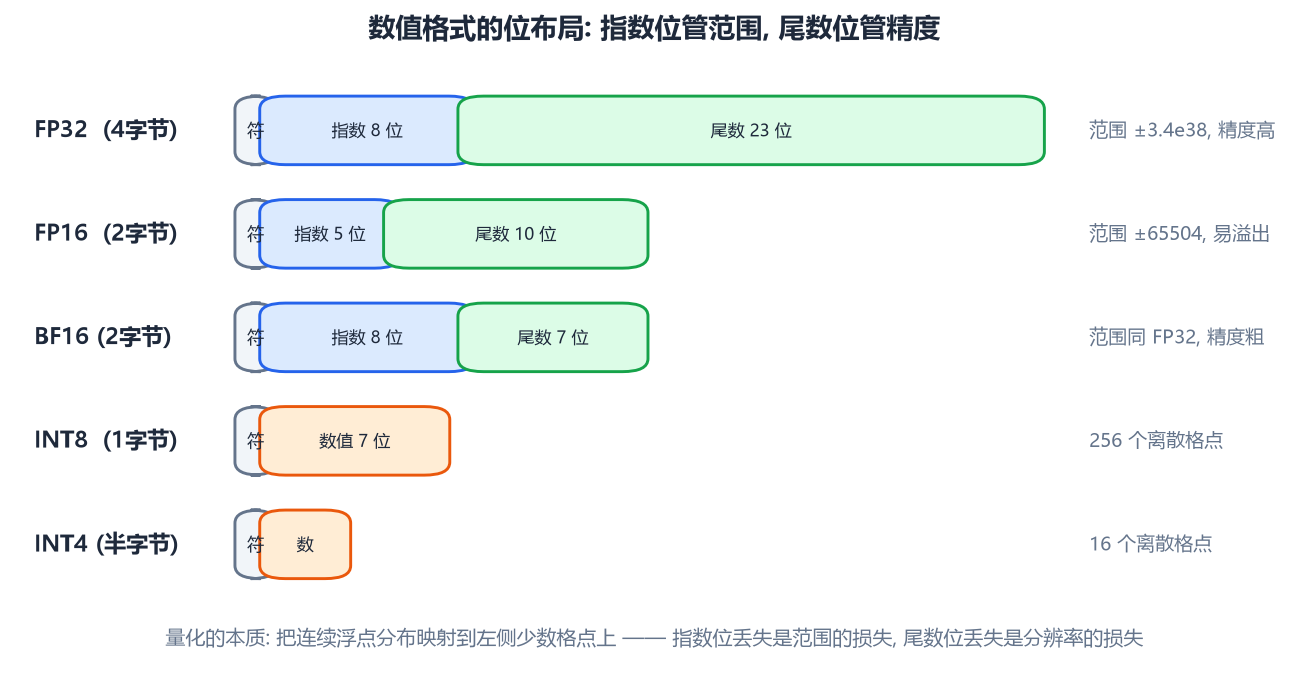
浮点数 = 符号 × 1.尾数 × 2^指数。指数位决定动态范围,尾数位决定相对精度——这两个维度要分开理解:
- FP16 的 5 个指数位只覆盖 ±65504,深度学习里梯度一大就上溢(inf),于是需要 loss scaling;
- BF16 用 8 个指数位(与 FP32 同范围)换 7 个尾数位——牺牲精度换范围,配合自适应优化器完全够用,这就是训练篇里 BF16 胜出的原因;
- INT8/INT4 是均匀格点:相邻可表示值的间距固定,没有浮点的"小数点浮动"。量化做的事就是把浮点分布映射到这些格点上。
一个用来校准直觉的数字:INT4 每个权重只有 16 种取值。一层 4096×4096 的矩阵,1660 万个权重挤在 16 个格点上——信息必然损失,全部工程技巧都是为了决定丢哪部分信息最不伤模型。
2. 量化数学:从公式到误差
2.1 仿射量化
把 FP16 权重 w 映射到整数格点 q:
量化:    q = clamp( round(w / s) + z,  qmin, qmax )
反量化:  ŵ = s · (q − z)
其中     s = (wmax − wmin) / (qmax − qmin)      缩放因子
         z = qmin − round(wmin / s)             零点
对称量化取 z=0(INT8 常用,s = max|w|/127);非对称量化允许零点偏移(INT4 常用,适合分布不对称的权重)。s、z 以浮点保存——它们的开销极小:per-channel(每个输出通道一套)只需 4096×2 个标量对 1660 万权重,占比 0.05%。
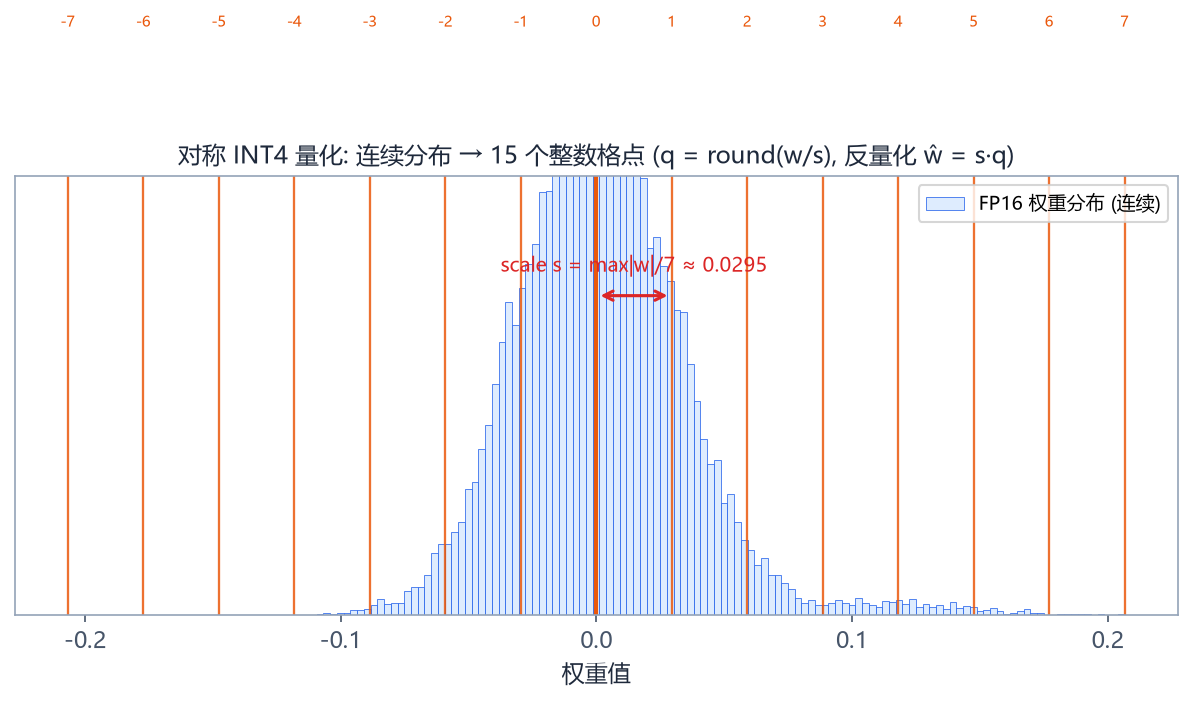
2.2 误差从哪里来
量化误差 e = w − ŵ,对 round 误差的经典分析:round 误差近似均匀分布在 (−s/2, s/2),所以每个权重的最大误差是半个格点步长,均方差 ∝ s²/12。降低 s 的唯一办法是让"这一组权重共享的最大值"变小——这就是分组(group)量化的意义:
per-tensor:  整层共享一个 s  ← s 被层内最大权重决定
per-channel: 每个输出通道一个 s
per-group:   每 g 个权重(如 128)一个 s  ← 常用于 4bit, s 的开销 16/128 = 0.125 bit/权重
实测对比见第 5 节的模拟实验——group=128 相比 per-tensor,误差标准差显著下降。
2.3 离群点:LLM 量化的头号敌人
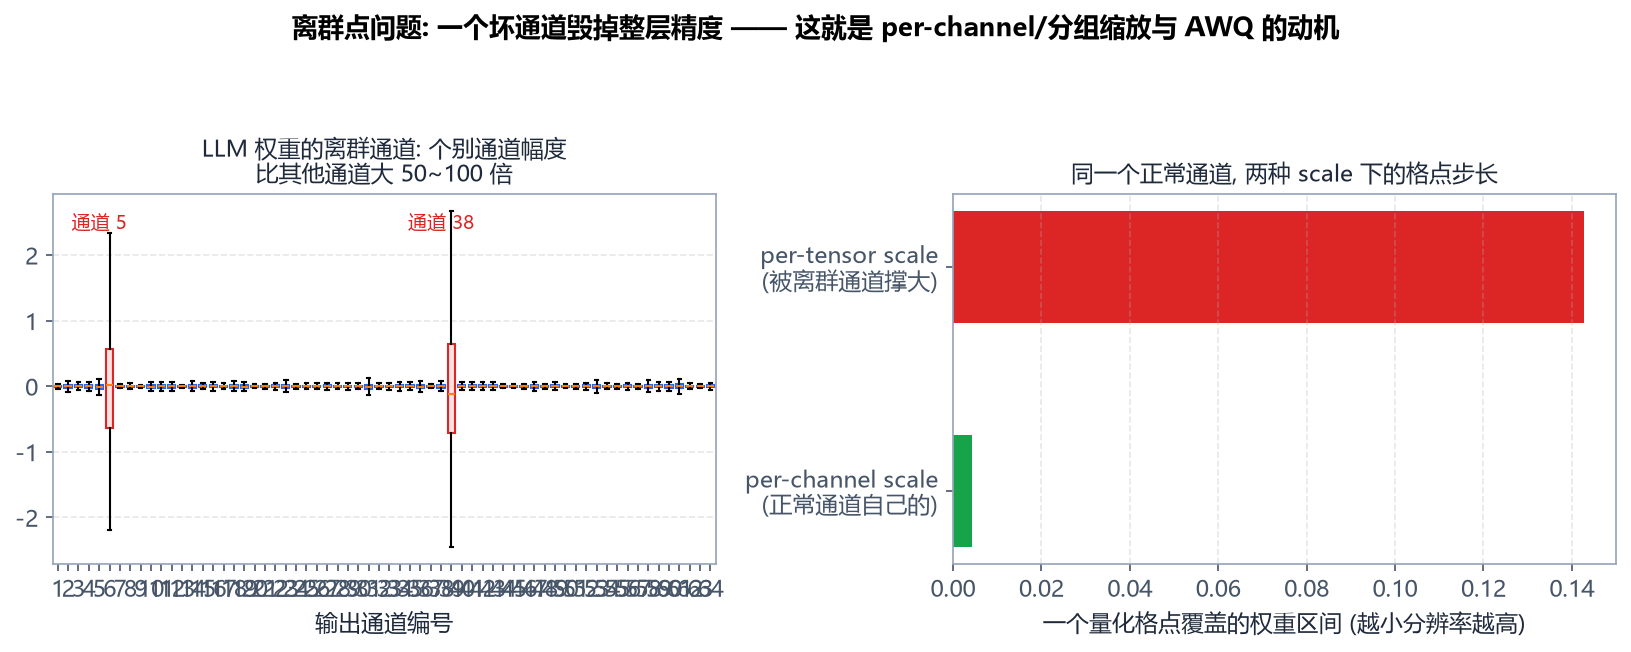
2022 年 LM-Patch 论文(SmoothQuant 前作)系统报告了现象:Transformer 权重中存在固定的离群通道——个别输出通道的幅度比中位数大 50~100 倍,且贯穿所有层、持续存在(不是噪声)。
后果:per-tensor 的 s 被 outlier 撑大一个量级 → 其余 99% 权重的格点分辨率被稀释一个量级 → 量化误差暴涨。三种解药对应三大方案:
- 缩小共享范围:per-channel / per-group(治标,GPTQ/AWQ 都默认做);
- 把难度从激活迁移到权重:SmoothQuant 对离群通道乘 1/s、对应对应输入除 s(数学等价变换),激活变温和、权重变"难"但权重好量化 → W8A8 全量化成为可能;
- 保护重要通道:AWQ(下文)。
2.4 权重 vs 激活:难度不对称
权重在训练后分布稳定、逐层已知——可以离线精细处理。激活随输入变化、且带离群点——在线量化只有很小的校准窗口。所以主流策略是 weight-only 量化:只压权重(解码时每 token 读取量减半 → 速度近翻倍),激活留 FP16;矩阵乘在 kernel 里反量化后仍以高精度进行。W8A8(权重激活都压)需要 SmoothQuant 这类迁移技巧,多用于训练侧部署。
3. PTQ vs QAT:两条路线
PTQ(训练后量化):拿训好的模型,用几百条校准数据离线量化,几十分钟出结果。开源生态 95% 的场景。代价:位宽压到 4bit 以下时质量崩塌。
QAT(量化感知训练):在训练/微调里插入伪量化节点——前向模拟"量化→反量化"的误差,反向用直通估计器(STE,把 round 的零梯度当作 1)让权重主动适应格点。质量上限高,但要训练资源。实践中只在两个场景启用:3bit 以下极端压缩、或端侧部署对精度锱铢必较。
4. 三大 PTQ 方案的设计思想
4.1 GPTQ:Hessian 引导的逐列量化 + 误差补偿
朴素 RTN(round-to-nearest)逐个权重量化、误差直接累积。GPTQ 的目标改为:最小化该层输出的重构误差,而非权重本身的误差:
min ‖ W·X − Ŵ·X ‖²      X: 校准数据激活 [in, N]
等价于关于 W 的二次型, 其 Hessian = 2·X·Xᵀ
算法把 W 按列量化:量化完第 i 列产生误差 δ 后,把 δ 对未量化列的影响折算进剩余列(用 Hessian 逆的信息做误差补偿),让输出误差最小而不是权重误差最小。一次前向扫描完成整层。效果:INT4 下困惑度退化显著小于 RTN,INT3 也保持可用。
4.2 AWQ:激活感知,保护 1% 的关键通道
AWQ 的两个观察:(1) 只有约 1% 的通道是关键通道(激活幅度大),它们对精度敏感;(2) 直接对这些通道保持 FP16(混合精度)会让硬件实现变差。AWQ 的解法是等价缩放:
对关键通道:  W[:, j] ← W[:, j]·s_j    (放大后量化, 相对分辨率更高)
同时输入侧:  X[:, j] ← X[:, j]/s_j    (输出数学不变)
s_j 不用梯度学,而是在 {1, 1/2, ...} 网格上搜——与校准内容无关,跨任务泛化好、不过拟合。AWQ-4bit 是当前 GPU 部署最常用格式之一(vLLM/SGLang 一级支持)。
4.3 GGUF / llama.cpp:消费级硬件的事实标准
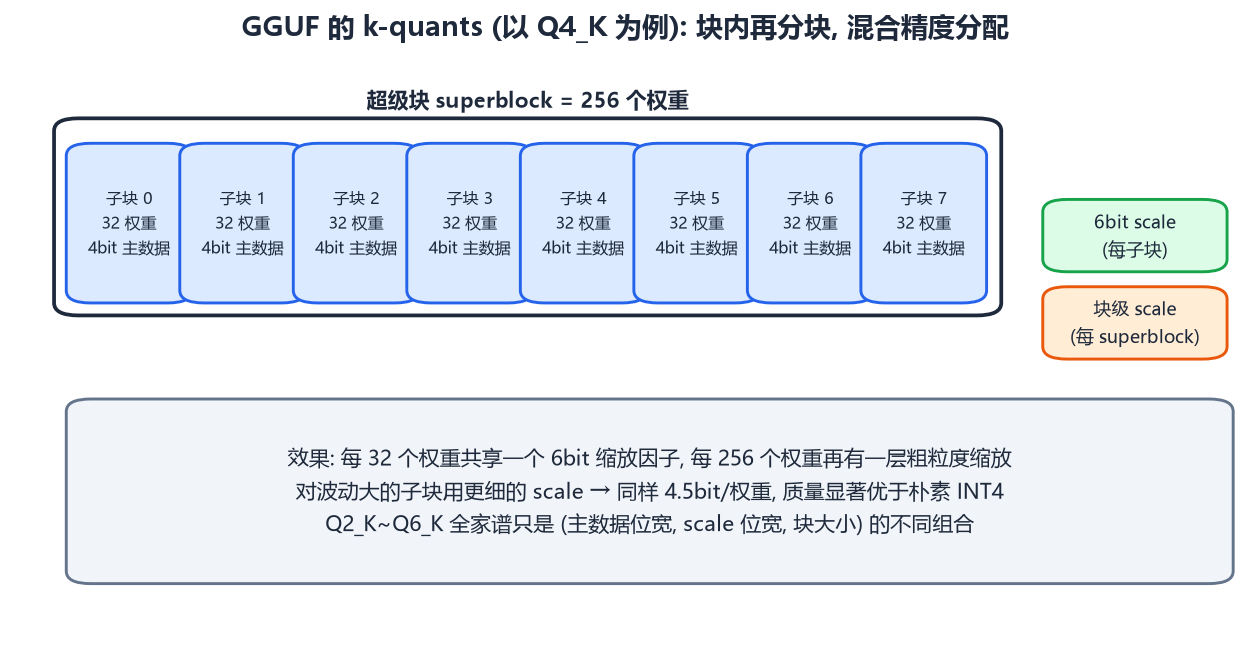
本地部署(Ollama、LM Studio 底层)统一走 GGUF 格式,核心是 k-quants 家族:把 256 个权重组成 superblock、再切成 8×32 的子块,主数据与缩放因子用不同位宽(如 Q4_K:4bit 权重 + 6bit 子块 scale + 更粗的块级 scale)。直觉:不同区块的权重分布不同,给波动大的块更细的 scale——同样平均 4.5bit/权重,质量明显优于朴素 INT4。
GGUF 的另一半价值在工程:单文件打包权重+词表+超参(即拷即用)、CPU 优先的 SIMD kernel、layer offload(部分层放 GPU、其余留 CPU 内存),让没有大显存的机器也能跑 70B。
4.4 kernel:量化收益能否兑现
INT4 权重若"反量化→FP16 矩阵乘"分两步做,反而更慢。生产级 kernel(Marlin、Machete、ExLlama)做融合反量化 GEMM:权重 tile 在寄存器/共享内存里就地展开、直接参与乘累加,省掉中间显存往返。选部署栈时要确认它的量化 kernel 是融合的——否则"省显存但更慢"。
5. 一份可复现的模拟实验
用 numpy 对真实形状的权重层做量化,观察误差规律(完整代码可跑):
import numpy as np

def quant(W, bits=4, group=128):
    """per-row + 分组对称量化"""
    B, N = W.shape
    out = np.empty_like(W)
    for j in range(0, N, group):
        blk = W[:, j:j+group]
        s = np.abs(blk).max(axis=1, keepdims=True) / (2**(bits-1) - 1) + 1e-12
        out[:, j:j+group] = np.round(blk / s) * s
    return out

rng = np.random.default_rng(0)
W = rng.standard_normal((4096, 4096)) * 0.025     # 真实层量级
for bits in (8, 5, 4, 3, 2):
    err = np.abs(W - quant(W, bits)).mean() / np.abs(W).mean()
    print(f"INT{bits}: 平均相对误差 {err*100:.2f}%")
# 典型输出: INT8 0.05% | INT5 0.5% | INT4 1.0~1.5% | INT3 3%+ | INT2 8%+
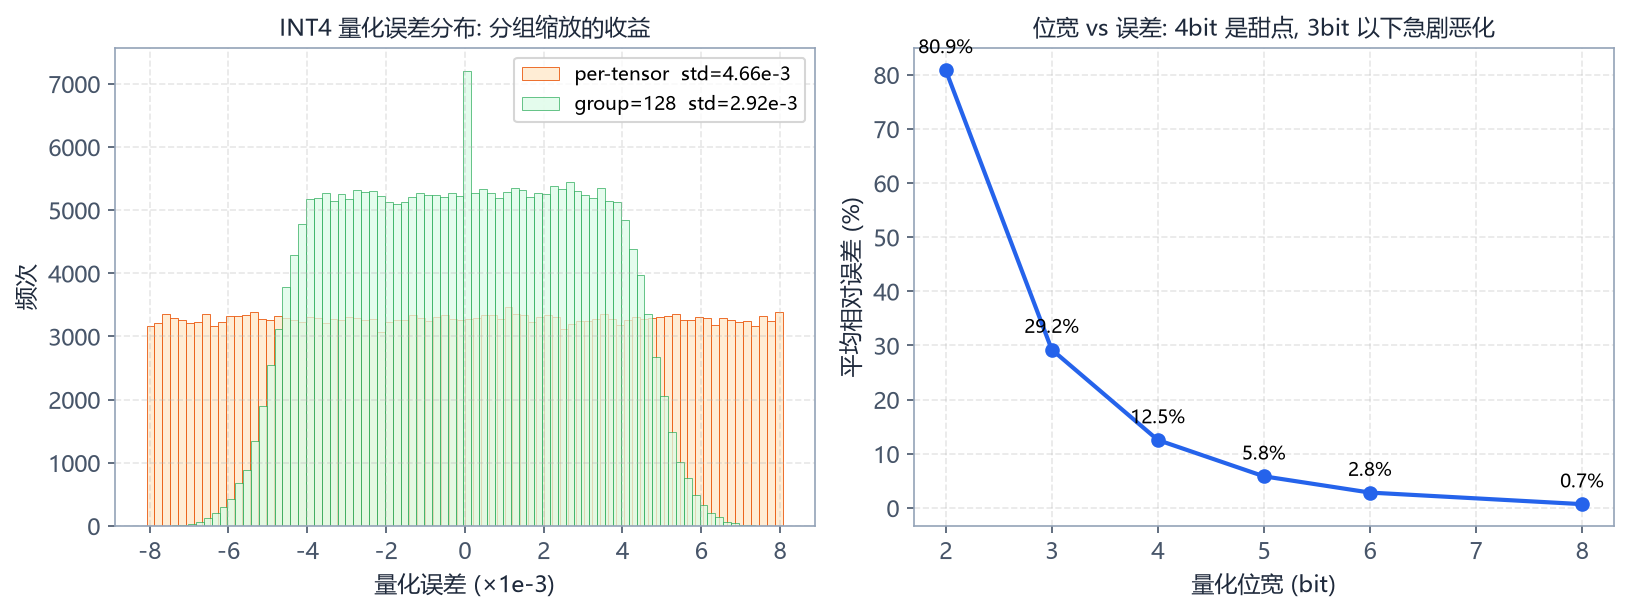
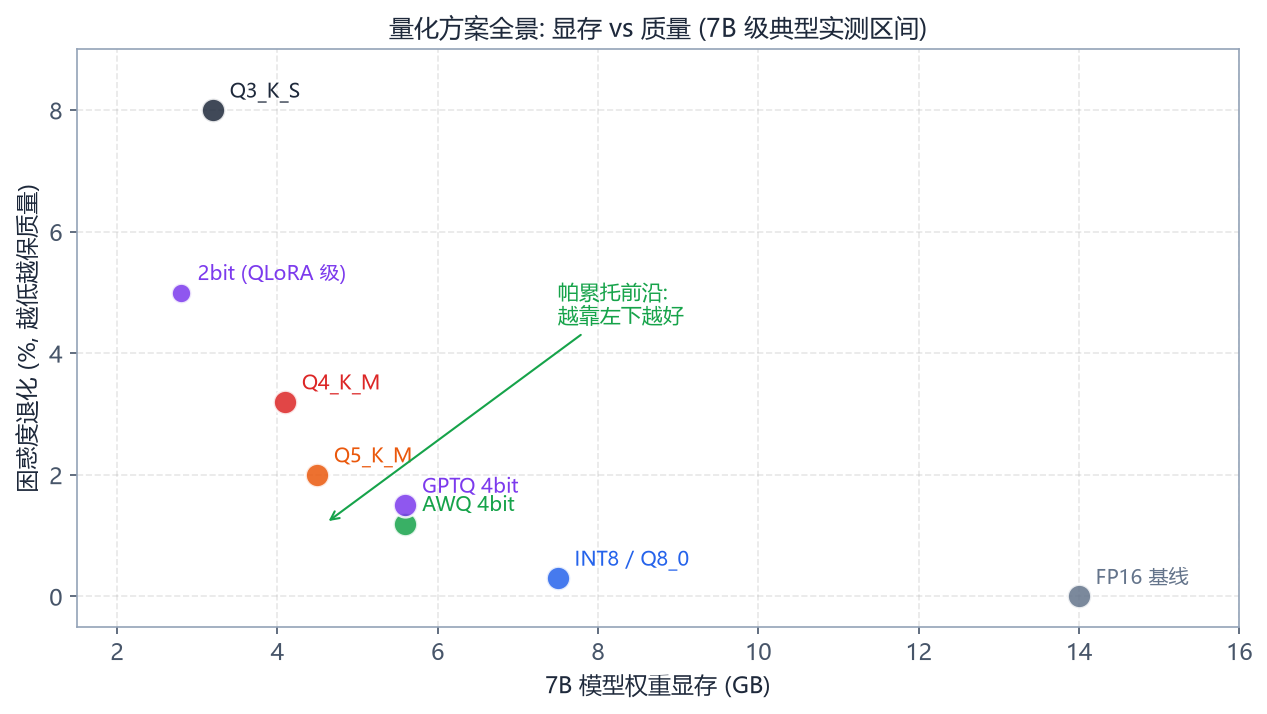
结论与社区大规模实测一致(右图是全方案的显存-质量地图):8bit 无脑安全,4bit 是甜点,3bit 明显可感,2bit 只配给 QLoRA 当底座。
6. 显存与速度的账
7B 模型(含 10% 开销):
| 精度 | 权重 | 可运行硬件 | decode 加速(相对 FP16) |
|---|---|---|---|
| FP16 | 14 GB | 24G 显卡 | 1.0× |
| INT8 | 7.5 GB | 12G 显卡 | 1.2~1.5× |
| 4bit | 4.5 GB | 8G 显卡 / 16G 内存+CPU | 1.5~2.2× |
加速来自推理篇的结论:decode 速度 ≈ 带宽 ÷ 每 token 读取量,权重读一半、速度近乎翻倍。70B 是量化的最大受益者:FP16 要 4×A100,INT4 单卡 48G 可跑。
7. 选型决策
在线服务、追吞吐        → AWQ/GPTQ 4bit + vLLM (融合 kernel)
本地电脑、无独显        → GGUF Q4_K_M + llama.cpp/Ollama
显存充裕、质量敏感      → INT8 起步
70B 进单机             → INT4 是唯一解, 或换 MoE 模型
要微调又没卡           → QLoRA (4bit 基座 + LoRA)
再往下压 (≤3bit)       → 考虑 QAT 或换更小的模型, 别硬量化
8. 小结
- 指数位管范围、尾数位管精度;量化 = 把连续分布映射到均匀格点,误差 ∝ 格点步长;
- 离群通道是 LLM 量化之敌,per-channel/分组缩放、SmoothQuant 迁移、AWQ 保护三条路各治一层;
- GPTQ 最小化输出重构误差(Hessian 补偿),AWQ 用等价缩放保护关键通道,GGUF 用混合位宽分块统治本地部署;
- 4bit 是质量-显存的甜点;kernel 必须融合反量化才能兑现速度收益。
至此模型本体的底层与系统层全部走完。接下来进入应用层:RAG——把私有知识接进模型的完整链路。