
RAG 系统设计:从 Embedding、混合检索到重排的完整链路
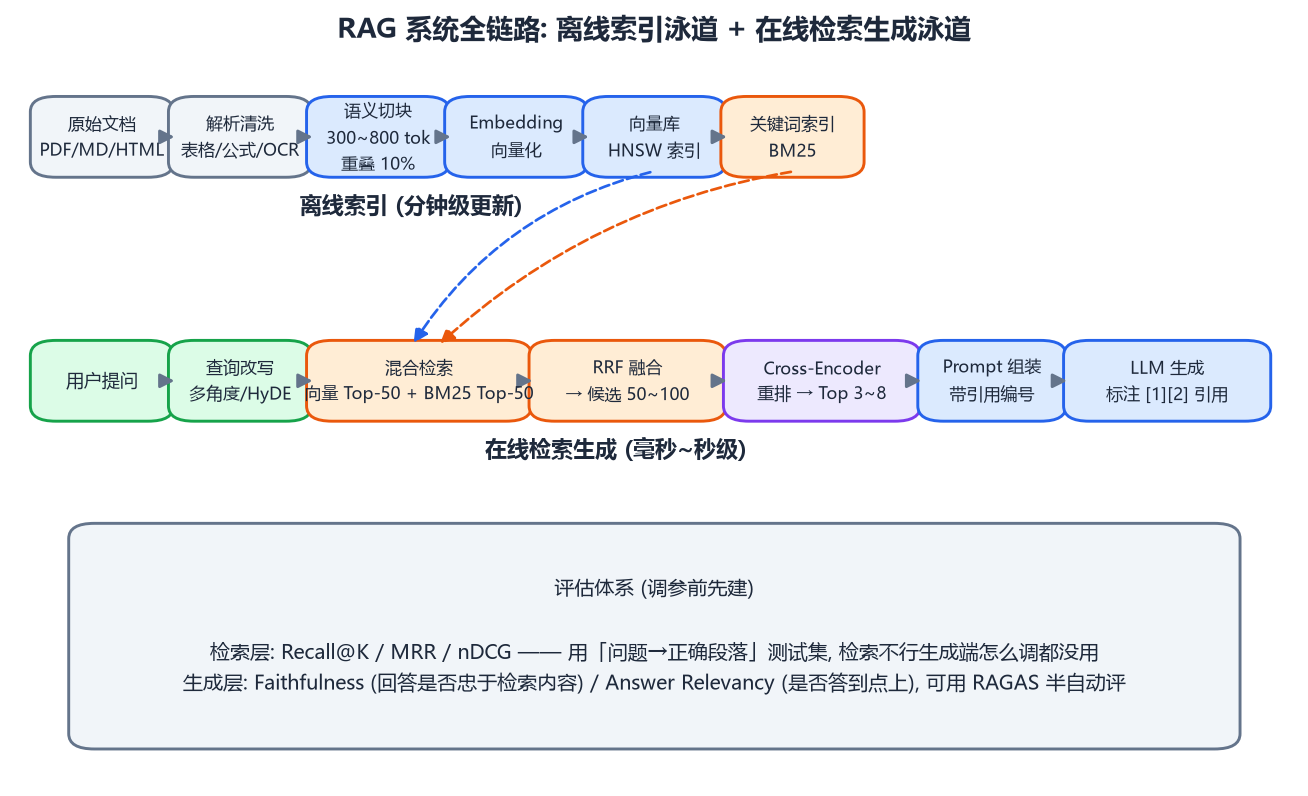
大模型的知识冻结在训练截止日,也看不到你的私有数据——公司文档、产品手册、个人笔记。微调注入知识又贵又容易幻觉。RAG(Retrieval-Augmented Generation)是当前最实用的方案:把相关文档片段检索出来塞进上下文,让模型"开卷考试"。这篇把整条链路拆到算法级:切块的边界问题、embedding 的对比学习训练、BM25 公式逐项、HNSW 的跳表式检索、RRF 融合数学、cross-encoder 重排、引用约束生成,以及 GraphRAG 与评估体系。
1. 知识注入的三条路线
| 路线 | 知识更新 | 可溯源 | 成本 | 适合 |
|---|---|---|---|---|
| 微调 | 重新训练 | 不可解释 | 高(GPU + 标注) | 教"行为/风格" |
| RAG | 重建索引(分钟级) | 可引用原文 | 中(向量库+检索) | 给"事实/知识" |
| 长上下文 | 直接贴文档 | 引用整段 | 每 token 计费 | 一次性小文档 |
三者不是互斥:用 RAG 检索 + 微调调整回答风格、长上下文兜底处理超长单文档,是常见的组合拳。判断标准一句话:知识以"更新"为主的用 RAG,能力以"怎么做"为主的用微调。
2. 切块(Chunking):检索质量的地基
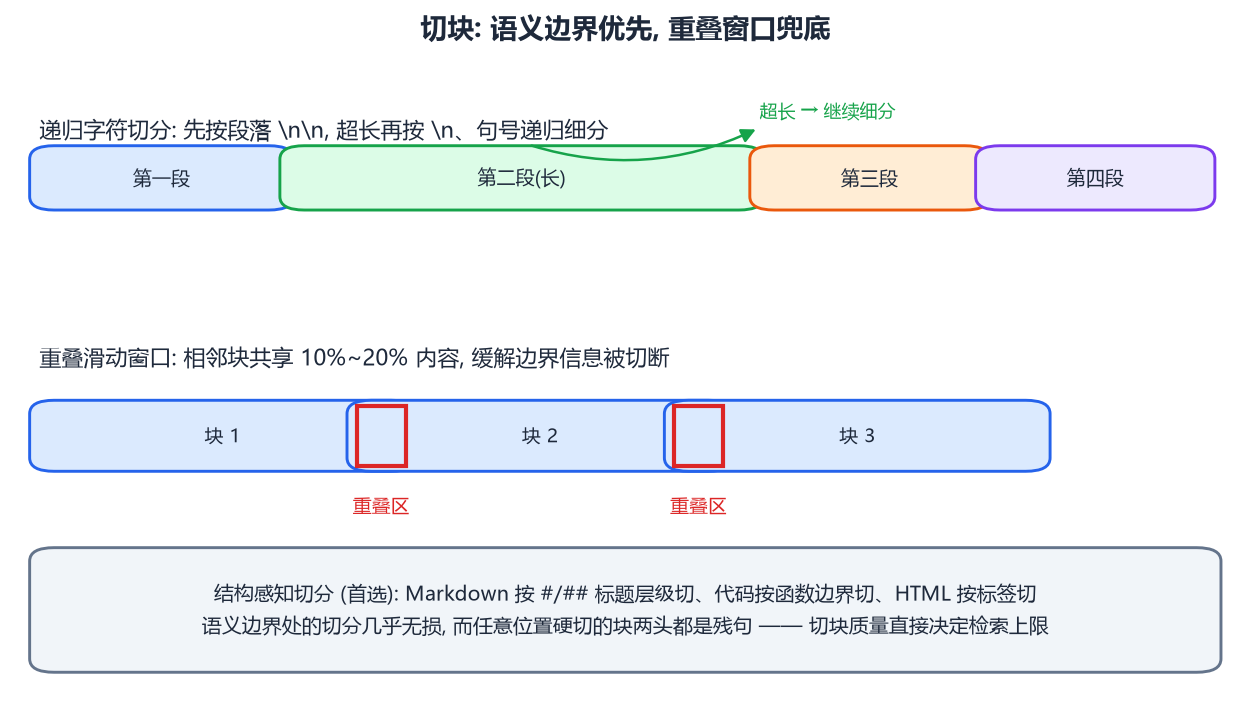
切块决定了"检索单元"的粒度,它直接设定了系统上限:
- 块太大:一个块混杂多个主题,embedding 向量是全部内容的"平均",什么都能匹配一点、什么都不精确——检索排序失真;上下文窗口也被浪费;
- 块太小:句子残缺,模型拿到片段拼不出完整语义。
工程起点参数:块 300~800 token,相邻块重叠 10%~20%(如 512 块 + 64 重叠)。重叠的意义:关键句恰好跨在边界上时,至少有一个块包含它的完整上下文。
按优先级选策略:
- 结构感知切分:Markdown 按
#/##层级、代码按函数/类边界、HTML 按标签。语义边界处切块几乎无损——有结构就用结构; - 递归字符切分:先按
\n\n(段落)切,超长的再按\n、。递归细分,最后才硬切。无结构文本的默认选择; - 重叠滑动窗口:兜底方案。
切块之后立刻做两件事:带元数据(来源文件、标题路径、页码、权限标签)——引用展示和权限过滤全靠它;小而不碎——一个块最好能独立成义(有主语、有结论),残句块的检索价值大打折扣。
进阶思路 late chunking:先让长文档过一遍 embedding 模型拿到 token 级表示、再切块池化——块向量天然带着全篇上下文,代价是实现要求模型支持长输入。
3. Embedding:向量化与它的训练方式
Embedding 模型把文本映射到稠密向量(常见 512~1024 维),语义相近 → 余弦相似度高。它不是"天生的",而是对比学习训出来的——理解训练方式才能理解它的偏好与短板:
InfoNCE 损失: 同一问题与它的正确文档为正例对,
             随机/难负例文档为负例对,
             最大化正例相似度、压低负例相似度 (温度缩放的 softmax 交叉熵)
难负例挖掘是效果的关键:用"看起来相关但答案不对"的段落(比如同一产品的不同型号章节)当负例,模型的分辨力才上得去。这解释了一个实践现象:通用 embedding 在专业领域(医疗、法律)拉不开区分度——负例分布没覆盖到你的领域,在自己的数据上微调 embedding 往往是 RAG 提效最大的单点。
选型与使用要点:
- 中文/中英混合:BGE、Qwen-Embedding、m3e;
- 非对称检索要加前缀:问题和文档是两种文体,很多模型要求给 query 加指令前缀(BGE 的"为这个句子生成表示以用于检索相关文章:"),漏了前缀召回率掉十几个点;
- MTEB 榜单只是初筛,拿自己的"问题→正确段落"对测 Recall@K 才是准的。
向量库与 HNSW 索引
百万级向量做暴力检索要 O(N·d) 次乘加,必须上近似索引。主流是 HNSW(分层可导航小世界图):
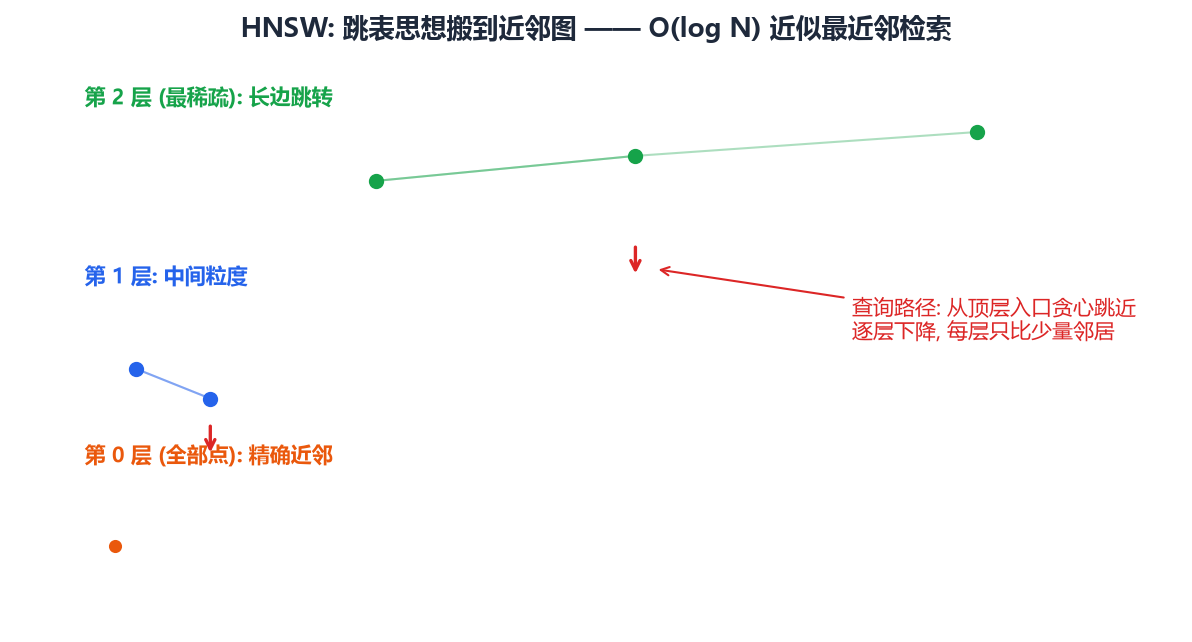
把跳表思想搬到近邻图:顶层图稀疏(长边,快速跨越)、底层图稠密(短边,精确定位)。查询从顶层入口贪心走向更近的点,无法更近就下降一层,到底层输出近邻。复杂度 O(log N),代价是建图慢、内存大(每点存 M 条邻边)。关键参数:M(每点边数,越大越准越占内存)、ef_construction(建图搜索宽度)、ef_search(查询搜索宽度——在线调精度与速度的旋钮)。Milvus/Qdrant/pgvector/FAISS 都内置了 HNSW。
4. 在线检索:BM25 与混合检索
4.1 BM25:47 年前的方法仍是向量检索的对照组
BM25 是基于词频的打分函数,对查询 Q 和文档 D:
score(Q, D) = Σ_t IDF(t) · tf(t,D)·(k₁+1) / ( tf(t,D) + k₁·(1 − b + b·|D|/avgdl) )

IDF(t)  = log((N − df(t) + 0.5) / (df(t) + 0.5))   词越稀有权重越高
tf 项   : 词频饱和 —— 出现 10 次不是 1 次的 10 倍 (k₁ 控制, 常取 1.2)
b 项    : 文档长度归一 (b=0.75, 抑制长文档靠篇幅堆分)
它至今难被完全取代的原因:精确词匹配。型号 RK3566、错误码 0x80070057、函数名 malloc_init——这些低频精确串,向量的语义空间反而容易"模糊掉",BM25 的 IDF 机制给它们极高权重。开源 RAG 评测(如 BEIR)里 BM25 至今是半数数据集上的强者。
4.2 混合检索与 RRF 融合
生产系统的标配是两路召回 + 融合。分数融合有个麻烦:余弦相似度 ∈ [−1,1]、BM25 ∈ [0, ∞),量纲不可比,加权融合要反复调权。RRF(Reciprocal Rank Fusion)绕开了分数,只用排名:
score(d) = Σ_r 1 / (k + rank_r(d)), k ≈ 60
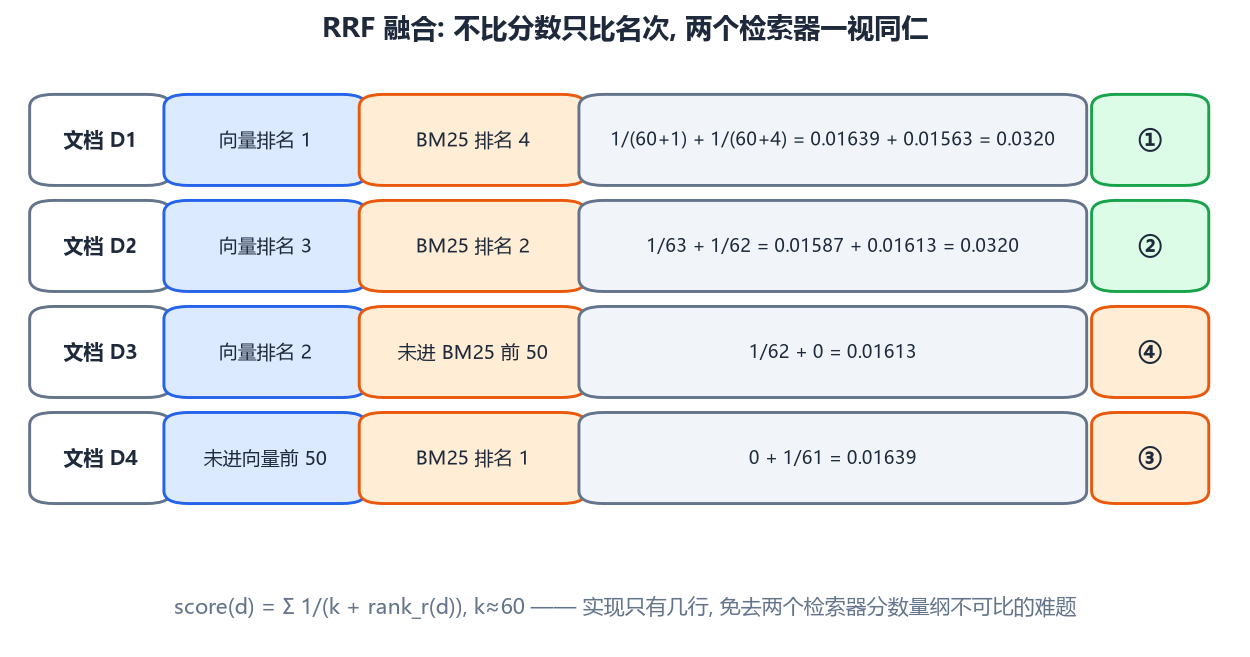
实现几行、无需调参、对异常排名鲁棒——两路各取 Top-50,RRF 融合去重后交给重排。向量语义泛化 + BM25 精确打击,互补性极强。
4.3 查询改写
用户的问题往往不是好的检索 query:
- 多查询改写:让 LLM 生成 2~3 个不同角度的改写,分别检索再融合——覆盖面换成本;
- HyDE:先让 LLM 生成一段"假设性答案",用它去做向量检索。原理:问题(短、疑问句)与文档(长、陈述句)文体不对称,而"假设答案"与正确文档文体一致,向量空间里更近;
- 对话改写:多轮对话里把"那怎么配置?"补全成独立完整的查询("K8s 的 Service 怎么配置?"),否则检索拿到的指代残句什么都查不到。
5. 重排:漏斗的最后一层
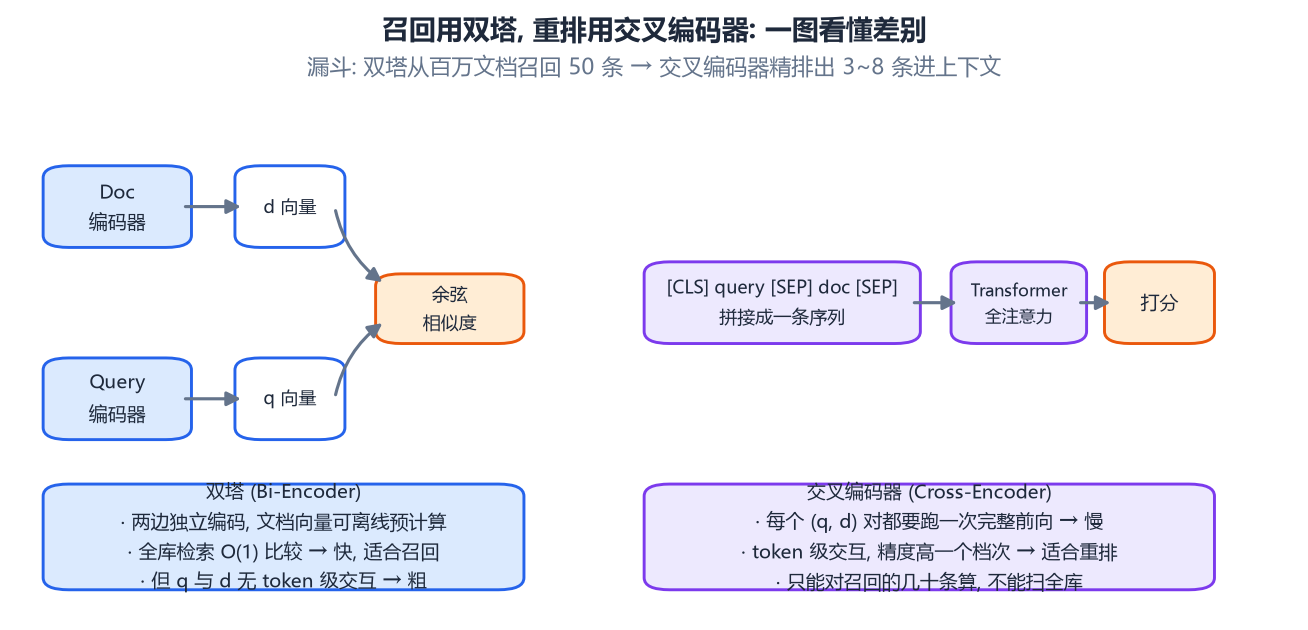
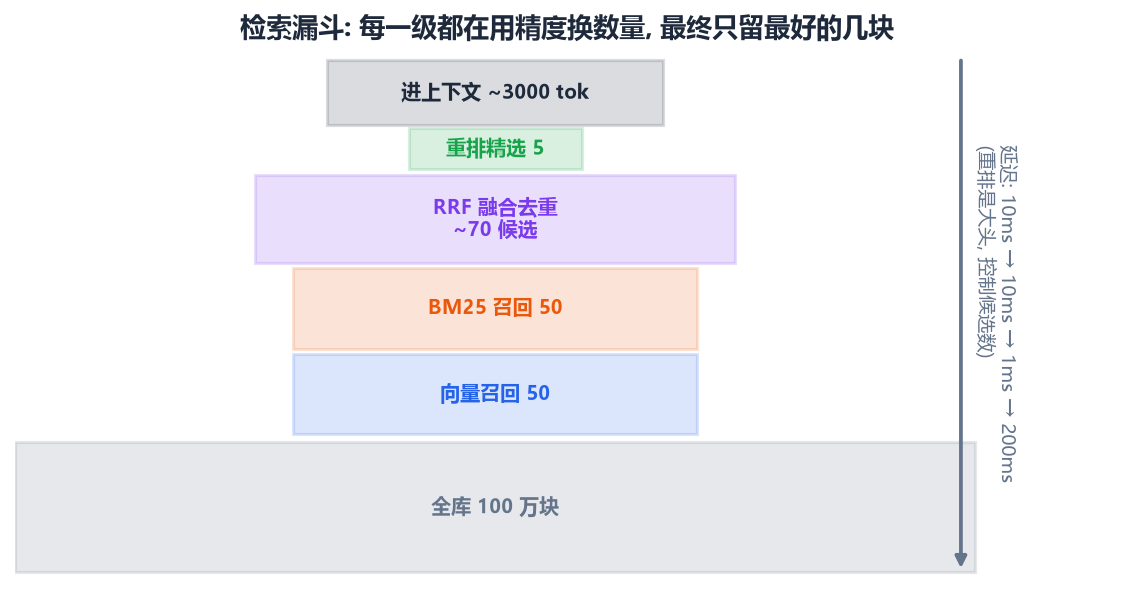
召回(双塔)为了快牺牲精度:query 和文档独立编码,只能在最后算一次余弦——两者的交互被压缩到点积一个数。重排(cross-encoder)把 (query, doc) 拼成一条序列过 Transformer,每个 token 看得见彼此,交互发生在每一层注意力里——精度高一个档次,但每个候选对都要跑一次完整前向,只能用于几十条候选。
于是两级漏斗定型:召回 50~100(毫秒级)→ 重排留 3~8(百毫秒级)。加上 cross-encoder 重排,端到端命中率的提升普遍 5~15 个百分点,是 RAG 里投入产出比最高的组件。开源用 BGE-reranker(可中文微调),商用 Cohere Rerank;预算紧张时可以蒸馏一个小重排模型。
6. 生成:把检索结果变成可信回答
Prompt 模板的核心结构:
请根据以下参考资料回答问题。若资料不足以回答, 请明确说明"根据现有资料无法回答", 不要编造。

[1] {chunk_1}
[2] {chunk_2}
[3] {chunk_3}

问题: {query}
要求: 回答中标注引用来源 (如 [1][2]); 与资料冲突的内容不要输出。
四个关键约束:
- "不足以回答就说无法回答"——显式给模型"认输"的出口,是压幻觉的第一道闸;
- 引用编号既方便用户核对,也倒逼模型贴着资料说话——生成时注意力有明确锚点;
- temperature 压到 0.1~0.3——RAG 要忠实不要发散;
- 拒答率是健康指标:RAG 系统永远答问题的能力反而危险,"查无此料"的诚实回复占比应保持合理水平。
7. 进阶架构
- 父块检索:用小块(精确)检索,返回大块(完整上下文)给 LLM——检索精度与生成上下文兼得;
- RAPTOR:对文档做层次化摘要树,不同粒度的节点都进索引——细节问题查叶子、综述问题查上层;
- GraphRAG:用 LLM 抽取实体与关系建知识图谱 + 社区层级摘要,检索沿图扩展——擅长"跨文档综合"的全局性问题("这批投诉的共同根因是什么"),构建成本高,按需引入;
- Agentic RAG:把检索变成 Agent 的一个工具(见下一篇),模型自己决定查什么、查几轮、何时停止——多跳问题("A 的竞争对手的 CEO 是谁")的正确率显著高于一次性检索。
8. 评估:没有度量的优化都是玄学
- 检索层:标注 100~500 条"问题 → 正确段落",算 Recall@K(前 K 里有没有正确块——地基指标,K 取进上下文的数量)、MRR(正确块排名的倒数均值)、nDCG(带位置折损的排序质量);
- 生成层:Faithfulness(回答的每个论断能否被检索内容支持——RAGAS 用 LLM 分解论断再逐条核对)、Answer Relevancy(回答与问题的相关度);
- 端到端:人工标注小样本 + LLM-as-judge 批量评,双轨校准。
排障顺序永远是:先查检索(Recall 不行就别动生成端)→ 再查重排 → 再调 prompt。实践中六成的"RAG 幻觉"其实是检索没召回正确块,模型在拿错误资料硬答。
9. 小结
- 切块按语义边界、带元数据、重叠兜底,块的质量决定系统上限;
- embedding 靠对比学习训练,难负例决定领域分辨力,非对称检索记得加前缀;HNSW 用分层图实现 O(log N) 检索;
- BM25 的精确词匹配与向量语义互补,RRF 只用排名就完成无量纲融合;
- cross-encoder 重排是性价比之王,漏斗"召回 100 → 重排 5"是标准形;
- 引用约束 + 低温 + 认输出口压幻觉;先建评估集再调参,检索层永远优先于生成层排查。
最后一篇:把模型从"开卷答题"升级为"动手干活"——Agent 的循环、记忆、编排与安全。