
嵌入式 Linux 内核与驱动全栈解析:从启动到并发同步
这是「嵌入式 Linux 内核与驱动」系列的合并长文,五部分按"代码何时运行 → 如何被发现 → 事件如何进来 → 数据如何存放 → 并发如何自洽"组织:启动流程 → 设备模型与设备树 → 中断子系统 → 内存管理 → 并发与同步。每部分配图齐全,中断与内存两篇各含一个交互组件(机制选择器、页表翻译步进器),建议边读边动手。适合有字符设备驱动基础、想向内核机制深入的读者。
第一部分 · 内核启动与驱动加载全流程
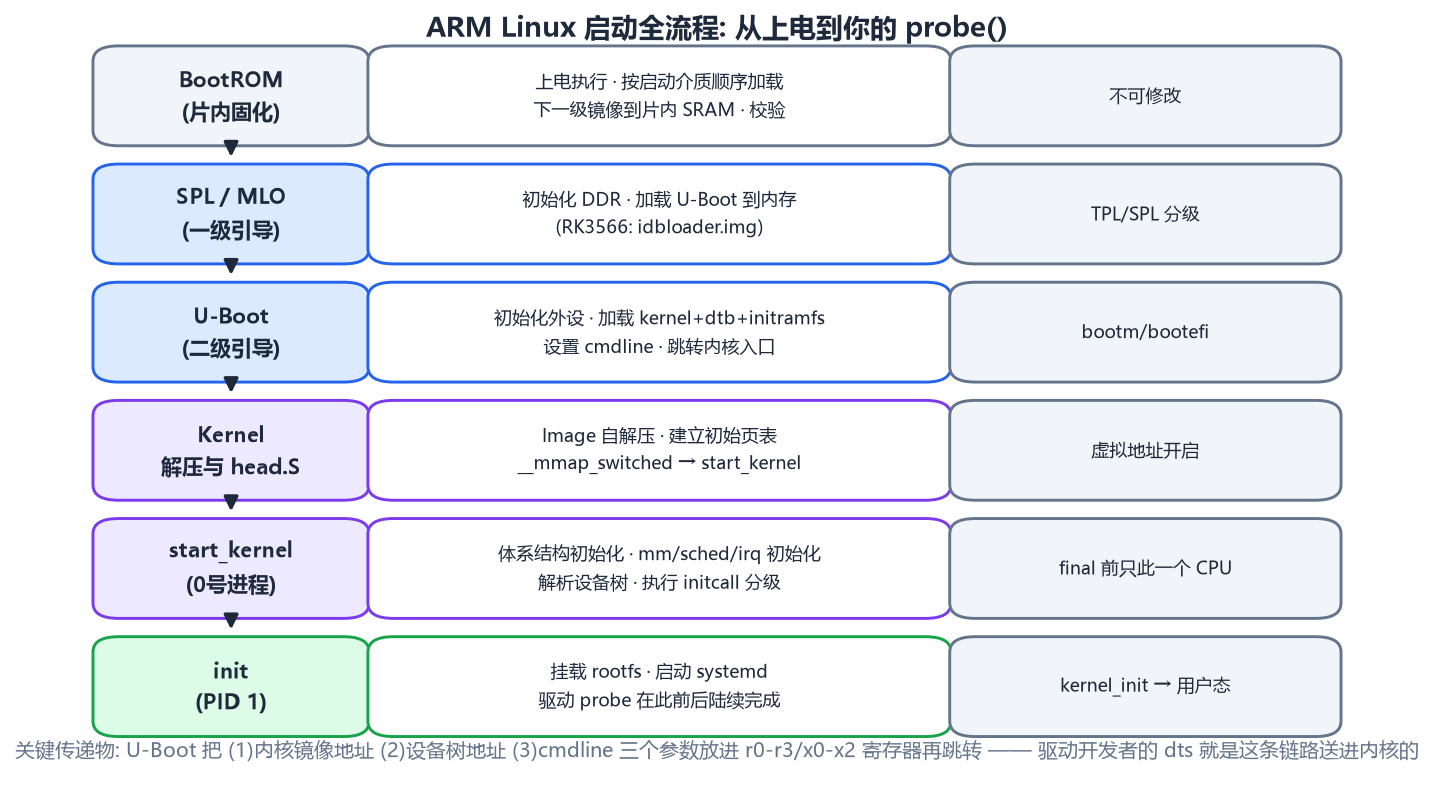
这是「嵌入式 Linux 内核与驱动」系列的第一篇。写驱动的第一课往往从 module_init 和 probe 开始,但很多人写了几年驱动,仍说不清从按下电源到你的 probe() 被调用之间到底发生了什么。这条链路恰恰是嵌入式工程师排障能力分水岭:镜像为什么没起来、设备为什么没 probe、时钟为什么没就绪——答案全在启动流程里。这篇从 Reset 向量一路追到 do_initcalls(),把每一环的机制与调试入口讲透。
1. BootROM 与 SPL:信任链的第一环
上电瞬间 CPU 从硬件固定的 Reset 向量取指(ARM64 是 0x0000_0000 片内映射),执行的是芯片出厂固化的 BootROM。它的行为模式对驱动工程师很重要,因为你烧录的镜像必须顺着它的规则摆放:
- 按烧写的启动介质顺序(eMMC/SPI Nor/SD/USB)逐个尝试,读出固定偏移处的头部(RK 系列在 0x40 扇区附近是
idbloader,i.MX 是 IVT 表,Allwinner 是 eGON); - 校验头部里的加载地址与长度,把下一级镜像搬进片内 SRAM(注意:此时 DDR 还没初始化,能用的只有几十~几百 KB SRAM);
- 镜像太大塞不下?所以引入 SPL(Second Program Loader):BootROM 只加载一个小巧的 SPL,SPL 负责初始化 DDR,再加载真正的主引导。RK3566 上
idbloader.img = SPL + TPL,U-Boot 的make rk3566_defconfig产物链就是为这套流程准备的。
调试入口:这一段出问题的现象是"串口一字不出"。手段:BootROM 大多有错误闪烁码或 maskrom 模式(RK 的 Loader / MaskRom 按键),短路 BOOT 引脚可强制进 USB 下载模式——救砖靠的就是 BootROM 里这段固化逻辑。
2. U-Boot:最后一次"裸机"决策
U-Boot 是我们可控的第一级"操作系统级"软件,它做了三件与驱动直接相关的事:
- 初始化外设:串口(你的 console 就来自它)、eMMC/SD、网络(TFTP 救命用)、显示 logo;
- 组装启动参数:
bootcmd里load内核与设备树,bootargs里写console=ttyFIQ0 root=/dev/mmcblk1p6 ...; - 交接给内核:
booti <kernel_addr> <dtb_addr> <initrd_addr> <cmdline>。
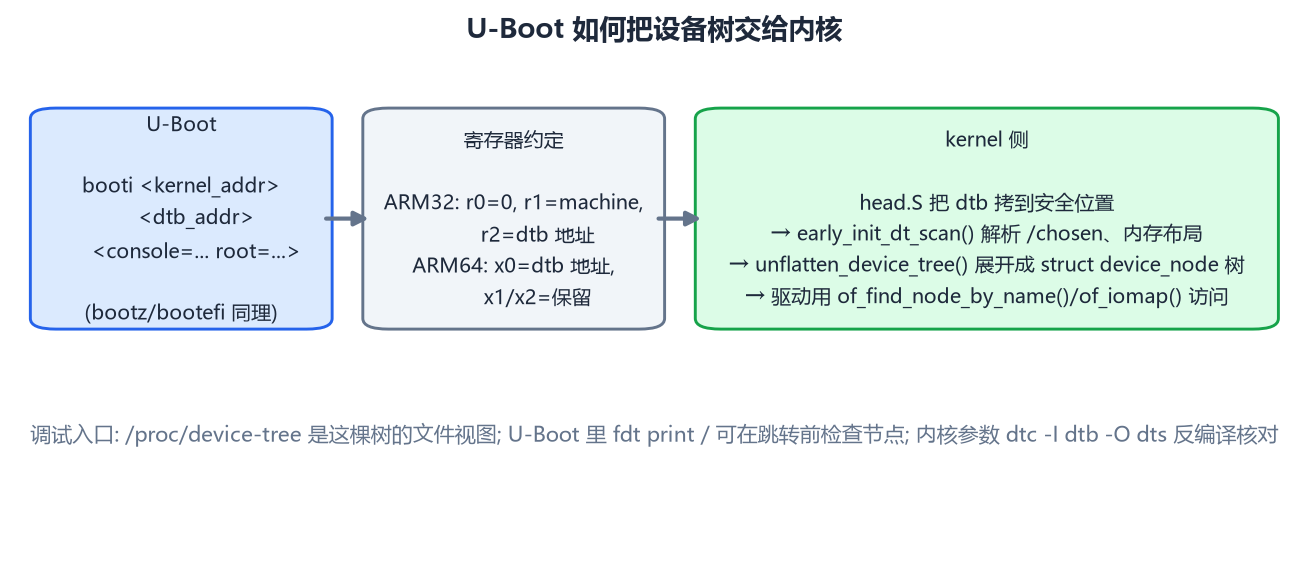
为什么 dtb 地址必须显式传:内核不会自己"找"设备树,U-Boot 按架构 ABI 把地址放进寄存器(ARM64 的 x0)再跳转。这也解释了一个常见坑:换了设备树文件但内核没变化、设备行为却没变——往往 dtb 没重新打包进 boot 分区(RK 的 resource.img / Android bootimg 的 second 区),跑的还是旧的。
调试入口:fdt print /i2c1(跳转前核对节点)、bdinfo(内存布局)、booti 前打印地址。U-Boot 阶段卡死的常见原因:bootargs 的 console 设备名错、root 分区号错(rootwait 救急)。
3. 内核自举:head.S 到 start_kernel
内核入口(Image 头部)的第一段汇编做的是"从裸机到 C 语言世界"的基建:
1. 自解压 (压缩镜像: decompress_kernel)
2. 建立 identity 映射 + 内核虚拟地址映射的初始页表 (idmap_pg_dir / init_pg_dir)
3. 开启 MMU, 跳到虚拟地址执行 (__mmap_switched)
4. 清 bss、保存 dtb 指针、设置栈, 跳转 start_kernel (C)
这一段最值得记的知识点:内核从此跑在虚拟地址上,而你驱动的所有寄存器访问(ioremap)与内存分配(kmalloc)都建立在这套页表之上——系列的内存篇会回到这里。
start_kernel() 是"内核的 main()",它完成体系结构初始化(setup_arch 解析设备树与内存布局)、中断/调度/内存子系统初始化,最后走到与驱动最相关的两步:machine_init/arch_initcall 阶段的总线注册,和 do_initcalls()。
4. initcall 分级:你的驱动排第几
内核用链接器段(__initcall_start ~ __initcall_end)把所有初始化函数按重要级排好,do_initcalls() 顺序执行:
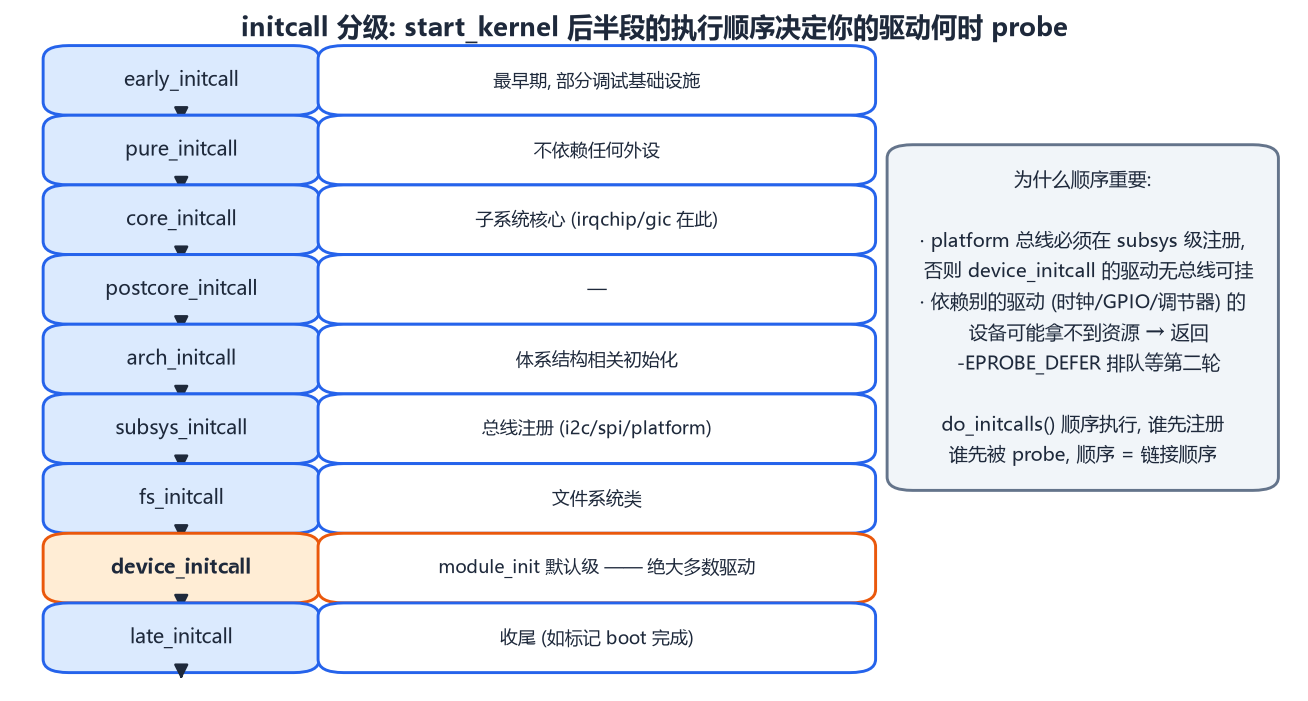
| 宏 | 时机 | 典型住户 |
|---|---|---|
early_initcall |
极早,调试基础设施 | 早期 printk |
core_initcall |
核心子系统 | irqchip(GIC 驱动)、pinctrl |
subsys_initcall |
总线注册 | i2c/spi/platform 总线本身 |
device_initcall |
默认级(=module_init) |
绝大多数外设驱动 |
late_initcall |
收尾 | deferred probe 最终重试 |
顺序为什么是驱动工程师的事:你的摄像头驱动(device_initcall)probe 时要拿 I2C 适配器、时钟、调节器——它们都必须已注册。总线注册在 subsys_initcall,所以你的驱动一定晚于它,这是内核替你保证的"静态顺序"。
调试入口:initcall_debug 内核参数——initcall_debug=1 会在串口打印每个 initcall 的名字与耗时("initcall xxx+0x0 returned 0 after 15 usecs"),慢驱动/卡死的驱动一眼可见;配合 ftrace=function_graph 能抓到完整调用图。
5. 设备驱动的匹配与 deferred probe
device_initcall 阶段,platform 总线对每个 (device, driver) 组合调用 bus->match()——设备树的 compatible 与驱动的 of_match_table 比对(细节在第二篇)。匹配成功就 probe。但probe 不是保证成功的:依赖未就绪时返回 -EPROBE_DEFER:
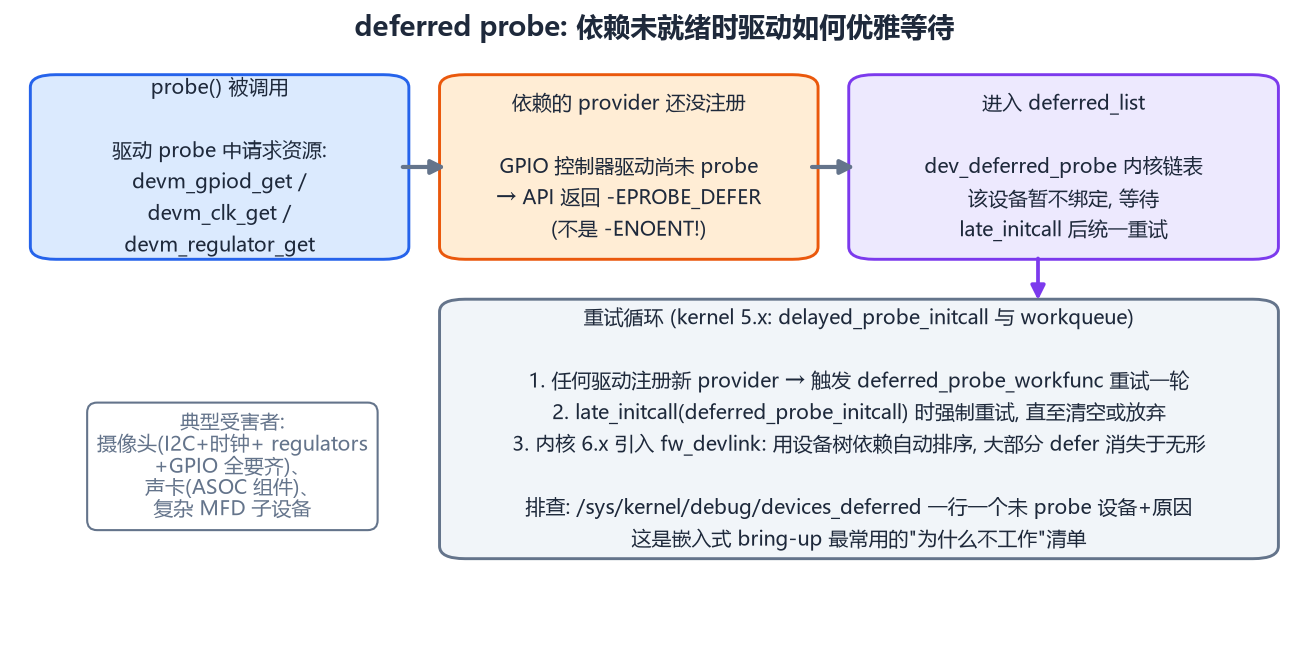
这个机制值得逐字理解,因为嵌入式 bring-up 一半的时间耗在这里:
static int ov5695_probe(struct i2c_client *client)
{
    struct clk *xvclk = devm_clk_get(&client->dev, "xvclk");
    if (IS_ERR(xvclk)) {
        if (PTR_ERR(xvclk) == -EPROBE_DEFER)   /* 时钟 provider 还没就绪 */
            return -EPROBE_DEFER;               /* 让内核晚点再试我 */
        ...
    }
}
- 只有"依赖存在但未就绪"才返回
-EPROBE_DEFER;写错成-ENODEV内核就永远不再重试——这是新手驱动"时灵时不灵"的头号原因(取决于链接顺序/注册顺序的偶然性); - 排查命令:
cat /sys/kernel/debug/devices_deferred,一行一个"哪个设备在等什么"; - 内核 6.x 的 fw_devlink 会根据设备树的 phandle 依赖自动排出 probe 顺序(supplier→consumer),大部分 defer 直接消失——但理解机制仍必要,因为旧内核与动态注册(USB/热插拔)场景仍靠它。
6. PID 1 与用户态:驱动的"下半场"
start_kernel 末尾 kernel_init 解压执行 /sbin/init(systemd 或 BusyBox init),挂载 rootfs、按 target 启动服务。对驱动工程师,用户态带来的增量问题有三个:
- 模块加载时序:
insmod的模块晚于全部内建驱动,等价于"最晚的 initcall";模块依赖用modprobe解析; - udev/mdev 生成
/dev节点:driver core 发 uevent,用户态按规则创建设备文件——/dev里没有你的节点,先查 uevent 与规则,而不是怪驱动; - 启动耗时优化:
systemd-analyze blame / critical-chain定位用户态慢服务;initcall_debug + initcall_blacklist=定位内核态慢驱动。
7. 把启动链装进调试工具箱
一张排障速查表收尾:
| 现象 | 停在哪 | 工具 |
|---|---|---|
| 串口无输出 | BootROM/SPL | maskrom 短接、示波器看启动介质 |
| 只打印 U-Boot 前段 | DRAM 初始化 | 调小 DDR 频率重试 |
| 卡在 "Starting kernel..." | 内核没起来 | booti 参数、console= 设备名、dtb 地址 |
| 起到一半 panic | early 阶段 | earlycon / earlyprintk(要在 cmdline 与 dtb 的 chosen 里配好) |
| 起来了但设备缺 | probe 问题 | /sys/kernel/debug/devices_deferred、initcall_debug |
| probe 了但异常 | 资源/时序 | devres、regmap dump、逻辑分析仪 |
8. 小结
- 启动 = BootROM(固定逻辑)→ SPL(初始化 DDR)→ U-Boot(组装参数与 dtb)→ head.S(建页表开 MMU)→
start_kernel(子系统)→do_initcalls(按级跑驱动)→ init(用户态); - dtb 由 U-Boot 按 ABI 传入内核,是驱动看到硬件世界的唯一来源;
- initcall 分级保证"总线先于设备"的静态顺序;跨级依赖交给
-EPROBE_DEFER与 fw_devlink; initcall_debug、devices_deferred、earlycon是这条链上的三把钥匙。
下一篇深入驱动模型的核心:内核用什么数据结构装下"设备与驱动",设备树如何成为它们的户口本。
第二部分 · 设备模型与设备树
系列第二篇。第一篇讲到"匹配成功就 probe",这一篇拆开那个"匹配"——内核的设备模型(device model)是整个驱动框架的地基:probe/remove、热插拔、电源管理、sysfs、引用计数全部长在它上面。同时把设备树(Device Tree)从语法讲到 of API,看清硬件描述如何变成 struct device。理解这一篇,读任何子系统的驱动框架(I2C/SPI/PCI/USB)都会快一个数量级——因为它们的骨架完全同构。
1. 三角关系:bus、device、driver
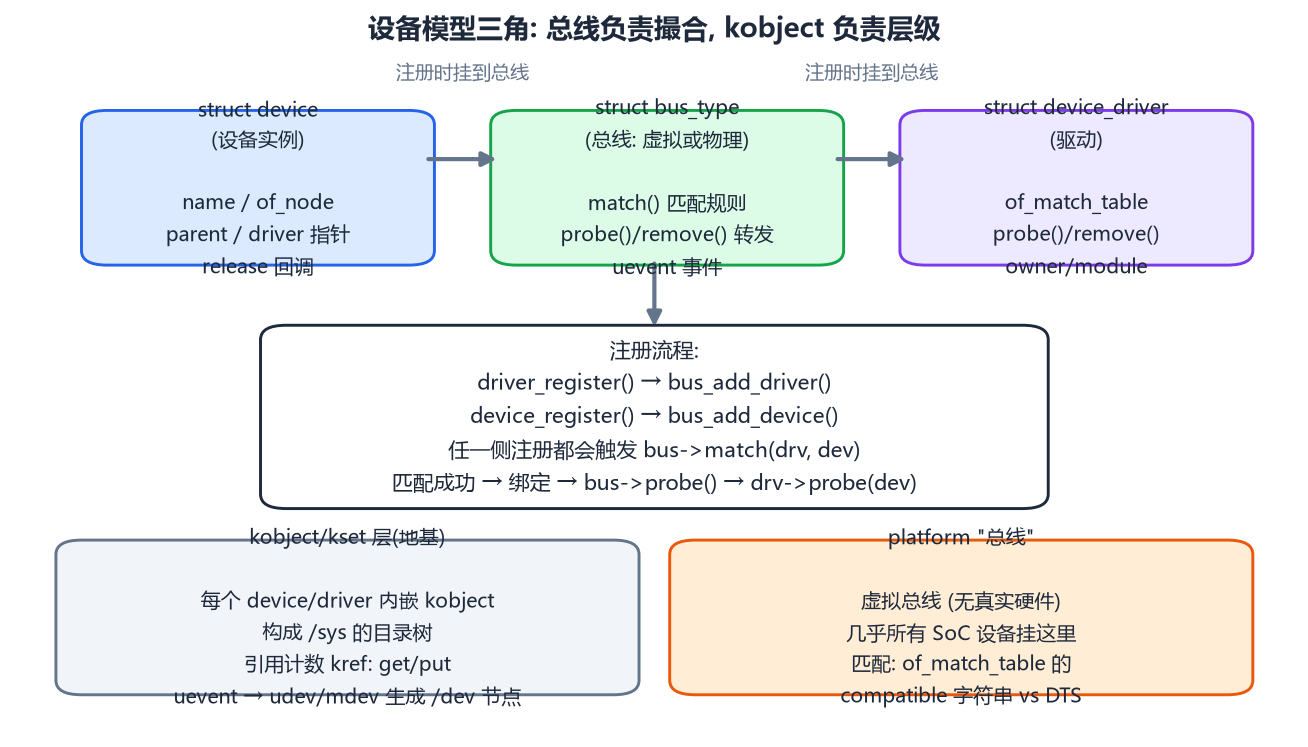
内核用三个结构体描述驱动世界的全部角色:
struct bus_type:撮合者。物理总线(I2C/SPI/PCI/USB)与虚拟总线(platform)都是它,持有match()/probe()/uevent回调;struct device:一个设备实例。内嵌of_node(设备树节点)、parent(层级)、driver(绑定者);struct device_driver:一份驱动。持有of_match_table、probe()/remove()、owner。
注册的任何一侧都会触发总线的撮合循环:driver_register() 或 device_register() → bus->match(dev, drv) → 匹配则绑定 → bus->probe()(转发给 drv->probe(dev))。这个三角是所有总线型子系统的同构骨架:I2C 的 i2c_driver、SPI 的 spi_driver、USB 的 usb_driver 全是"device_driver + 总线特化字段"的包装,probe 流程一模一样。
1.1 platform 总线:SoC 世界的收容所
片上设备(UART 控制器、GPIO、watchdog)不插在任何可枚举总线上——芯片设计里它们直接挂在总线矩阵上。内核为它们造了虚拟的 platform 总线:设备来自设备树(或老的 platform_device 注册),驱动用 platform_driver 注册,匹配规则就是 compatible 字符串。写 SoC 驱动 90% 时间在和 platform 打交道。
2. 匹配的优先级链
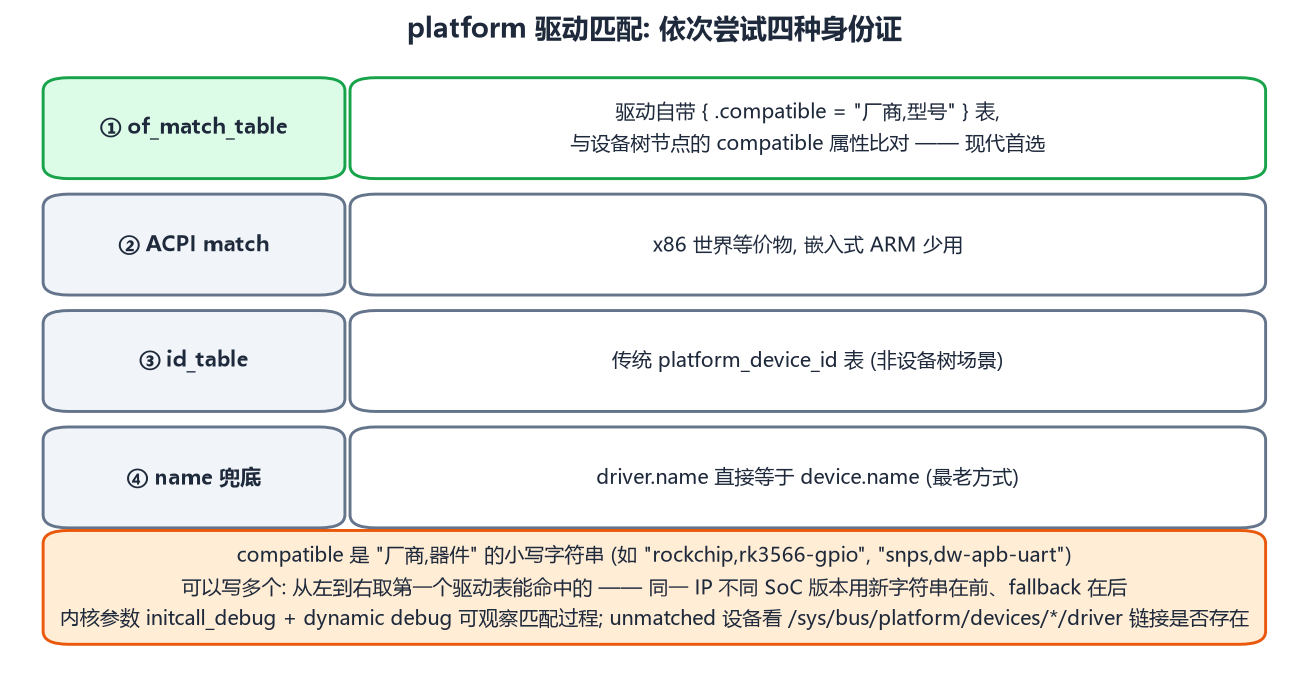
platform 总线的 match() 依次尝试:
static int platform_match(struct device *dev, struct device_driver *drv)
{
    /* ① 驱动的 of_match_table vs 设备树 compatible —— 现代 99% */
    if (of_driver_match_device(dev, drv))  return 1;
    /* ② ACPI(x86 世界) */
    if (acpi_driver_match_device(dev, drv)) return 1;
    /* ③ 传统 id_table */
    if (platform_match_id(pdrv->id_table, pdev) != NULL) return 1;
    /* ④ 名字兜底 */
    return (strcmp(pdev->name, drv->name) == 0);
}
compatible 的书写纪律值得单独强调:"厂商,具体型号" 全小写,且设备树里可写多个、从左到右匹配第一个命中的驱动表项——同一 IP 的不同 SoC 版本把新字符串放前面、通用 fallback(如 "snps,dw-apb-uart")放后面,是芯片厂 BSP 的标准手法。
3. 设备树:硬件的户口本
设备树是描述硬件拓扑的数据结构(DTB 格式),只描述"有什么硬件、接在哪、参数多少",不含任何驱动逻辑。同一份内核镜像配不同 dtb 就能跑不同板子——这就是引入它替代 arch/arm/mach-xxx/board-*.c 硬编码的原因。
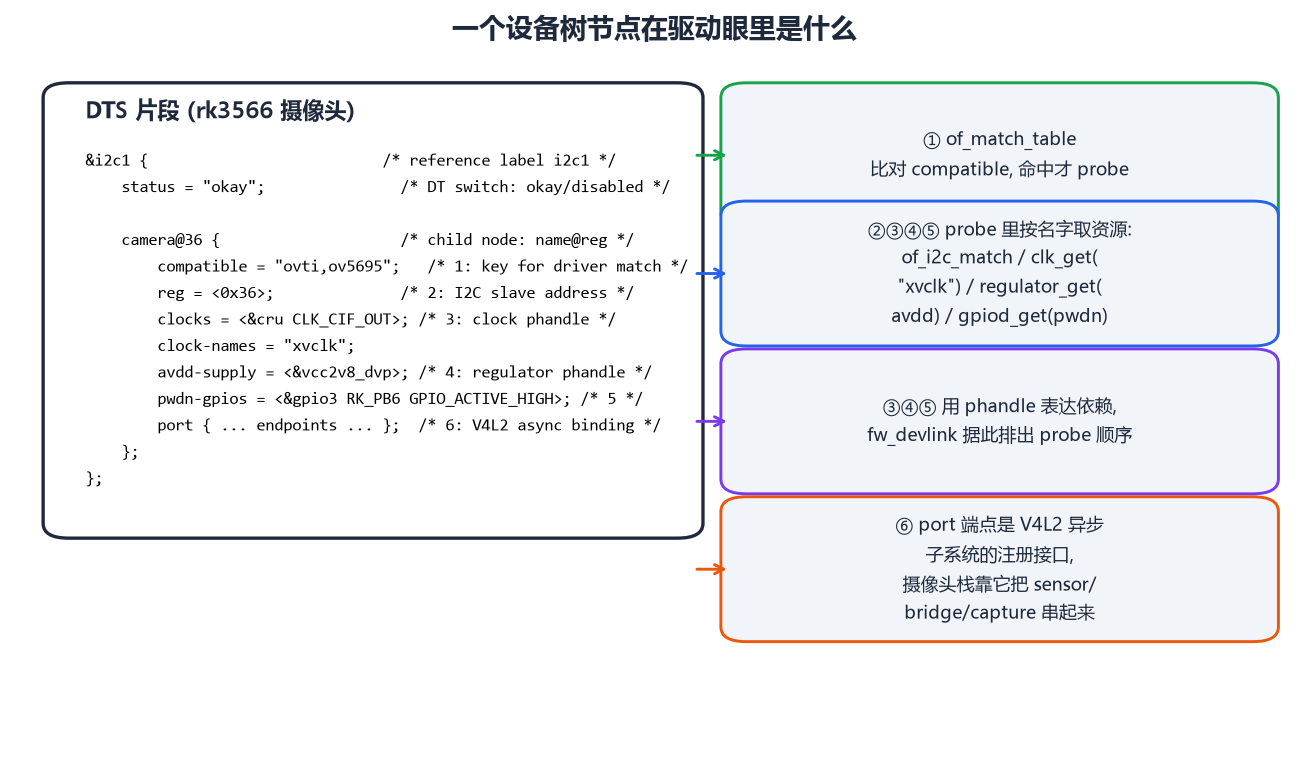
一个 RK3566 摄像头节点几乎是"驱动资源清单"的镜像,probe 里每行代码都能对回一个属性:
static int ov5695_probe(struct i2c_client *client)
{
    struct device *dev = &client->dev;
    struct clk *xvclk = devm_clk_get(dev, "xvclk");        /* ← clock-names */
    struct regulator *avdd = devm_regulator_get(dev, "avdd"); /* ← avdd-supply */
    struct gpio_desc *pwdn = devm_gpiod_get(dev, "pwdn", GPIOD_OUT_LOW); /* ← pwdn-gpios */
    u32 val;
    of_property_read_u32(dev->of_node, "rockchip,camera-module-index", &val); /* ← 自定义属性 */
    ...
}
三条工程纪律:
- phandle 是设备树里的"指针":
clocks = <&cru CLK_CIF_OUT>引用另一个节点,内核展开后 fw_devlink 据此建依赖(cru 必须先 probe)——第一篇的 deferred probe 就消化在这里; status = "okay"/"disabled"是免费开关:同一 SoC 的参考 dtb 把不用的外设全部 disabled,量产裁剪首选手段;- 调三板斧:U-Boot
fdt print、运行时/proc/device-tree(属性即文件)、宿主机dtc -I dtb -O dts rk3566.dtb反编译核对。设备树与驱动版本错配(改了 dts 没重编 dtb,或 dtb 没进 boot 包)是"看起来都对就是不工作"的经典。
3.1 pinctrl:引脚复用的归属
一个 GPIO 引脚同时可能是 UART_TX、I2C_SCL、GPIO——SoC 用 pinmux 寄存器选择。pinctrl 子系统把"某设备用哪组引脚、哪种功能"也写进设备树:
&uart2 {
    pinctrl-names = "default";
    pinctrl-0 = <&uart2m0_xfer>;   /* 复用组: 引脚 + 功能 + 上下拉配置 */
    status = "okay";
};
probe 时 pinctrl 核心自动应用该组配置。常见坑:两个节点(手写 GPIO 蹩脚 + 复用组)抢同一引脚,后 probe 的改写前者的配置——症状是"UART 偶尔变高阻"。cat /sys/kernel/debug/pinctrl/pinctrl-rockchip-pinctrl/pinmux-pins 可看每个引脚当前的属主。
4. kobject 与 sysfs:模型在用户态的投影
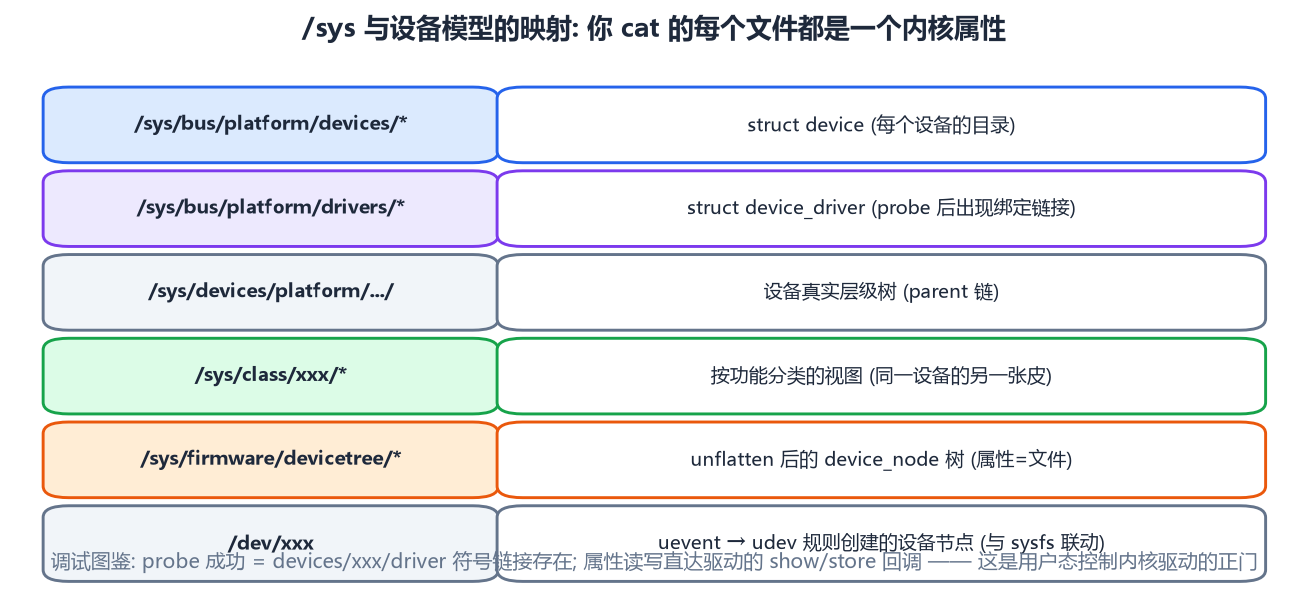
每个 device/driver 内嵌 struct kobject,所有 kobject 组成层级树,直接映射为 /sys 的目录结构;驱动可声明 attribute,变成 sysfs 里的文件——cat/echo 直达驱动的 show()/store() 回调。这是用户态控制内核驱动的正门(亮度、使能、调试开关都走它),比 ioctl 透明、可脚本化。
同一条 uevent 机制也是 /dev 节点的来源:设备注册 → 内核发 KOBJ_ADD uevent → udev/mdev 按规则创建设备文件。udevadm info -a /dev/video0 能看到从设备到总线的完整属性链——排查"设备文件没生成"的第一现场。
5. 生命周期:引用计数与 devm 家族
设备模型的另一半是生命周期管理。kobject 自带引用计数(get_device/put_device),最后一个 put 触发 release()。但驱动开发者更应该用devres(设备资源管理)——devm_ 前缀的分配函数把资源绑定到设备:
static int foo_probe(struct platform_device *pdev)
{
    struct clk *clk = devm_clk_get(&pdev->dev, NULL);       /* 自动释放 */
    void __iomem *base = devm_platform_ioremap_resource(pdev, 0); /* 自动 iounmap */
    int irq = platform_get_irq(pdev, 0);
    int ret = devm_request_irq(&pdev->dev, irq, foo_isr, 0, "foo", priv); /* 自动 free_irq */
    ...
    return 0;   /* 失败路径不需要 goto err 一路解锁 —— devm 自动回收 */
}
probe 失败或设备移除(remove()/unbind)时,devres 按注册逆序自动释放。新代码应默认全 devm——老式"goto err_unmap_clk..."的五段式错误处理在现代驱动里几乎绝迹。
一个必须懂的坑:probe 成功后,设备仍可能被热移除(USB、可卸载模块、DTS overlay)。任何跨中断/进程上下文持有设备指针的代码都要 get_device() 钉住引用,否则 use-after-free 的 oops 会在最不该来的时刻出现。
6. 把模型装进排障工具箱
| 问题 | 一眼定位 |
|---|---|
| 驱动匹配了吗 | ls -l /sys/bus/platform/devices/xxx/driver(符号链接在=绑定了) |
| 设备树节点对吗 | ls /proc/device-tree/i2c1/camera@36/、cat compatible |
| 为什么没 probe | cat /sys/kernel/debug/devices_deferred |
| 引脚被谁占了 | cat /sys/kernel/debug/pinctrl/*/pinmux-pins |
| uevent 发了吗 | udevadm monitor 现场观察 add 事件 |
| 想手工绑定/解绑 | echo drv > .../driver/bind / unbind(不用重启测 probe) |
7. 小结
- bus/device/driver 三角是全部总线子系统的同构骨架,platform 是 SoC 设备的虚拟收容所;
- 匹配优先级 of_match_table → ACPI → id_table → name;compatible 的书写与多值 fallback 是芯片厂与板级工程师的共同纪律;
- 设备树属性与 probe 代码一一对应,phandle 表达依赖、fw_devlink 排序、status 裁剪三板斧必备;
- kobject 层把模型投影成 sysfs,uevent 联动 udev 生成 /dev;
- 生命周期交给 devm 家族;热移除场景必须显式持引用。
下一篇讲把硬件事件送进内核的通道:中断子系统,从 GIC 硬件一路到 request_threaded_irq。
第三部分 · 中断子系统全解
系列第三篇:中断子系统。驱动的核心职责之一是"硬件喊我时必须到"——但从设备拉高中断线到你的处理函数跑起来,中间隔着中断控制器、翻译层、流控、调度策略整整一条链。这篇从 GIC 硬件讲到 request_irq 的软件路径,再彻底讲清"上半部/下半部"的选型纪律(配一个交互式选择器),最后给出中断风暴与实时性的工程对策。
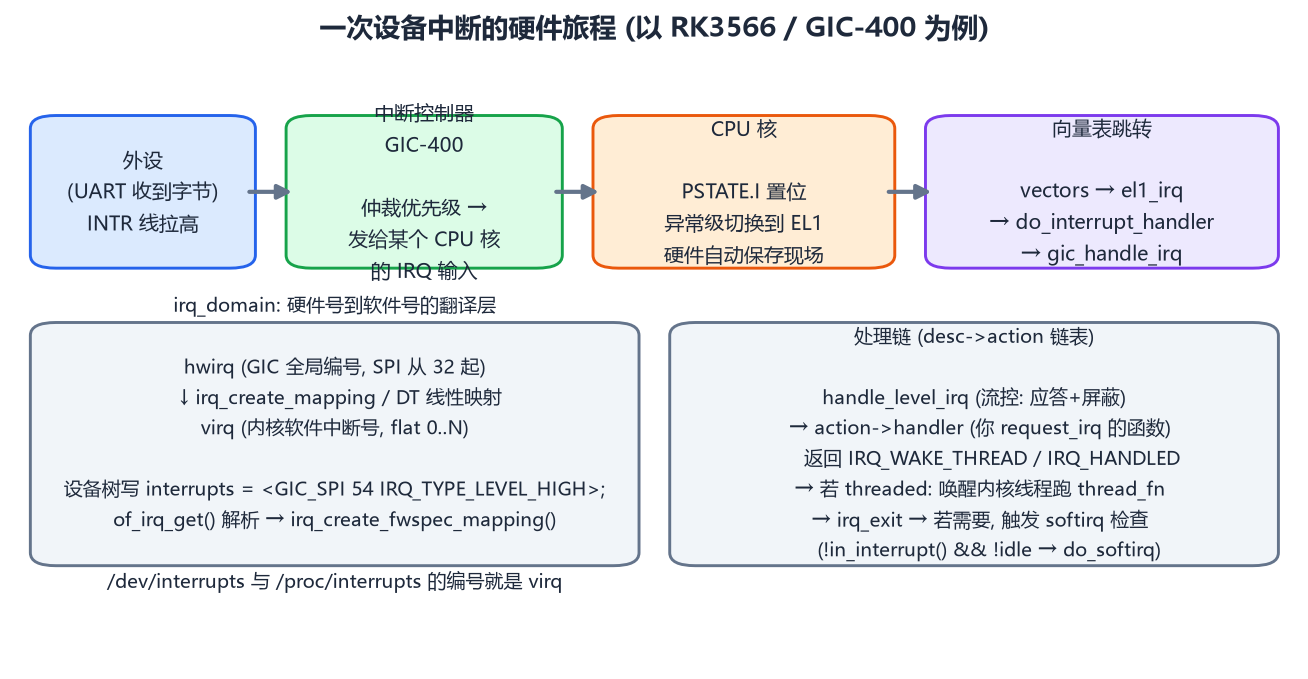
1. 硬件侧:信号如何变成"异常"
以 RK3566 的 GIC-400(GICv2)为例:
- 外设事件 → 中断线(对 GIC 是 SPI,共享外设中断,编号从 32 起;每核私有的是 SGI/PPI);
- GIC 仲裁:按优先级分发到某个 CPU 核的 IRQ 输入(亲和性由内核
irq_set_affinity设置); - CPU 硬件自动行为:PSTATE.I 置位(关中断)、切换到 EL1 异常级、跳到异常向量表的
el1_irq槽位——这是 ARM64 硬件写死的入口。
电平触发 vs 边沿触发(设备树里 IRQ_TYPE_LEVEL_HIGH / IRQ_TYPE_EDGE_RISING)不只是属性字符串:电平型在 handler 应答(EOI)前 GIC 会持续压制同线新中断,必须先清设备侧的中断源(读 FIFO、写 1 清标志)再结束,否则死循环;边沿型则可能丢中断——高带宽设备(网卡)选边沿+NAPI,慢速设备选电平,是硬件与软件的联合设计。
2. 软件侧:irq_domain 与三级处理
内核把中断拆成三层,每层职责单一:
irq_domain(翻译层):把 GIC 的硬件号 hwirq 翻译成内核软件号 virq。设备树写 interrupts = <GIC_SPI 54 IRQ_TYPE_LEVEL_HIGH>,解析后 irq_create_fwspec_mapping() 经 irq_domain 分配/查找 virq——/proc/interrupts 显示的就是 virq。多级级联(GPIO 控制器中断再接 GIC)靠 irq_domain 嵌套实现,GPIO 中断号因此可以"各芯片一套"而互不冲突。
irq_desc/irqaction(描述与注册层):每个 virq 一个 struct irq_desc,持有流控回调与 action 链(request_irq 挂进来的)。共享中断(老 PCI 时代遗产)在同一条链上挂多个 action,逐个执行直到有人认领(返回 IRQ_HANDLED)。
流控(chip 层):handle_level_irq/handle_edge_irq 处理"屏蔽-应答-触发-解屏蔽"的时序差异,驱动无感。ARM64 的 GIC 驱动用 irq_chip 结构体实现这层(gic_irq_mask/ack/eoi...),在 core_initcall 级注册——所以你的驱动 probe 时中断控制器必然已就绪(第一篇的 initcall 顺序)。
3. request_irq:注册即声明"我要处理它"
ret = devm_request_threaded_irq(dev, virq,
        foo_hard_isr,        /* 上半部: 应答+决定是否唤醒线程 */
        foo_thread_fn,       /* 下半部: 真正干活(可睡眠) */
        IRQF_TRIGGER_RISING | IRQF_ONESHOT,
        "foo-dev", priv);
几个参数里的真知识:
- IRQF_ONESHOT:threaded 模式下,线程跑完之前中断保持Disabled——不写它,线程还没读到数据中断又来了(重入);
- IRQF_SHARED:共享中断必须能区分"是不是我的"(读自己的状态寄存器),返回 IRQ_NONE 让给别人;
- devm_ 版本:设备移除自动
free_irq(第二篇的 devres 纪律); - 中断标志触发类型会经 irq_chip 下发到 GIC 配置寄存器——设备树里写触发类型 + 代码里再写一遍以代码为准(二者矛盾时内核会抱怨)。
4. 上半部与下半部:一条铁律与四个选项
铁律:硬中断上下文不能睡眠。原因不是教条:它可能是任意进程被打断的现场(下半部复用被中断者的栈,不能调度;调度了回去谁?),内核在 might_sleep() 检查点直接 panic。于是"中断处理"被切成上半部(应答硬件、抢出关键数据)与下半部(慢慢处理)。下半部有四个历史选项:
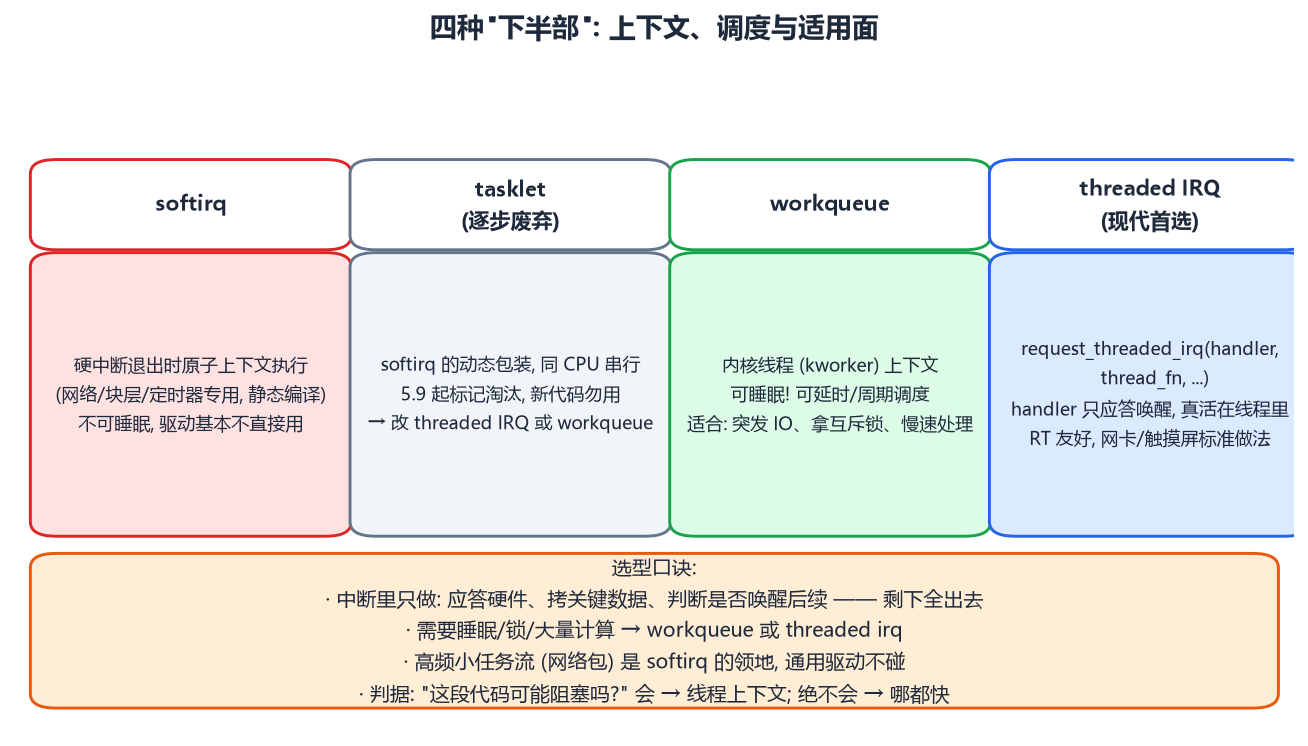
| 机制 | 上下文 | 可睡眠 | 现状 |
|---|---|---|---|
| softirq | 原子(中断退出时) | ✗ | 网络块层定时器专用,驱动别直接用 |
| tasklet | softirq 包装 | ✗ | 淘汰中(同核串行性能差),新代码禁用 |
| workqueue | kworker 线程 | ✓ | 长任务、要拿锁/IO 的通用选择 |
| threaded IRQ | 专属内核线程 | ✓ | 现代默认:handler 只应答,thread_fn 干活 |
选型判据浓缩成两个问题:这段代码可能阻塞吗? 会 → 线程上下文(workqueue/threaded);实时窗口多紧? 亚百微秒级 → 只能 handler 里做(配合自旋锁)。用下面的交互组件过一遍六道真实场景题,把判据变成条件反射:
5. threaded IRQ 为什么是现代默认
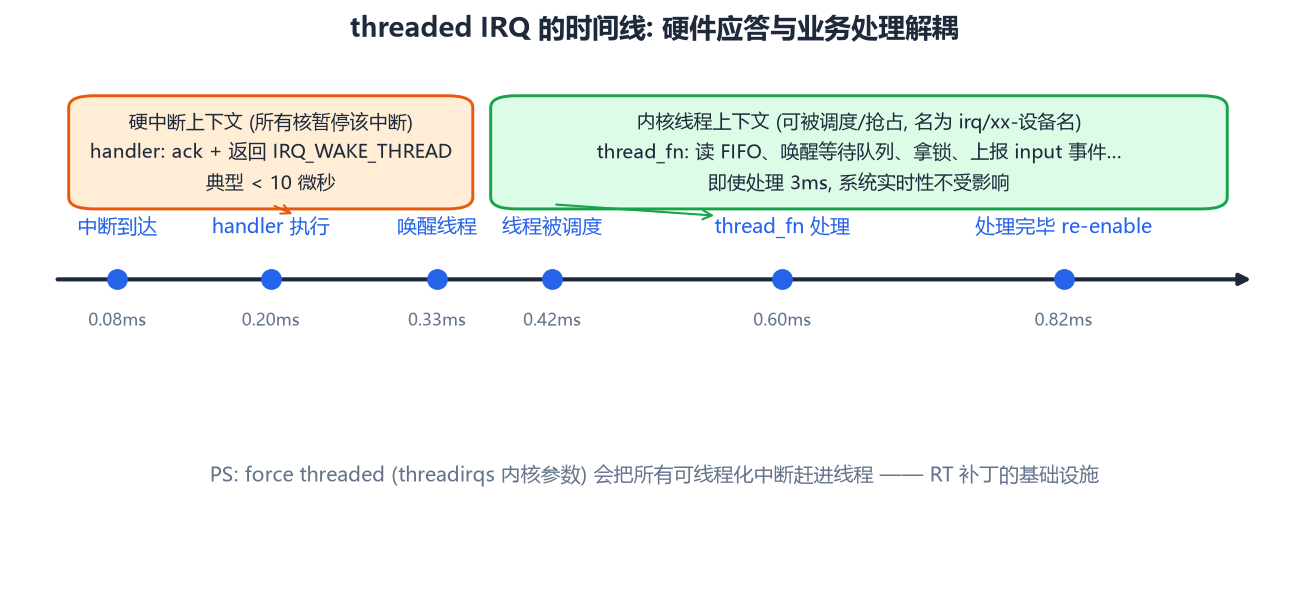
request_threaded_irq() 的分工:handler 里 return IRQ_WAKE_THREAD; 只做应答(微秒级),thread_fn 在名为 irq/42-foo-dev 的调度实体里跑全部业务。收益有三层:
- 实时性:中断线程是普通调度实体,可被高优先级任务抢占——硬 handler 越短,最坏中断延迟越可控(PREEMPT_RT 把这条路走到极致:
threadirqs强制全部线程化); - 可睡眠:thread_fn 里 I2C 读取、mutex、内存分配全部合法——触摸屏/传感器驱动的标准写法;
- 可观测:
ps里能看到 irq 线程的 CPU 占用,top -H 直接定位"哪个中断在吃 CPU"。
留一个经典反例加深理解:10kHz ADC 的 FIFO 溢出窗口只有 100µs,线程调度延迟(负载高时)可能超过它——此时正确的反而是"handler 里自旋锁保护 + 直读 FIFO"(交互组件第 2 题)。机制没有银弹,判据才是武器。
6. 中断风暴与调试
风暴识别:cat /proc/interrupts 两次取差看增速;vmstat 1 的 in 列暴涨。常见根因:电平触发没清源(处理完 GIC 又立刻分发)、设备进错误态狂发中断、使能了从不处理的中断。
定位工具:
/proc/interrupts:每中断每核计数(看亲和性是否失衡);/proc/irq/<virq>/smp_affinity:手调亲和性,把网卡中断钉到一个核;ftrace的irq:事件与irqsofftracer:抓最长中断关闭区间;perf record -e irq_vectors:*:中断分布画像。
一个嵌入式高频问题:中断里 printk 顺手多打——printk 本身有锁与串口开销,高频路径里会放大延迟甚至死锁(尤其早期 low-level 路径)。高频路径改 trace_printk/ftrace ring buffer,printk 留给低频与错误路径。
7. 小结
- 硬件路径:外设 → GIC(优先级仲裁/亲和性)→ CPU 异常向量,触发类型决定软件流控行为;
- 软件三层:irq_domain 翻译 hwirq→virq、irq_desc 组织 action 链、irq_chip 流控;
/proc/interrupts是 virq 计数; - 铁律"中断上下文不睡"的根因是栈与调度语义;下半部四选项中 threaded IRQ 是现代默认,判据是"会不会阻塞+实时窗口";
- IRQF_ONESHOT 防重入、IRQF_SHARED 要认领、devm 版自动释放;
- 风暴三板斧:/proc/interrupts 差分、smp_affinity 调配、ftrace irqsoff 定位。
下一篇进入内存:从页表与 MMU 讲到 kmalloc/ioremap/mmap/DMA——驱动里一半的"玄学崩溃"都藏在那里。
第四部分 · 内核内存与驱动内存
系列第四篇:内存。驱动工程师每天打交道的东西一半是寄存器、一半是内存——而内核内存恰恰最容易写 出"测试全过、量产偶炸"的代码:虚拟/物理地址混淆、cache 不一致、GFP 标志用错、mmap 属性不对。这篇自底向上:先建立 ARM64 页表与 MMU 的模型(配一个页表翻译步进器),再过伙伴系统/slab 两级分配器,最后把驱动里五个高频 API(kmalloc/vmalloc/ioremap/mmap/DMA)逐个讲到能避坑的程度。
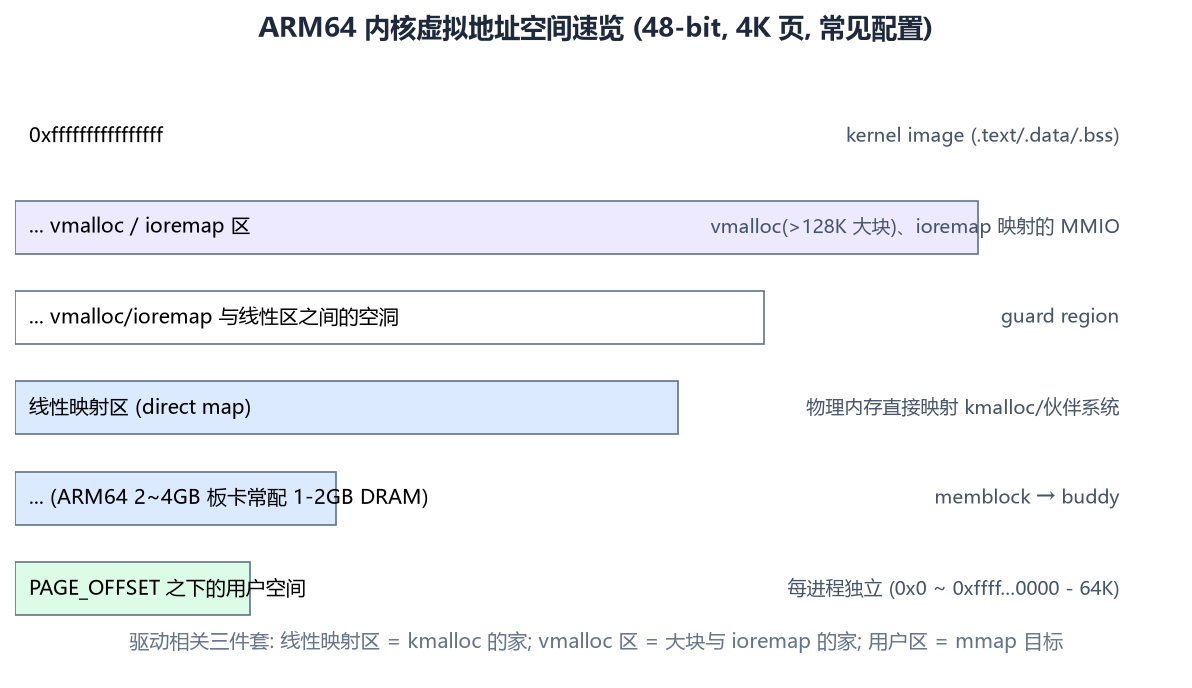
1. 页表与 MMU:所有 API 的地基
ARM64(4K 页、48 位 VA)用四级页表把虚拟地址切成 9+9+9+9+12 位:PGD→PUD→PMD→PTE,每级 512 项。MMU 每次翻译走四级内存读——所以有 TLB(翻译缓存);TLB 未命中才走"页表漫游"(hardware page table walk)。缺页不是异常事故,而是内核介入机制:按需分配、COW、换入都从 Translation Fault 开始。
用下面的步进器亲手走一遍翻译(含一条故意未映射的路径,看缺页怎么发生):
驱动工程师必须带走的三点:
- ioremap 的本质就是造页表:把物理寄存器地址映射进内核虚拟空间,并把页属性设为 Device(禁 cache 禁推测)——所以没有 ioremap 直接解引用物理地址是错的(没有映射,MMU 拦截);
- PMD 级可以终止(2MB block 映射):帧缓冲这类大区域用 block 省页表内存,
/sys/kernel/debug/page_tables能看真实布局; - cache 属性跟着页走:同一物理内存以不同属性映射两次(aliasing)= 玄学数据错乱——DMA 篇的 cache 问题全是它的化身。
2. 物理内存的两级组织
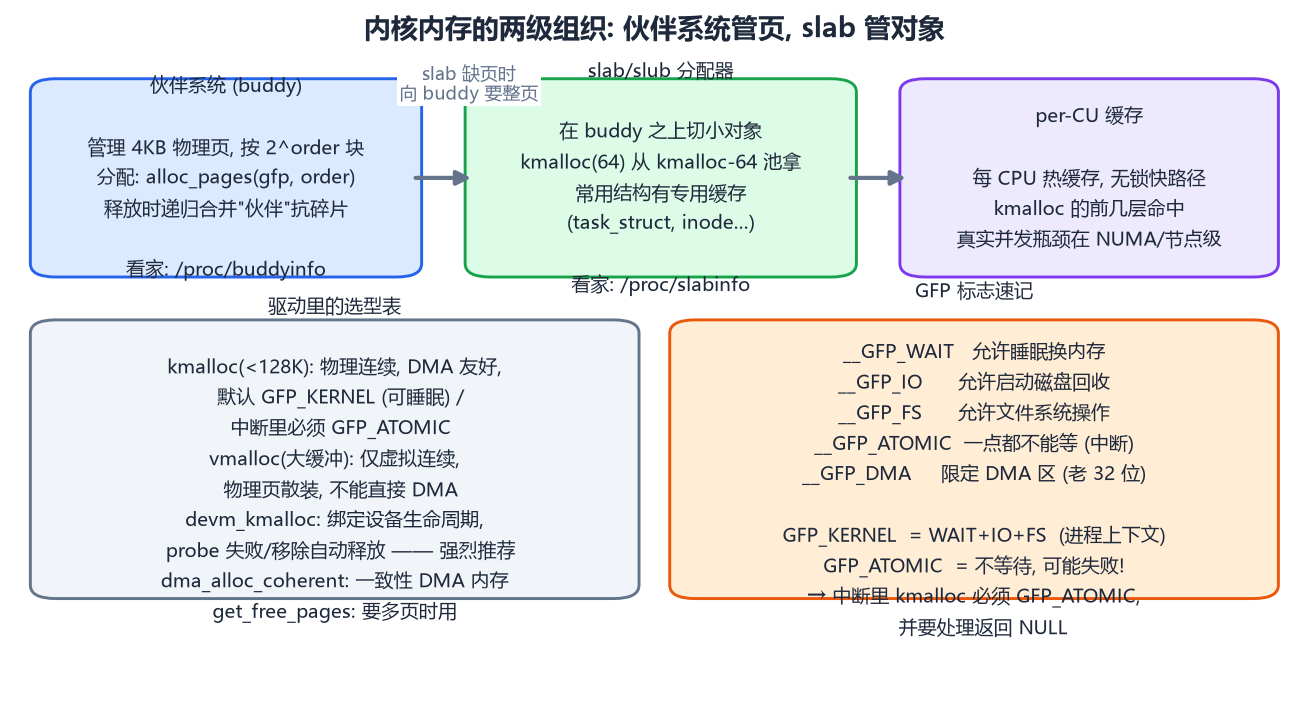
伙伴系统(buddy)管理 4KB 物理页:按 2^order 块组织,分配 alloc_pages(),释放时递归合并"伙伴块"抗碎片。/proc/buddyinfo 直接看各级余量——嵌入式跑几天后 order>0 全空,就是碎片化的实况。
slab/slub 在 buddy 之上切小对象:kmalloc(64) 走 kmalloc-64 专用缓存(对象复用、per-CPU 热缓存、无锁快路径)。/proc/slabinfo 与 slabtop 是内存泄漏排查的第一现场(哪个缓存对象数疯涨)。
驱动选型速记:
kmalloc(≤128K):物理连续、DMA 友好;进程上下文GFP_KERNEL,中断里必须GFP_ATOMIC且要判 NULL;vmalloc(大缓冲):仅虚拟连续、物理散装、不能直接 DMA、TLB 不友好——只用于"大而不急"的场景(固件镜像缓冲);get_free_pages:要多页连续时;devm_kmalloc:绑定设备生命周期(第二篇纪律)。
3. ioremap:寄存器访问的正门
base = devm_platform_ioremap_resource(pdev, 0);   /* DT 的第一个 reg 区 */
writel(0x3, base + CTRL_REG);                     /* 自带内存屏障语义 */
val = readl(base + STAT_REG);
三条铁律:
- 永远用 readl/writel,不要解引用指针:它们保证访问宽度、顺序(内含屏障,第五篇展开)且不被编译器合并;
- Device 属性的意义:寄存器区禁 cache、禁读写推测——一旦映射成普通 cacheable 内存,写入可能停在 cache 里永远没到设备;
- 多个 reg 区(一个 DT 节点写多个
reg+reg-names)用platform_get_resource(pdev, IORESOURCE_MEM, i)按索引取,别硬编码偏移。
4. 驱动 mmap:把内核内存递给用户态
帧缓冲、视频 DMA 缓冲、共享控制块——用户态要直接访问,就走 .mmap 回调 + remap_pfn_range:
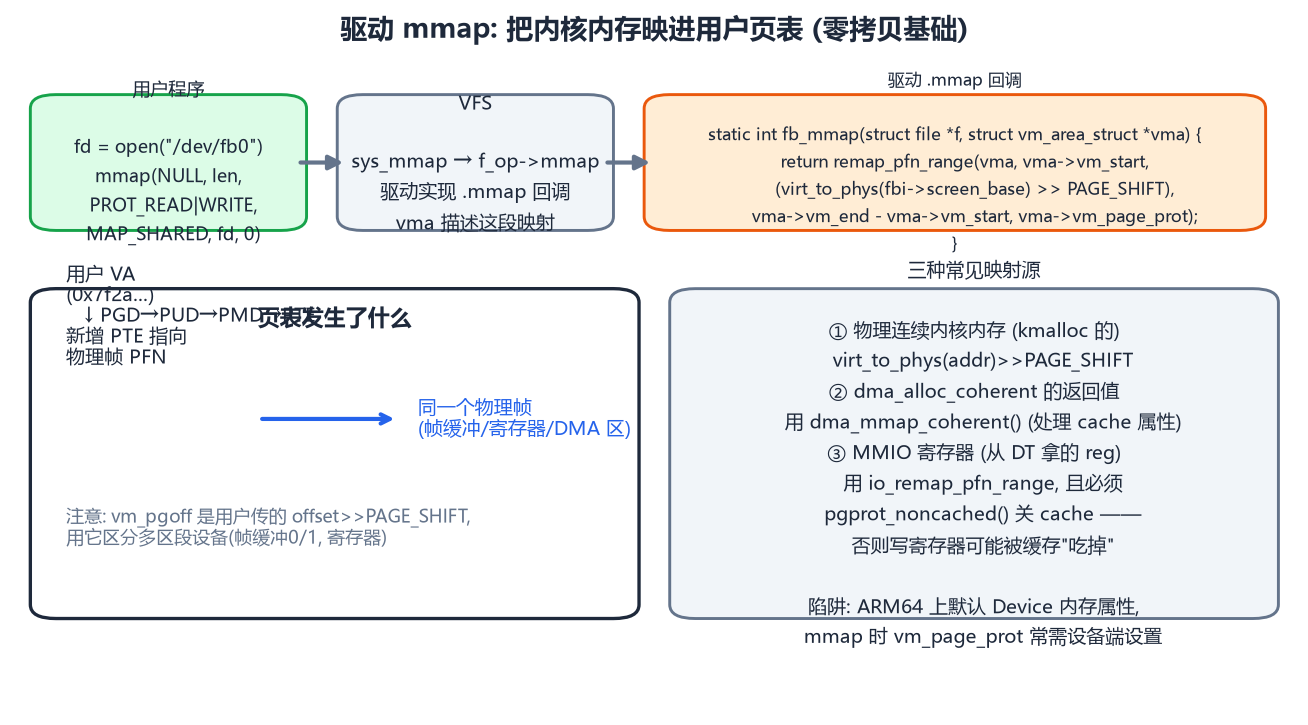
static int foo_mmap(struct file *f, struct vm_area_struct *vma)
{
    size_t sz = vma->vm_end - vma->vm_start;
    unsigned long pfn = virt_to_phys(fbi->cpu_addr) >> PAGE_SHIFT;

    if (vma->vm_pgoff == REGS_OFFSET)                 /* 多区段设备用 offset 区分 */
        return io_remap_pfn_range(vma, vma->vm_start, regs_pfn, sz,
                                  pgprot_noncached(vma->vm_page_prot));  /* 寄存器: 关 cache */
    return remap_pfn_range(vma, vma->vm_start, pfn, sz,
                           vma->vm_page_prot);        /* 普通内存: 保持 cache */
}
避坑清单:
- 物理不连续的内存不能 remap_pfn_range 一段搞定(它只映射连续物理帧)——vmalloc 内存要用
vmalloc_to_page逐页vm_insert_page,DMA 一致性内存用配套的dma_mmap_coherent(cache 属性内核替你管); - 寄存器区映射必须
pgprot_noncached,否则用户态写寄存器同样会被 cache 吞; vm_pgoff(用户传的 offset>>12)是多区段设备(fb0 显存/寄存器)的分发依据,记得校验 size 与对齐,防用户映射越界。
5. DMA:与设备共享内存的正确姿势
DMA 是嵌入式驱动的深水区——因为CPU 与设备看到的是同一物理内存的两套视图,cache 与 IOMMU 让"写完就能读"变成纪律问题:
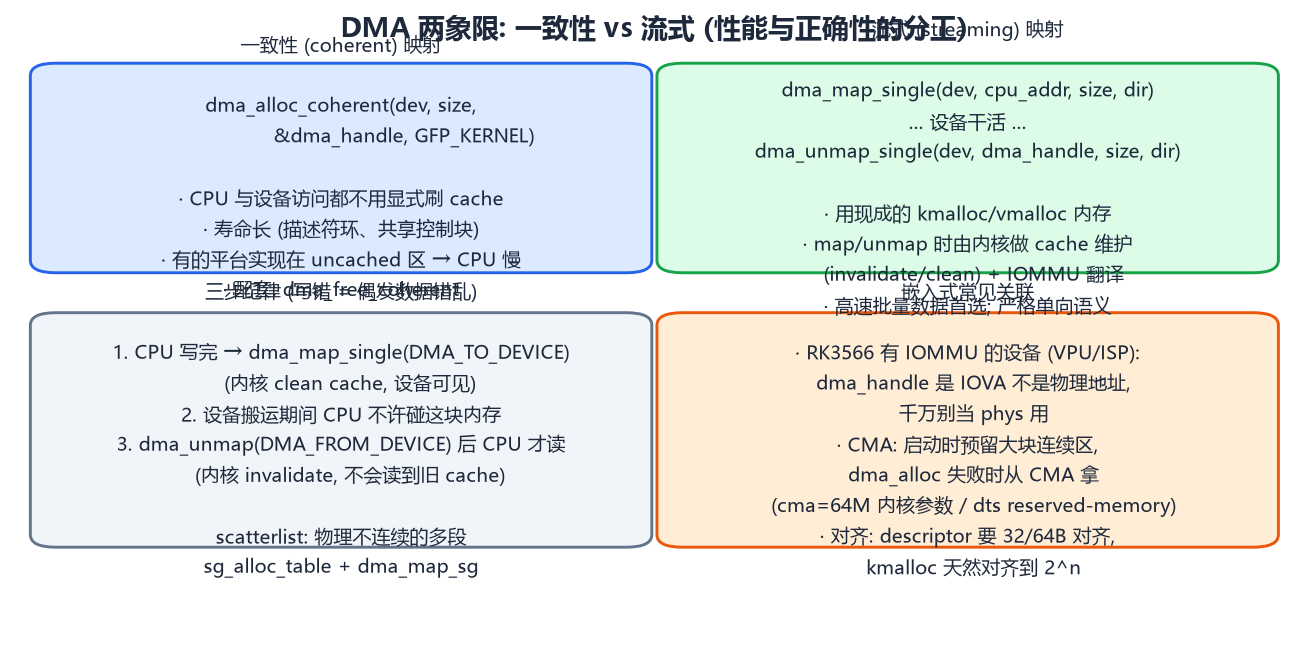
/* 流式映射: CPU 写完 → 交给设备读 */
dma_addr_t dma = dma_map_single(dev, cpu_buf, len, DMA_TO_DEVICE);
if (dma_mapping_error(dev, dma)) return -ENOMEM;
start_transfer(desc, dma, len);                    /* 设备读 cpu_buf 的内容 */
/* 完成中断后: */
dma_unmap_single(dev, dma, len, DMA_TO_DEVICE);    /* 若设备写入了: FROM_DEVICE 方向 unmap 后 CPU 才可读 */
三步纪律的物理意义:map 做的是 clean cache(CPU 视角写入主存)+ IOMMU 建翻译;unmap(FROM_DEVICE) 做 invalidate(防止 CPU 读到旧 cache)。顺序错 = 偶发数据错乱,且只在特定时序/温度下出现——这是"玄学 bug"的最大产地。
嵌入式专项提醒:
- RK3566 带 IOMMU 的设备(VPU/ISP/显卡):
dma_addr_t是 IOVA 不是物理地址,把它当 phys 写寄存器 = 翻译错乱;物理不连续的缓冲走dma_map_sg(scatterlist); - CMA:
dma_alloc_coherent大块失败时的后盾,启动参数cma=64M或 DTreserved-memory预留——相机/视频驱动的显存基本全靠它; - 对齐:描述符/缓冲按设备手册要求对齐(32/64B),kmalloc 天然按 2^n 对齐是白送的便宜。
6. 排障工具箱
| 症状 | 第一现场 |
|---|---|
| 跑几天后分配失败 | /proc/buddyinfo(碎片)、/proc/meminfo 的 CmaTotal/Free |
| 某对象泄漏 | /proc/slabinfo 差分、kmemleak(CONFIG_DEBUG_KMEMLEAK) |
| 偶发数据错乱 | 复查 DMA map/unmap 方向与时机;kasan(CONFIG_KASAN)抓越界 |
| 寄存器写不生效 | 页属性(ioremap vs 普通 map)、barrier、时钟/电源没开 |
| 用户态 mmap 后崩 | vm_pgoff 分支、size 校验、页属性 |
7. 小结
- 四级页表 + TLB 是全部内存 API 的地基;ioremap=造 Device 属性映射,缺页=内核介入机制不是错误;
- buddy 管页、slab 管对象;kmalloc 物理连续可 DMA,vmalloc 仅虚拟连续;中断里 GFP_ATOMIC 必判空;
- mmap 的核心是往用户页表插 PTE:连续物理 remap_pfn_range、寄存器区 pgprot_noncached、一致性内存 dma_mmap_coherent;
- DMA 三步纪律(map→设备专用→unmap 后 CPU 才碰)是 cache 一致性的软件投影;IOMMU 平台上 dma_addr 是 IOVA。
下一篇收束到贯穿一切的主题:并发与同步——锁族谱、RCU 与内存屏障。
第五部分 · 并发与同步:锁族谱、RCU 与内存屏障
系列第五篇(收官):并发与同步。驱动代码的执行环境天然并发——多核同时跑、中断随时打断、软中断/工作队列插队、热插拔随时 remove。内核给了整整一个军械库(原子、自旋、互斥、信号量、读写锁、seqlock、per-CPU、RCU、屏障),而选错武器的代价是偶发死锁或数据损坏,测试环境全绿、客户现场每周炸一次。这篇先建立"上下文决定武器"的第一判据,再逐个拆解主力机制(含 RCU 的时间线模型与内存屏障),最后给一张排障地图。
1. 第一判据:上下文与阻塞
内核里所有执行流分两类:进程上下文(有 task_struct、有归属、可调度可睡眠:syscall 路径、threaded IRQ、workqueue、内核线程)与原子上下文(不属于任何进程、不可睡眠:硬中断、softirq、持自旋锁区间)。第一篇到第四篇反复出现的"中断里不能睡",根源在第 3 节讲透。选锁决策树只有两级:
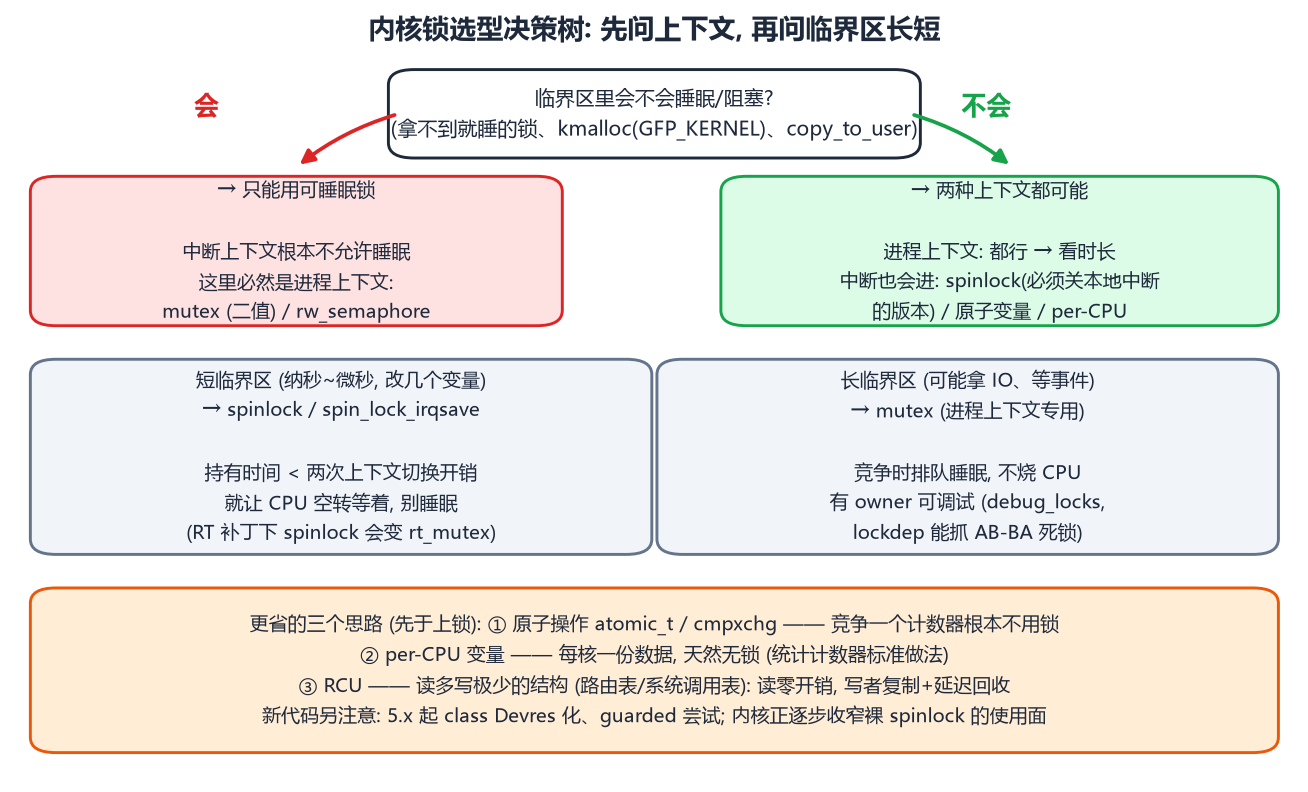
- 临界区可能阻塞(拿 IO、分配 GFP_KERNEL、copy_to_user)→ 只能 mutex/rw_semaphore,且只有进程上下文能进;
- 临界区绝不阻塞且极短(改几个变量)→ spinlock(中断也要进就用
_irqsave变体)或干脆原子操作; - 竞争极少发生(读多写少的结构)→ RCU,读侧近乎免费。
三条"先于上锁"的省钱思路:原子操作(一个计数器根本不用锁:atomic_inc、cmpxchg);per-CPU 变量(每核一份数据天然无锁,内核统计计数器的标准做法);RCU(第 4 节专讲)。
2. spinlock 家族:短临界区的自旋等待
自旋锁的逻辑粗暴:拿不到就原地忙等(不睡眠、不让出 CPU)。它成立的两个前提——临界区必须短于两次上下文切换的开销(否则睡眠锁更划算);只在多核有意义(单核自旋等待自己解锁 = 必死,所以单核配置下持锁期间内核直接关抢占模拟互斥)。
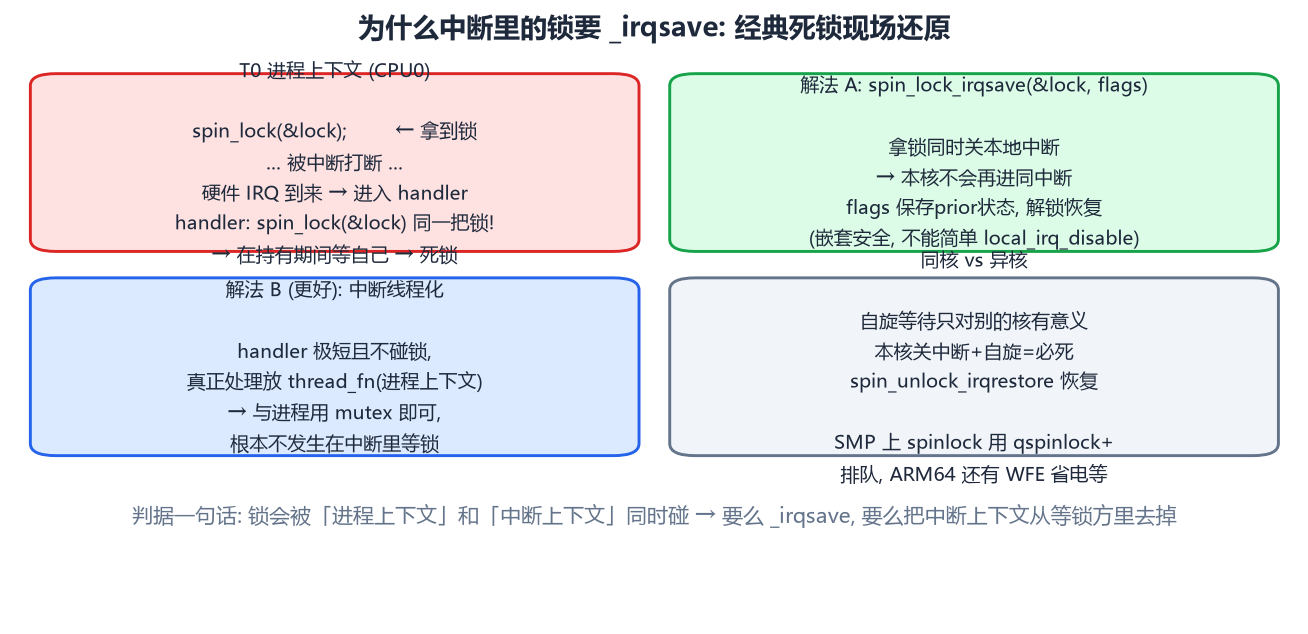
家族变体的选择只看一个问题:谁会和我在同一核上抢这把锁?
spin_lock(&lock);            // 只和进程上下文竞争
spin_lock_irq(&lock);        // 已知中断会进: 无条件关本地中断
spin_lock_irqsave(&lock, flags);  // 不确定中断状态时: 保存并关 (嵌套安全, 通用推荐)
spin_lock_bh(&lock);         // 只防 softirq (网络栈常用)
经典死锁现场(上图左):进程 A 持锁 → 中断打断 A → 中断 handler 里 spin_lock 同一把锁 → 本核自旋等一个永远不会来的释放。_irqsave 的本质就是拿锁时顺手关本地中断,把这个剧本掐灭在第一幕。更好的解法是釜底抽薪:中断线程化(第三篇)让 handler 极短且不碰锁,真正的处理在进程上下文——锁问题从根上消失。
工程细节两条:RT 补丁把 spinlock 实现为可睡眠的 rt_mutex(持锁窗口必须按"可能睡"设计);mutex 在 2.6 后语义收紧为不可在中断/原子上下文使用,might_sleep() 会在配置 debug 时直接抓现行。
3. mutex 与"中断不能睡"的根因
mutex 竞争时排队睡眠,等持有者释放再被唤醒——长临界区、竞争多、要拿 IO 的场景唯一正解。配套纪律:持锁时间以微秒~毫秒计,锁内不做可预见的长事(copy_to_user 大块数据、printk 轰炸);锁的层级(locking order)必须全局一致,否则 AB-BA 死锁——开 CONFIG_PROVE_LOCKING(lockdep)让内核在第一次真实运行时就把潜在死锁路径全指出来,这是驱动代码合入前必开的开关。
为什么中断上下文绝对不能睡,三层原因:
- 中断借用被打断任务的内核栈,睡眠 = 把别人的 task_struct 挂起;
- 调度器切走后再也回不来——唤醒条件可能恰需要当前这条中断路径完成(自锁死);
- 关中断区间里睡眠会让本核中断延迟失控。
4. RCU:读侧零开销的艺术
读多写少(路由表、系统调用表、设备列表)的极致方案是 RCU(Read-Copy-Update):读者不加锁不计数(rcu_read_lock() ≈ 关抢占+屏障,几乎零指令),写者复制一份修改后原子换指针,旧版本等"宽限期"后释放:
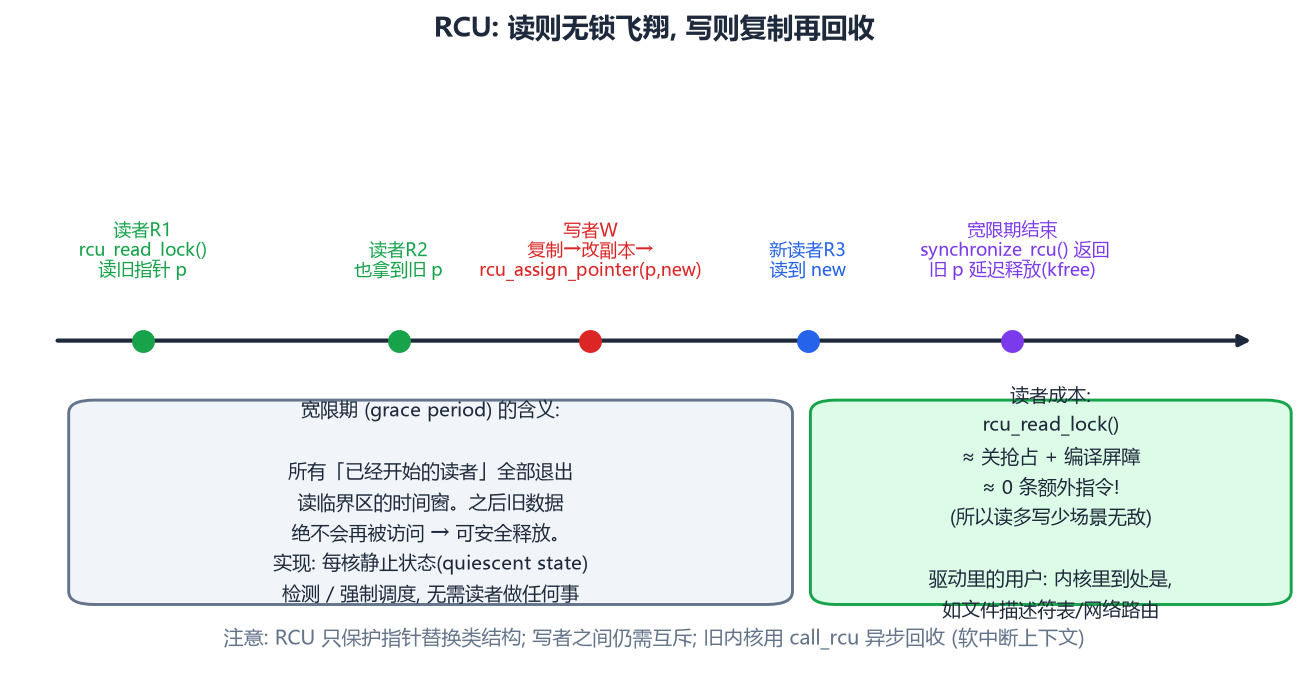
宽限期(grace period)= 所有已开始的读者全部退出读临界区的时间窗:内核通过每核静止状态检测(上下文切换/用户态返回都算)确认无人再持有旧指针,synchronize_rcu() 才返回,旧数据安全 kfree。
使用侧的纪律:RCU 只保护指针替换类结构(链表/哈希/树),被 RCU 保护的内容读者期间不可见修改;写者之间仍要互斥;引用计数与 RCU 常组合(kref + call_rcu)。驱动里直接用的场景不多,但读内核源码不懂 RCU 等于读不懂一半的内核——文件表、网络路由、模块卸载全用它。
5. 内存屏障:多核与设备的"时序胶水"
最隐蔽的一层。ARM64 是弱序内存模型:CPU 与编译器都可能重排访存,store buffer 让"先写的后到"成为常态:
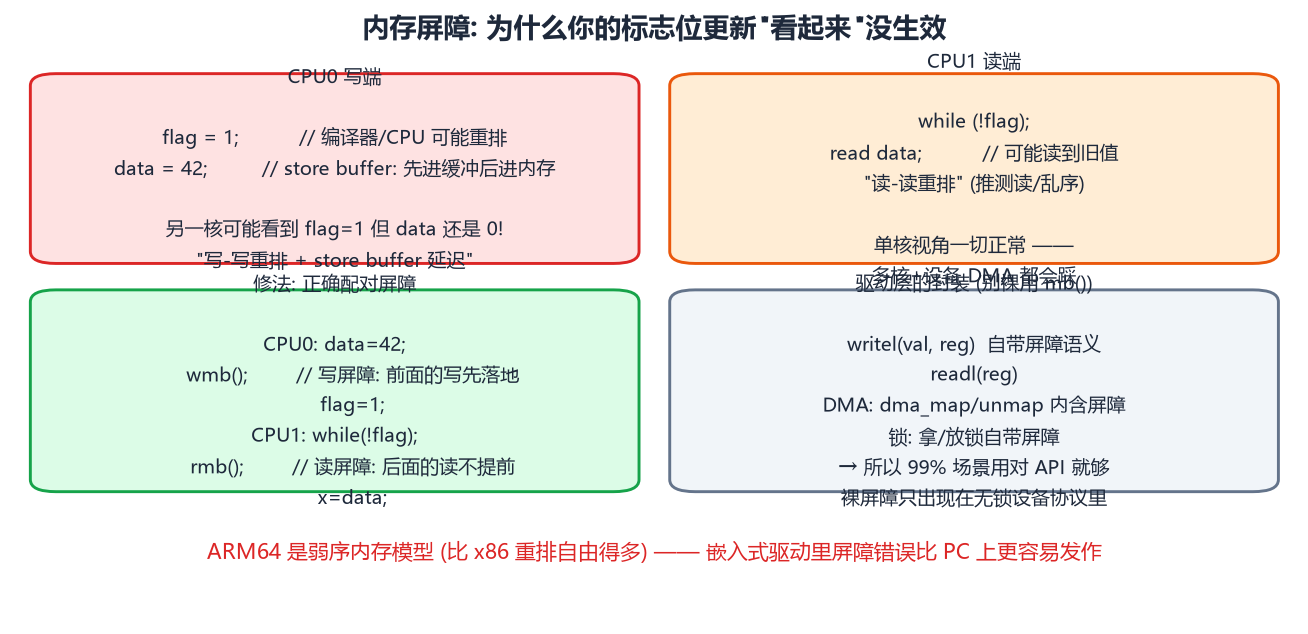
单核视角永远正确——所以这类 bug 只在多核或 CPU↔设备交互时出现,症状是"标志位明明置了,另一个核/设备读到旧数据"。修法是配对屏障(写端 wmb() 再置标志,读端看到标志后 rmb() 再读数据),但内核把绝大多数屏障封进了 API:
writel/readl自带屏障与顺序保证(第四篇"永远用它们"的深层原因);dma_map/unmap内含屏障 + cache 维护;- 所有锁的获取/释放自带屏障——锁不仅互斥,还建立 happens-before 时序。
裸屏障(mb/wmb/rmb/smp_*)只应该出现在无锁的设备协议与极致性能路径上;普通驱动里如果发现自己在写裸屏障,九成是设计该用锁或高级封装了。
6. 排障地图
| 症状 | 概率最高原因 | 工具 |
|---|---|---|
| 偶发硬锁死(watchdog 咬狗) | spinlock 死锁 / 关中断区间过长 | lockdep、nmi_watchdog、ftrace irqsoff |
| 数据偶发错乱 | DMA 方向错 / 缺屏障 / cache 别名 | 第四篇 DMA 纪律、barrier 配对审查 |
| 数据结构损坏 | 临界区漏锁 / 中断共享数据无 _irqsave | lockdep、KCSAN(并发 sanitizer) |
| 偶发 use-after-free | 热移除与执行流竞态 | kasan、debugobjects、显式 get_device |
| 撒娇式卡顿 | 长临界区/持锁 printk | latency_top、ftrace function_graph |
开 debug 内核的习惯(代价是性能,收益是抓鬼能力):CONFIG_DEBUG_SPINLOCK / PROVE_LOCKING / DEBUG_ATOMIC_SLEEP / KASAN / KCSAN——量产镜像关掉,开发镜像全开,"开发期能炸都炸出来"是并发代码唯一的质量策略。
7. 系列总结
五篇走完一条完整链路:启动决定了代码何时何地运行(initcall/deferred probe);设备模型决定了代码如何被发现与绑定(bus/device/driver + 设备树);中断决定了事件如何进来(上半部/下半部纪律);内存决定了数据如何安全存放(页表/kmalloc/mmap/DMA);并发决定了这一切在多核与异步下如何保持正确(上下文判据 + 锁族谱 + RCU + 屏障)。
加上站内已有的字符设备/MISC 驱动入门篇与 RK3566 实战排障篇,嵌入式 Linux 驱动的"入门→内核机制→实战"阶梯就完整了。往后想继续深入的方向:内核调优与实时性(PREEMPT_RT)、电源管理(runtime PM/系统休眠唤醒)、或某个具体子系统(V4L2/Pinctrl/Regmap)——都建立在这五篇的地基上。
8. 小结
- 第一判据:临界区会不会阻塞 + 哪些上下文会进入;会睡 → mutex(仅进程上下文),短而快 → spinlock(中断进则 _irqsave);
- 中断不能睡的根因是借栈+调度不归+关中断区间;threaded IRQ 是从根上消解锁竞争的手段;
- RCU 用宽限期实现读侧零开销的指针替换;只适合读多写少的结构;
- 屏障绝大多数被 writel/锁/DMA API 封装;写裸屏障前先怀疑设计;
- 开发期全开 debug 内核(lockdep/KASAN/KCSAN)是并发代码唯一的质量策略。
全系列总览:启动决定代码何时何地运行,设备模型决定它如何被发现与绑定,中断决定事件如何进来,内存决定数据如何安全存放,并发决定这一切在多核与异步下保持正确——五层合起来,就是嵌入式 Linux 驱动开发的完整知识骨架。每一篇的"排障工具箱"命令值得收藏备用。