
AI Infra 全栈解析:从 NPU 硬件到集群调度运营
这是「AI Infra」系列的合并长文,四部分自底向上覆盖支撑大模型的全部基础设施:算力硬件(CPU 墙 / GPU / NPU 达芬奇架构)→ NPU 编程栈(CANN 对照 CUDA)→ 训练集群(互联网络与集合通信)→ 算力调度与部署(K8s / NPU 切分 / 弹性)。以昇腾为主要 NPU 实例、与 GPU 生态逐层对照,配图 21 张 + Roofline 交互计算器,与站内 LLM 全栈篇互为表里(它讲模型,这篇讲承载模型的机器)。
第一部分 · AI 算力硬件:从 CPU 的三堵墙到 NPU 的达芬奇架构
前面七篇把 LLM 的模型与系统层走完了,从这篇开始进入支撑一切的AI Infra(AI 基础设施)。第一站是硬件:为什么 CPU 跑不动大模型、GPU 凭什么成为主力、NPU(以昇腾达芬奇架构为例)又用什么样的设计哲学换取能效,以及端侧 NPU(RK3588 这类)的取舍。仍然是从晶体管分配讲到数据流,全部落到可计算的数量级上。
1. 三堵墙:一切硬件设计的出发点
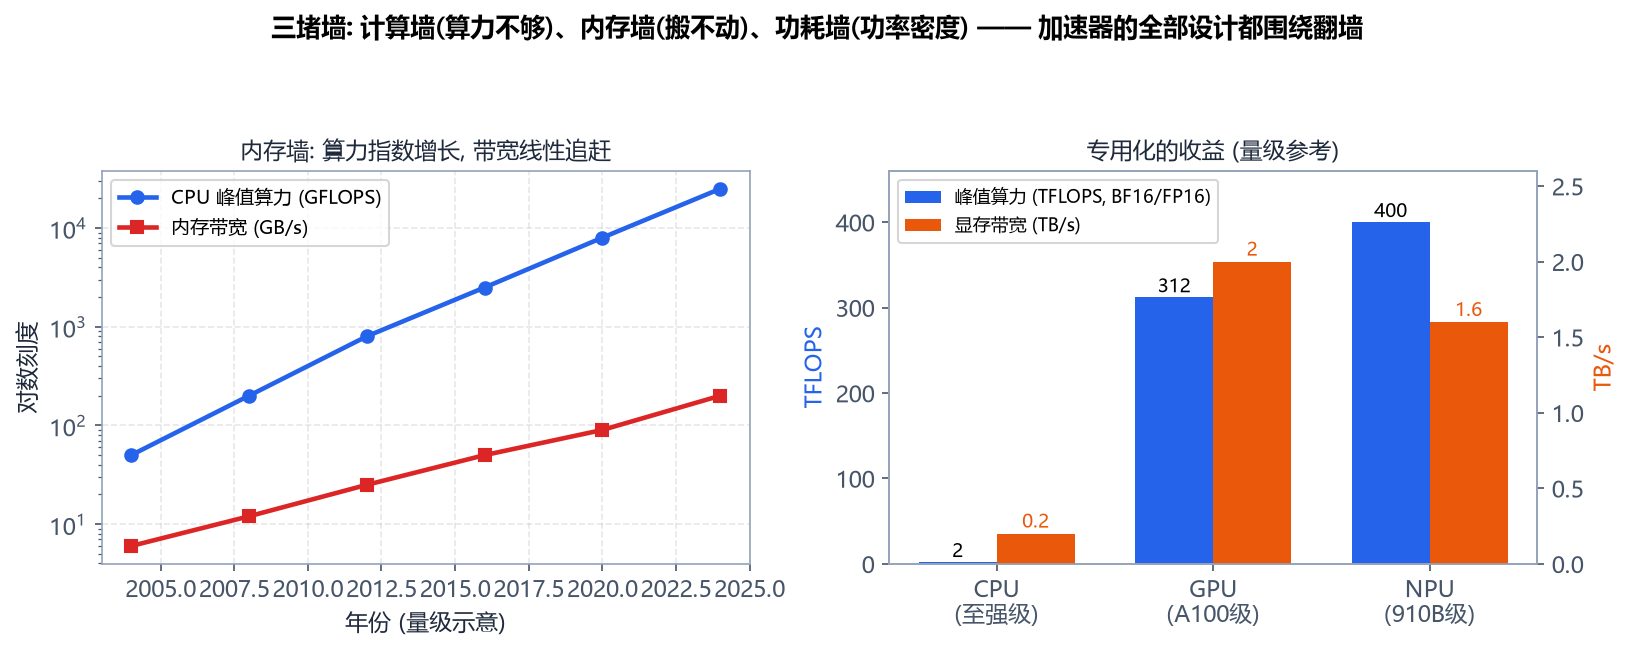
计算墙:一个 7B 模型训练一次约需 10²¹ FLOPs 量级的计算(按 Chinchilla 法则 6ND 估算:6 × 7e9 × 2e12 ≈ 8.4e22,即数万卡·月)。一颗通用 CPU 的峰值算力是 TFLOPS 级,差了十几个数量级——必须用大规模并行。
把"内存墙"变成可以动手的实验——设定芯片的算力与带宽,再把 batch 从 1 拉到 128,看点如何从斜坡爬上屋顶(这正是第 3 节 GPU 设计与推理篇 decode 分析的定量基础):
内存墙:二十年来处理器算力指数增长,内存带宽却近乎线性(图左)。回顾推理篇的结论:decode 阶段算术强度 ≈ 1 FLOP/Byte,而现代加速器"跑满算力"需要 100~300 FLOP/Byte 的强度——搬运能力的缺口决定了大芯片的大部分面积要花在缓存与互联上。
功耗墙:机房供电与散热有硬上限。同样 1 焦耳能量,专用芯片能完成的 MAC 次数可以是通用芯片的数倍到数十倍——能效比(TFLOPS/W)是数据中心和端侧共同的第一性指标。
三堵墙共同指向一个答案:把晶体管从"通用控制逻辑"挪给"乘加阵列 + 数据搬运"。GPU、NPU、ASIC 的差异只是这条路线走得有多坚决。
2. CPU 为什么不行:晶体管花在了哪
一颗现代服务器 CPU 的晶体管预算大致分配:大半在缓存(L1/L2/L3 可占 30~50%)与控制(分支预测器、乱序执行窗口、重命名寄存器),真正做运算的 ALU 只占一小部分。这套设计为的是单线程延迟——任何一段串行代码都快。
它对付矩阵乘的姿势:一条 AVX-512 指令一次算 16 个 FP32 FMA(32 FLOP),核数 × 频率 × 向量宽度拼出峰值。问题有三:
- 算力密度低:数十核 × 每周期数百 FLOP,总量停在 TFLOPS 级;
- 带宽配不上:DDR 通道数百 GB/s,喂饱上述算力需要的 TB/s 级;
- 能效差:大量功耗消耗在"让指令流跑起来"而不是计算本身。
矩阵乘是高度规则、海量数据并行的负载——为串行延迟优化的 CPU 拿到它,就像用轿车拉砂石。
3. GPU:吞吐型并行的成熟答案
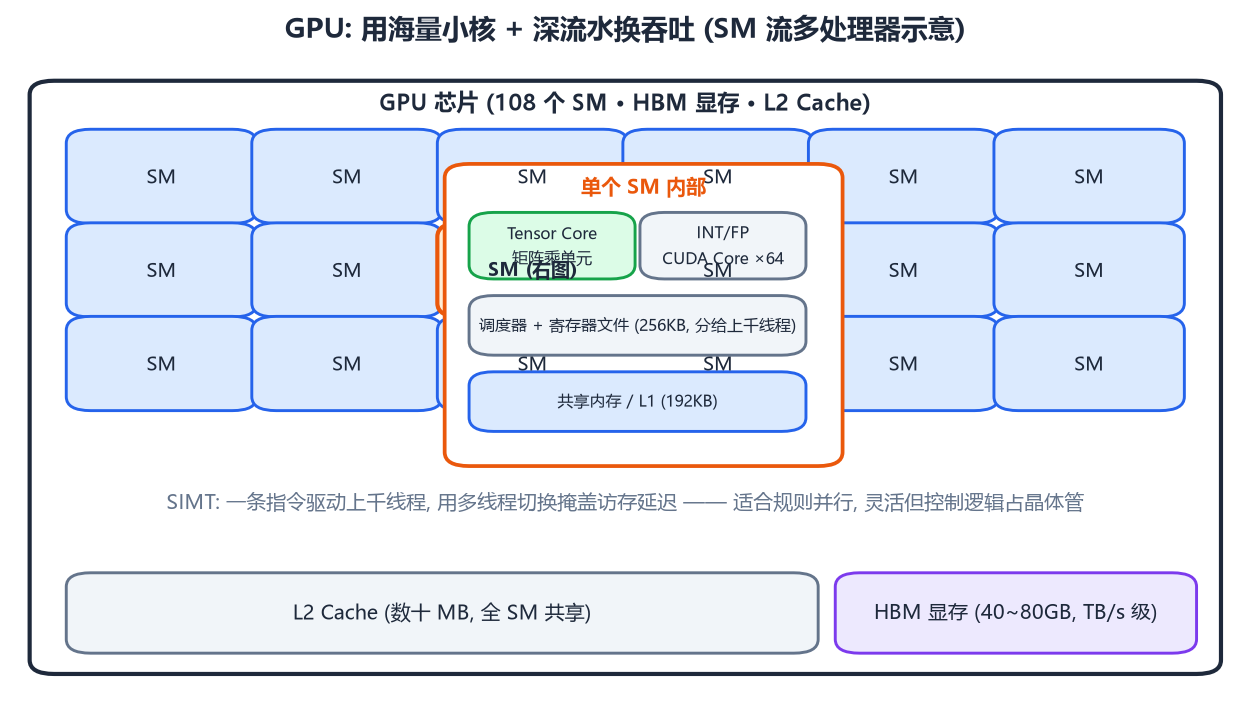
GPU 的思路是用 thousands of threads 淹盖延迟(SIMT 模型):一颗芯片上百个 SM(流多处理器),每个 SM 承载上千线程;某批线程等显存时,调度器零开销切到另一批——不需要大缓存,靠并行度把访存延迟藏掉。
为 AI 带来质变的是 Tensor Core:一条指令完成一个小矩阵块的乘累加(如 16×8×16 的 MMA),把"乘加阵列"固化成硬件单元。A100 级别的 BF16 峰值 312 TFLOPS,其中绝大多数由 Tensor Core 贡献——CUDA Core 只是配角。配合 HBM(2TB/s 级)与数十 MB L2,Transformer 的大 GEMM(通用矩阵乘)正好是它的甜点负载。
GPU 的代价:SIMT 的灵活性(任意 kernel、任意访存模式)需要完整的硬件线程调度、寄存器堆、指令缓存——这些晶体管不直接产出 FLOPS,能效比天然低于专用架构。NPU 的机会就在这里。
4. NPU 设计哲学:以昇腾达芬奇架构为例
国产 NPU 里生态最完整的是华为昇腾。它的核心计算IP叫达芬奇架构,设计哲学一句话:假定负载就是神经网络算子,把一切资源向矩阵乘与数据搬运倾斜。
4.1 三种计算单元:各干一件事
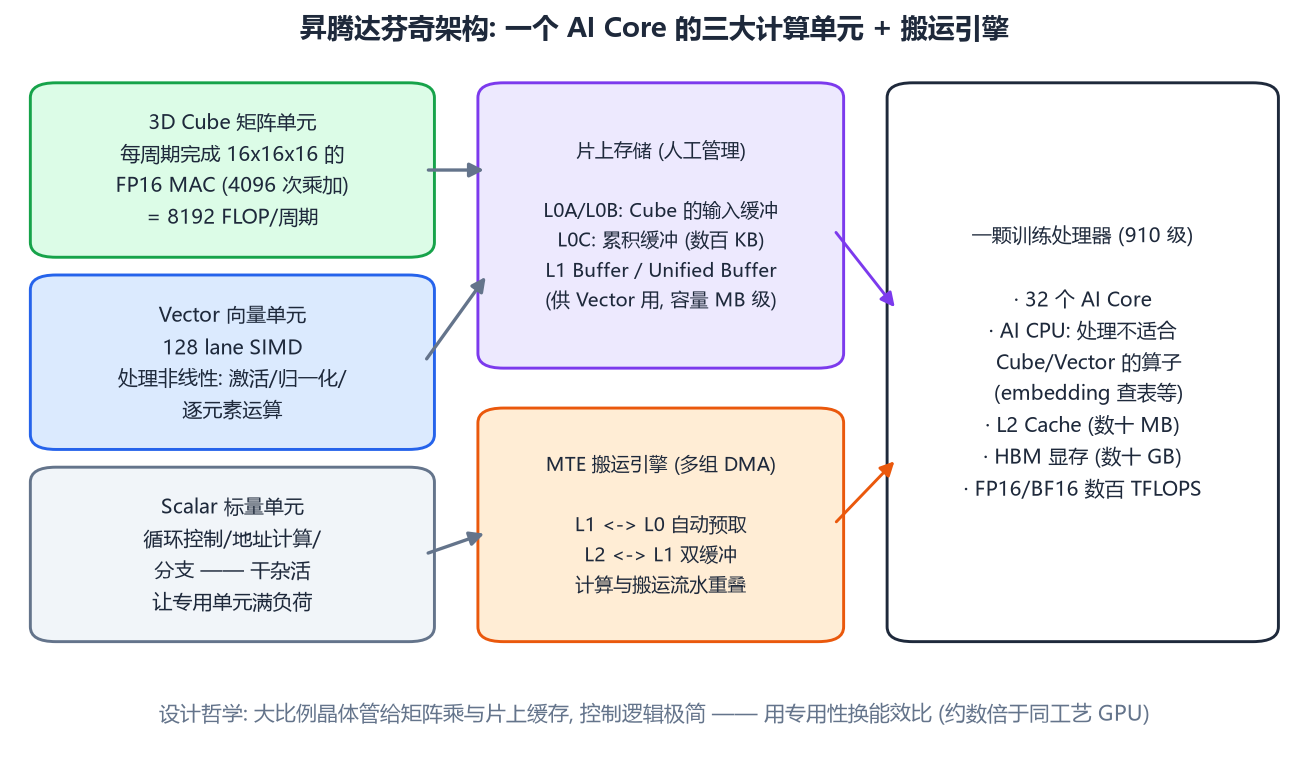
每个 AI Core 内有三类单元,一个 kernel 里三类单元同时流水:
- 3D Cube(矩阵单元):架构的灵魂。一个周期完成一个 16×16×16 的乘累加块——输出平面上 256 个输出、每个输出 16 次 MAC,共 4096 次 MAC(8192 FLOP)/周期。这比向量单元乘同样规模的矩阵快一个数量级;
- Vector(向量单元):128 lane 的 SIMD,处理激活函数、LayerNorm/RMSNorm、逐元素加减——矩阵乘之外的"非线性杂活";
- Scalar(标量单元):循环控制、地址计算、分支。专门有个单元干这个,是为了让 Cube 和 Vector 不被控制流打断——专用化的意义就是互不等待。
不适合 Cube/Vector 的算子(embedding 查表、动态形状控制)交给旁边的 AI CPU(常规 CPU 核),不占 AI Core。
4.2 Cube 一个周期在算什么
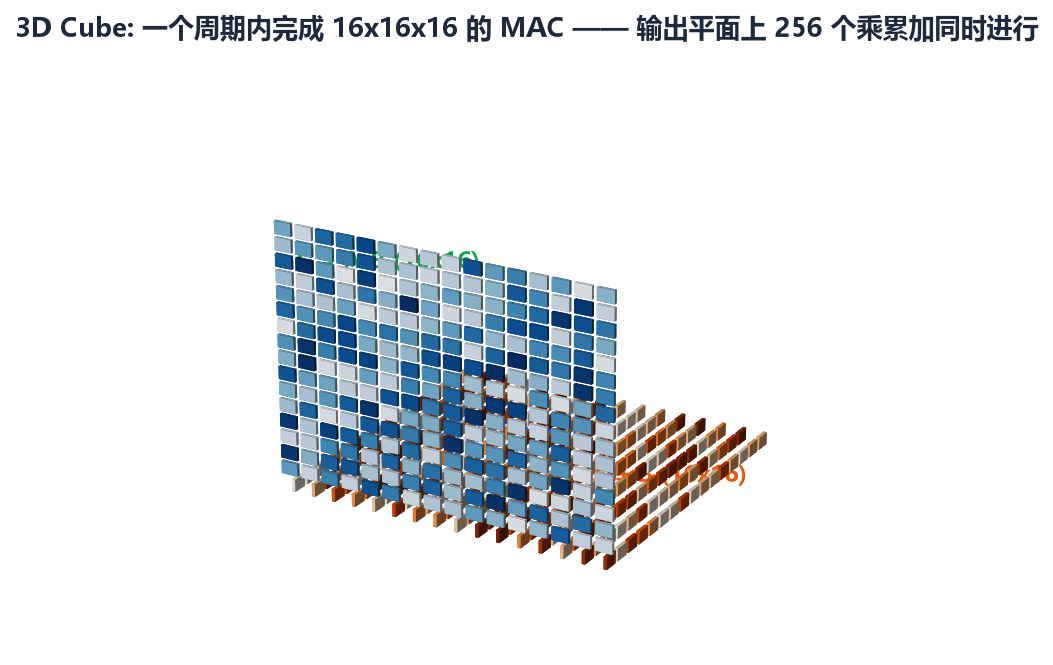
大矩阵乘 C=A·B 被切分成 16×16 的小块:Cube 每周期取 A 的一个 16×16 面、B 的一个 16×16 面,累加进 C 的 16×16 面(L0C 累积缓冲)。软件(算子编译器)的工作就是把这个分块循环、L0A/L0B 的预取、L0C 的写出编排成无缝流水。这本质上是把脉动阵列(systolic array)的思想做成了固定功能单元——数据进阵列后在内部流动复用,控制开销接近零。
4.3 存储层次:手动管理的金字塔
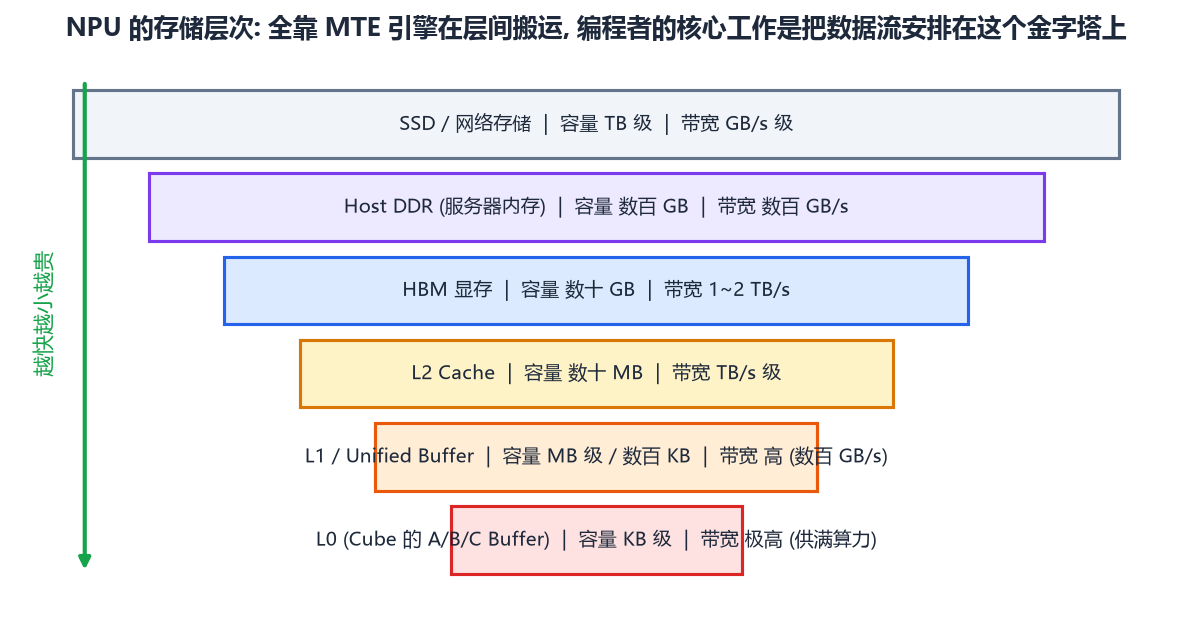
与 GPU"缓存对程序员透明"不同,达芬奇的 L0A/L0B/L0C、L1/Unified Buffer 对算子开发者可见可控,配合多组 MTE 搬运引擎(DMA)做双缓冲:Cube 在算第 N 块时,MTE 已经在搬第 N+1 块。计算与搬运完全重叠——这是能效的另一个来源:没有缓存命中率的赌局,只有确定性的数据流编排。
一颗 910 级训练处理器:32 个 AI Core + AI CPU + 数十 MB L2 + 数十 GB HBM,FP16/BF16 数百 TFLOPS 量级;更新的 910B 级别把 BF16 算力推到 400 TFLOPS 量级、HBM 扩到 64GB——对标国际旗舰 GPU 的训练规格。
4.4 与 GPU 的本质区别
| 维度 | GPU | 达芬奇 NPU |
|---|---|---|
| 并行模型 | SIMT,线程调度硬件化 | 数据流编排,编译期静态调度 |
| 矩阵乘 | Tensor Core 指令 | Cube 固定单元 + 分块流水 |
| 片上存储 | 缓存层次,透明 | L0/L1 显式管理 |
| 灵活性 | 任意 kernel | 面向 NN 算子族 |
| 能效 | 基准 | 同工艺下约数倍 |
| 生态 | CUDA 城墙 | CANN 追赶中 |
一句话:GPU 是"并行的通用机",NPU 是"神经网络的专用机"。专用性换来能效与成本,代价是生态——下一篇讲 CANN 如何在软件上补这块短板。
5. 卡间互联:另一条胜负手
单颗芯片放不下大模型(训练篇:7B 需要 112GB 训练态),卡间带宽成为集群性能的一部分:
PCIe 4.0 x16     ≈ 32 GB/s    —— GPU 传统连接, TP 并行下严重不够
NVLink (A100)    ≈ 600 GB/s   —— 8 卡全互联, 机内
HCCS (昇腾)      ≈ 数百 GB/s  —— 机内卡间高速互联
跨机             RoCE/IB 200G  —— 参数面网络 (集群篇展开)
TP 并行每层要做两次卡间通信,PCIe 的 32GB/s 会把数百 TFLOPS 的算力饿死——机内高速互联(NVLink/HCCS)是训练卡与推理卡的本质区别之一,这也是为什么"8 卡机"是并行策略的最小完整单元。
6. 端侧 NPU:另一个极端的设计
写这篇的读者里应该不少玩过 RK3588——它就是端侧 NPU 的典型样本:
- 3 个 NPU 核、合计 6 TOPS(INT8):注意单位是 TOPS 不是 TFLOPS——端侧靠 INT8 量化拿算力(INT8 吞吐是 FP16 的 2~4 倍),呼应量化篇的结论:端侧部署 = 量化 + 轻量化模型 + NPU;
- 工具链 RKNN-Toolkit2:ONNX → RKNN 转换 + 量化(PTQ/QAT)+ 仿真 + 板端部署,思路与云端一致但更强调"转换即部署";
- 设计取舍:无 HBM(共享 DDR,带宽是最大约束)、Cube 规模小、追求 TOPS/W 而非绝对算力。跑 7B 级 LLM 需要到 4bit 量化 + 内存带宽的极限优化——端侧 LLM 至今仍是"带宽问题"多过"算力问题"。
端侧/嵌入式背景的工程师切入 AI Infra,路径通常是:RKNN 部署小模型 → 量化与算子适配 → 云端训练/推理集群——这条线正好把量化篇和本系列连起来。
7. 选型:什么任务用什么芯片
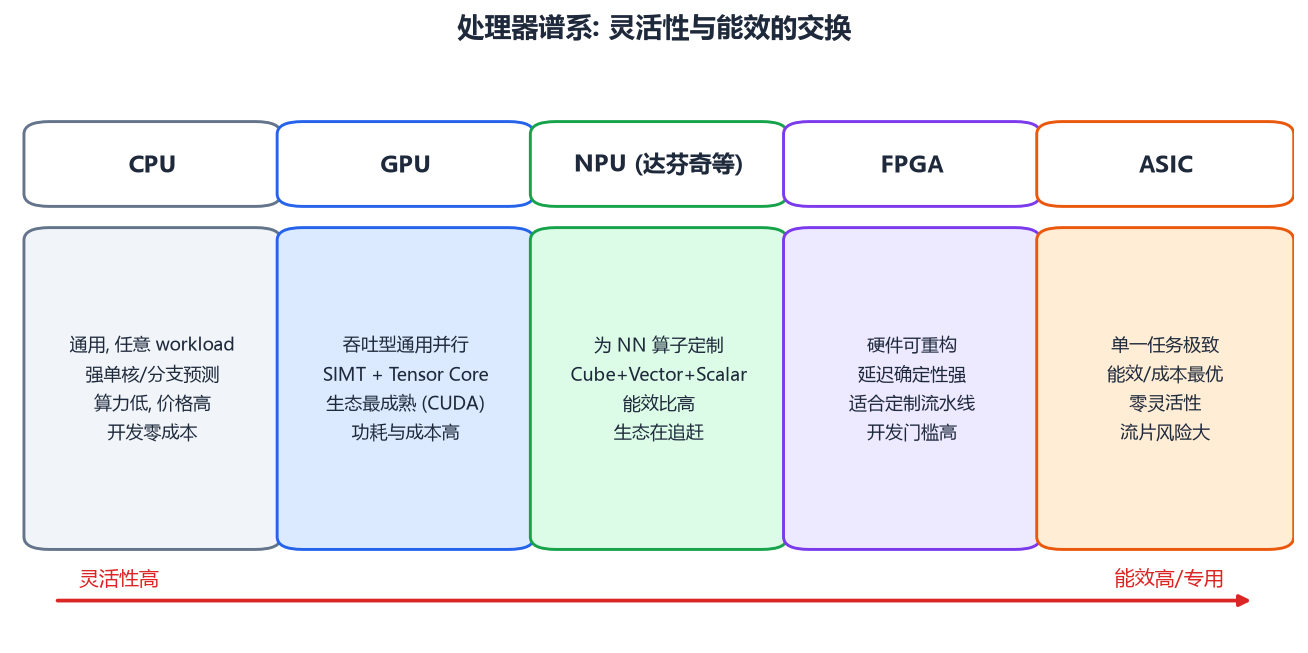
- 云训练/大规模推理:GPU 或训练级 NPU(910B 类),看算力、HBM 容量、卡间互联与生态支持;
- 私有化中等规模推理:推理卡(310B 类:高能效、多卡密度)或国产 GPU,重点算 token 成本;
- 端侧/嵌入式:RK3588 NPU、Jetson、专门的 LLM 端侧芯片——INT8/4bit 生态成熟度是第一考量;
- 非 NN 的高吞吐定制负载(低延迟转发、特定信号处理):FPGA 仍有一席之地。
8. 小结
- 三堵墙(计算/内存/功耗)决定了 AI 芯片把晶体管从控制逻辑挪向乘加阵列与数据搬运;
- GPU 用 SIMT 线程淹没延迟 + Tensor Core 固化矩阵乘,生态(CUDA)是其最深护城河;
- 达芬奇 NPU 用 Cube/Vector/Scalar 三单元分工 + 显式存储层次 + MTE 双缓冲,拿专用性换能效;
- 机内互联(NVLink/HCCS)是训练卡的生死线,跨机参数面是集群篇的主题;
- 端侧 NPU 是"带宽受限下的量化艺术",RKNN 工具链是嵌入式工程师的切入起点。
硬件给了算力,但让 32 个 AI Core 或 108 个 SM 干活的是软件栈——下一篇:以昇腾 CANN 为例拆解 NPU 编程栈,逐层对照 CUDA。
第二部分 · NPU 编程栈拆解:以昇腾 CANN 为例,对照 CUDA
硬件篇结尾留了个钩子:NPU 用专用性换能效,代价是生态。这篇就讲补齐生态的软件层——以昇腾 CANN(Compute Architecture for Neural Networks)为例,把 NPU 编程栈逐层拆开,并与 CUDA 生态逐条对照:从 torch_npu 适配层、图引擎 GE、TBE 算子开发,到 AscendCL 运行时五要素与 HCCL 集合通信,最后给一份 CUDA→NPU 的迁移工程清单。读完你应该能回答:在 NPU 上写一行 model.to('npu') 之后,代码究竟经历了什么。
1. 异构编程栈的通用骨架
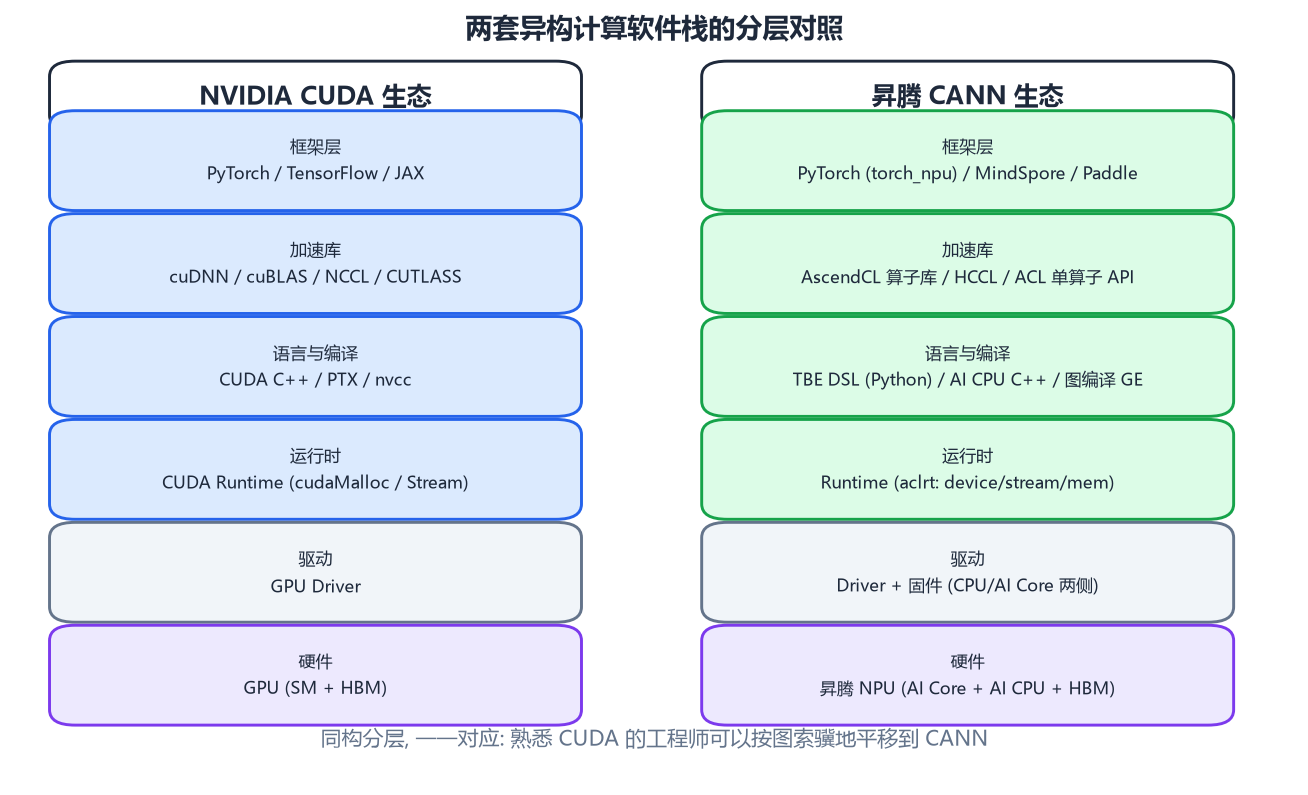
任何 CPU+XPU 的异构计算栈都长成同一个形状,自上而下:
框架层     PyTorch / MindSpore / TensorFlow     写模型的人
加速库     算子库 + 集合通信库                   调性能的人
编译层     图优化 + kernel 编译 (tiling)          做优化的人
运行时     device/stream/memory 管理             每个人都在用
驱动+硬件  真正干活的芯片
CUDA 生态的每一层(cuDNN/cuBLAS/NCCL、nvcc/PTX、CUDA Runtime)在 CANN 里都有对应物(ACL 算子库/HCCL、TBE/GE、aclrt)。分层对照着学,第二套异构栈的成本远比想象中低——这也是本篇的组织方式。
2. 一行 model.to('npu') 的完整旅程
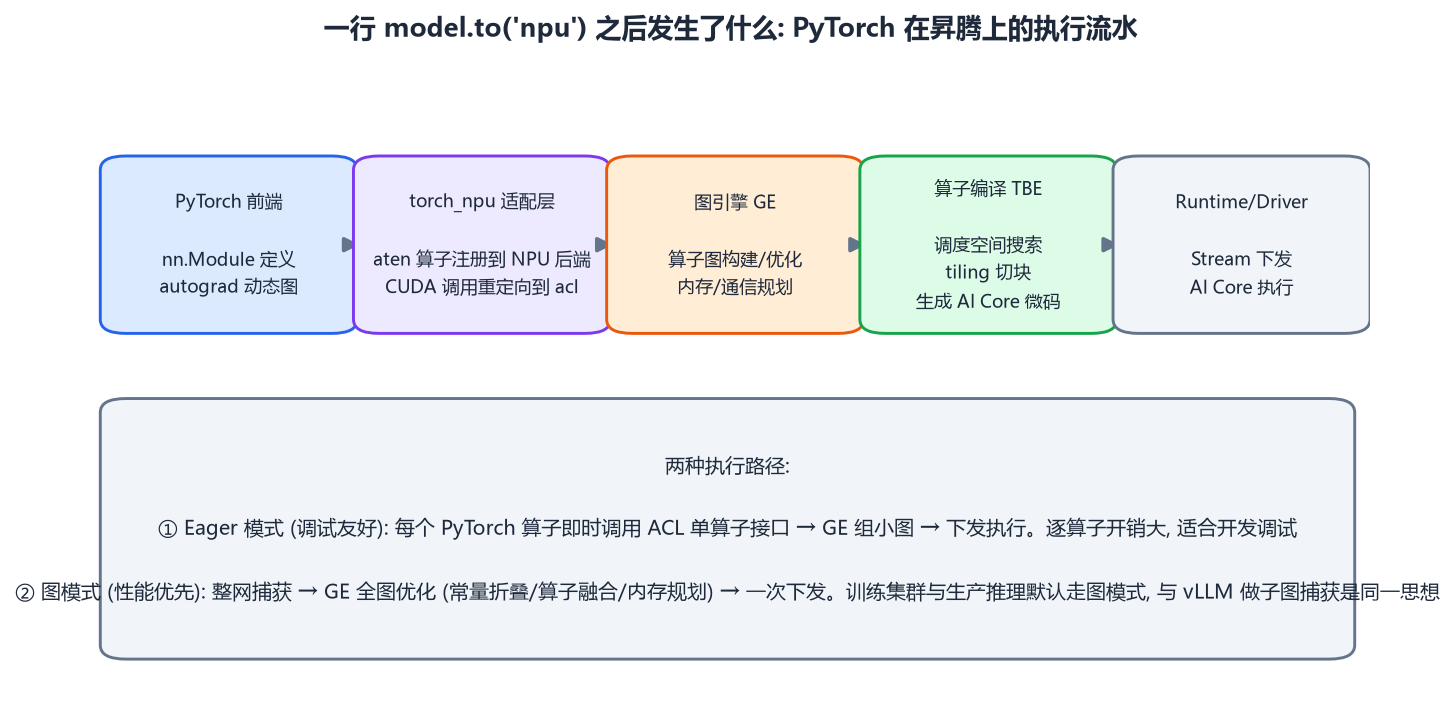
PyTorch 用户几乎不需要改模型代码,秘密在适配层:
- torch_npu 插件把 PyTorch 的 aten 算子注册一份"NPU 后端实现"——
torch.add的分发目标从 CUDA kernel 换成 ACL 算子调用,模型代码零感知; - 图引擎 GE(Graph Engine)把算子流组织成计算图,做常量折叠、算子融合、内存与通信规划;
- 算子编译 TBE(Tensor Boost Engine)为每个算子生成 AI Core 上真正跑的微码——核心工作是 tiling:把逻辑上的大张量按 L0A/L0B/L0C、Unified Buffer 的物理容量切块,编排"搬运-计算-写出"的流水(硬件篇的存储金字塔在这里落地);
- Runtime(aclrt)与驱动把编译产物放进 stream 队列,驱动 32 个 AI Core 执行。
两条执行路径要分清:
- Eager 模式:每个算子即时编译即时执行,逐算子开销大——开发调试用;
- 图模式:整网捕获、全图优化、一次下发——生产训练/推理用。这与 GPU 侧
torch.compile、vLLM 子图捕获是同一个思想:把 Python 的动态性挡在编译期之外。
3. AscendCL:运行时编程五要素
写原生 NPU 程序(类似写 CUDA C++)时面对的是 AscendCL 接口层,五个概念撑起全部骨架:
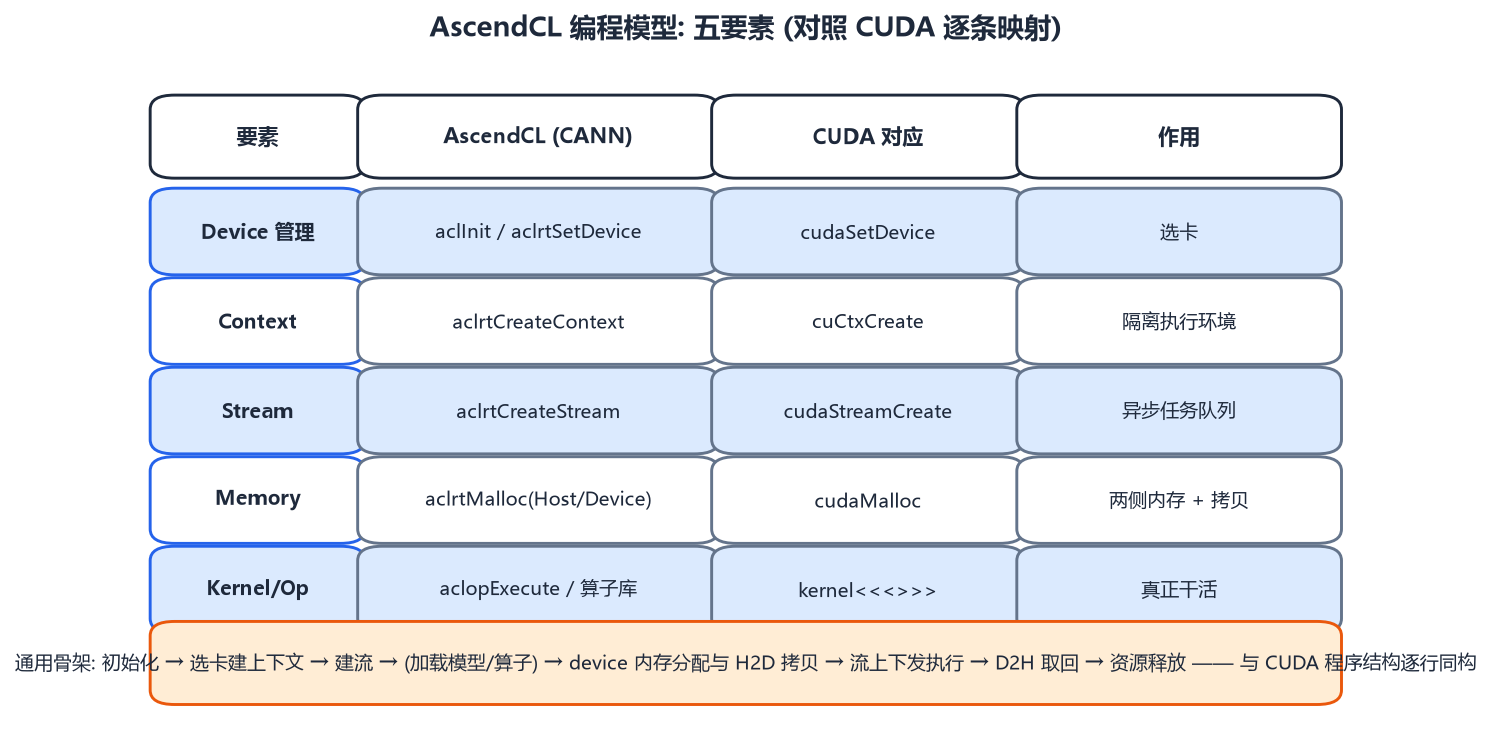
| 要素 | AscendCL | CUDA 对应 | 作用 |
|---|---|---|---|
| Device | aclrtSetDevice |
cudaSetDevice | 选卡 |
| Context | aclrtCreateContext |
cuCtxCreate | 隔离执行环境 |
| Stream | aclrtCreateStream |
cudaStreamCreate | 异步任务队列 |
| Memory | aclrtMalloc(Host/Device) |
cudaMalloc | 两侧内存与 H2D/D2H 拷贝 |
| Op 执行 | aclopExecute / 模型 API |
kernel<<<grid,block,stream>>> |
下发计算 |
一个最小骨架(结构上与 CUDA 程序逐行同构):
import acl

# 初始化 → 选卡 → 上下文 → 流
acl.init()
device_id = 0
acl.rt.set_device(device_id)
context, _ = acl.rt.create_context(device_id)
stream, _ = acl.rt.create_stream()

# device 内存 + H2D 拷贝 (对照 cudaMalloc / cudaMemcpy)
w_dev, _ = acl.rt.malloc(16 * 1024 * 1024)
w_host, _ = acl.rt.malloc_host(...)          # 或 numpy 池化内存
acl.rt.memcpy(w_dev, ..., w_host, ...,
              kind=acl.rt.MEMCPY_HOST_TO_DEVICE)

# 下发算子 (对照 kernel<<<...>>>)
acl.op.execute(op_handle, inputs, outputs, stream)
acl.rt.synchronize_stream(stream)            # 对照 cudaStreamSynchronize

# 资源释放 (顺序与创建相反)
acl.rt.destroy_stream(stream)
acl.rt.destroy_context(context)
acl.rt.reset_device(device_id)
acl.finalize()
两处与 CUDA 微妙的差异值得注意:Host 侧内存要经 aclrt 分配(走 DMA 直达通道,比普通 malloc 拷贝快);以及 NPU 上"算子"比"kernel"更上层——单算子执行内部还带着格式推导与小图优化,这为图模式做了铺垫。
4. 算子开发:TBE 与"搬运即编程"
需要在 NPU 上写一个新算子(没有现成实现时),TBE 的开发模型最能体现达芬奇架构的特点:
# TBE DSL 形态 (示意): 用 Python 描述一个向量加算子
import tbe.dsl as tbe

def add_compute(x, y, shape, dtype):
    return tbe.vadd(x, y)              # Vector 单元的向量加

def add_schedule(out, shape):          # 调度: 决定 tiling 与流水
    ...                                # 按 UB/L1 容量切块, 编排 MTE 双缓冲
- compute(算什么):
vadd/vmul这类原语映射到 Vector 单元,矩阵乘走 Cube 的matmul原语; - schedule(怎么搬怎么切):这部分才是 NPU 算子开发的主体——把数据流按硬件篇的 L0/L1/UB 金字塔编排,让 Cube 计算时 MTE 在预取下一块。调优一个 GEMM 算子,九成时间花在 tiling 与流水排布上;
- 纯 Python 描述 + 编译期生成微码,迭代速度比写 PTX 友好;调度空间大时配合 auto-tune 搜索。
这套"显式数据流编程"是 NPU 与 GPU 生态最大的心智差异:CUDA 程序员优化的是线程块与共享内存的映射,TBE 程序员优化的是搬运与计算的流水重叠——对象不同,目标一致:喂饱专用计算单元。
5. 图编译与算子融合
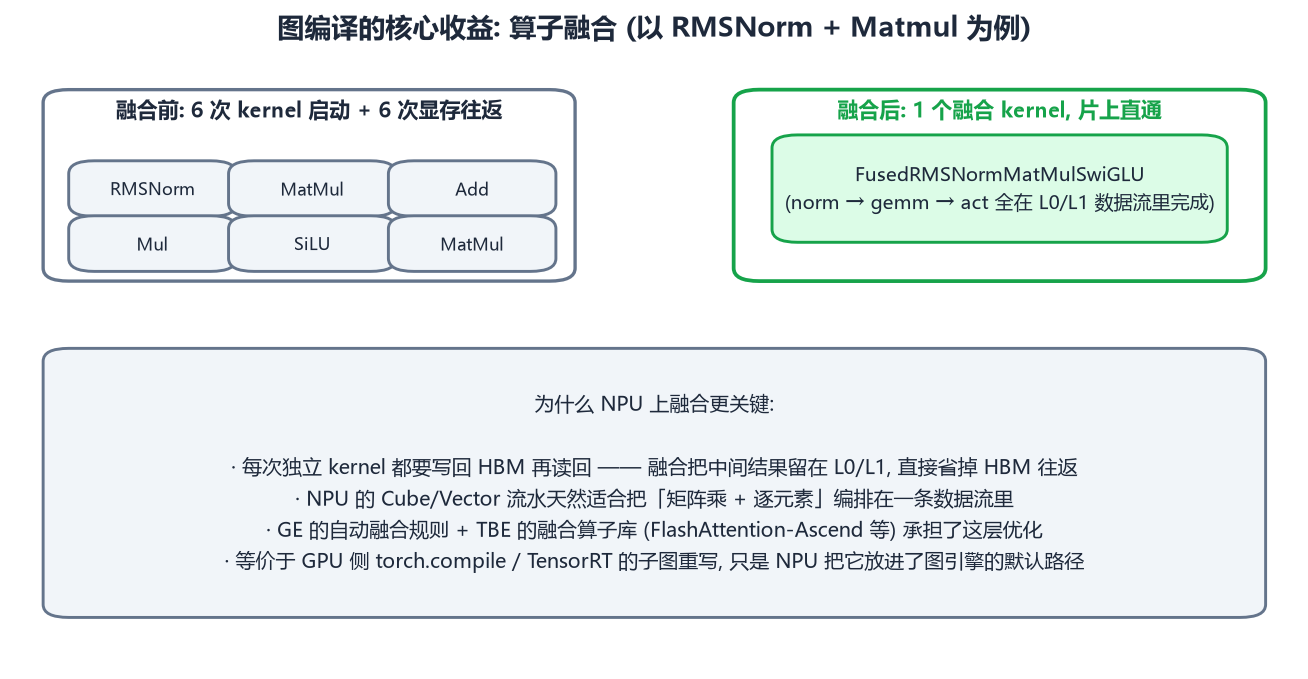
GE 图引擎的核心价值是算子融合:RMSNorm→MatMul→SiLU→Mul 这些小算子如果各自独立执行,每个都要写回 HBM 再读回;融合成一个 kernel 后中间结果留在 L0/L1 片上直通——对 decode 这种带宽受限负载(推理篇),融合直接决定吞吐。NPU 上这层优化比 GPU 更关键:达芬奇的显式存储层次天生适合把"矩阵乘+逐元素"编排在一条数据流里,FlashAttention 的 Ascend 版本就是把 softmax 的在线更新整个塞进 Cube/Vector 流水。
对框架用户的直接建议:生产路径尽量走图模式并预热——动态 shape 每出现一个新形状都可能触发一次图编译,用 shape 分桶 + warmup 把编译成本挡在服务前。
6. HCCL:集合通信的 NPU 侧实现
多卡程序里 NCCL 的对应物是 HCCL(Huawei Collective Communication Library):all-reduce/all-gather/reduce-scatter/broadcast 的 API 形态与 NCCL 基本对齐,底层走 HCCS(机内)与 RoCE 参数面(跨机)。迁移多卡训练时的实践要点:
- 通信组创建(
init_process_group走 hccl backend)与 NCCL 用法一致,PyTorch 代码通常只改 backend 与 device; - 回归测试重点:超大消息的 all-reduce 分档、梯度桶大小与通信-计算重叠是否生效(NPU 上的 bucket 合并策略可能与 NCCL 调参不同);
- 集群篇会展开算法层(ring 等),那一层与硬件无关,两套栈共用同一套数学。
7. CUDA → NPU 迁移清单
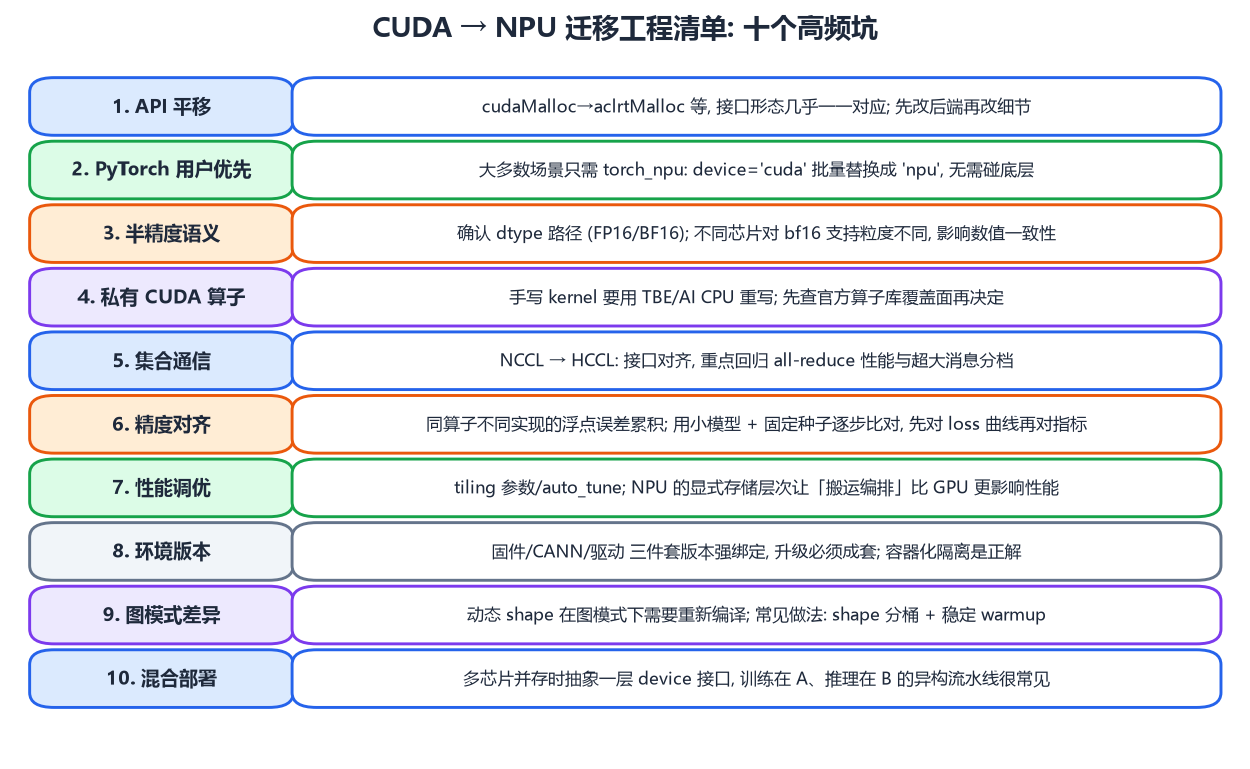
把清单里的高频项展开成判断题:
- 你只是用 PyTorch 训练/推理?→
pip install torch_npu,device 字符串'cuda'→'npu',大概率当天跑通;精度对齐做一轮(小模型、固定种子、比 loss 曲线再比指标); - 你有自定义 CUDA kernel?→ 成本大头。先查官方算子库与 TBE 融合算子覆盖面,覆盖不到的用 TBE/AI CPU 重写——这一步的工作量按算子数量线性计;
- 你在做性能敏感的服务?→ 图模式 + auto-tune + tiling 调优,重点盯"搬运编排";profile 工具看 AI Core 利用率与 MTE 空闲期,而不是只看 FLOPS;
- 运维环境?→ 固件/驱动/CANN 版本强绑定,升级必须成套验证;用容器(镜像内置匹配版本)隔离,这是多团队协作的救命绳。
8. 生态视角:如何客观看待两套栈
CUDA 的护城河不在某一项技术,而在十五年积累的算子覆盖、文档、Stack Overflow 答案与人才市场。CANN 的追赶策略清晰:兼容 PyTorch 主路径(torch_npu)、对齐 NCCL 形态(HCCL)、图模式吃性能、算子库补高频缺口。现实结论:
- 标准 workload(主流 LLM 训练/推理)上,NPU 路径已可用,瓶颈在长尾算子与调优经验;
- 越非标的负载,迁移成本越接近"重写";
- 对工程师个人:第二套异构栈的边际学习成本很低(骨架同构),而"懂两套栈"在当前环境里是稀缺能力。
9. 小结
- 异构栈分层同构:框架→加速库→编译→运行时→驱动,CANN 与 CUDA 可逐层对照学习;
model.to('npu')背后:torch_npu 算子注册 → GE 图优化 → TBE tiling 编译 → aclrt 下发,eager 调试、图模式上生产;- AscendCL 五要素(device/context/stream/memory/op)与 CUDA 逐条映射,注意 Host 侧 DMA 内存与"算子比 kernel 更上层"两个差异;
- NPU 算子开发的主体是 schedule:把数据流编排进 L0/L1 存储层次,让计算与搬运流水重叠;
- 算子融合是图引擎的核心收益,也是 NPU 存储层次的天然优势;迁移成本集中在自定义 kernel 与精度/性能双对齐。
单机讲完了,几百张卡怎么连成一台"计算机"——下一篇:训练集群的互联网络与集合通信。
第三部分 · 千卡训练集群:互联网络、集合通信与故障容忍
训练篇算过账:7B 模型训练态 112GB,需要多卡;真实的大模型训练动辄几百上千张卡。这时瓶颈从"单卡算力"变成"卡间与节点间的数据搬运"——千卡集群的有效算力(MFU)一半取决于芯片,另一半取决于网络与通信算法。这篇把集群层彻底拆开:all-reduce 环算法的逐步推导与带宽公式、参数面网络的 spine-leaf 设计、三种并行的通信量账本、NCCL/HCCL 做了什么,以及千卡集群的故障容忍体系。
1. 问题:梯度同步到底要搬多少数据
数据并行最朴素的需求:每张卡算不同 batch,反传后各自手里的梯度必须变成全卡平均——这就是 all-reduce(全归约)。7B 模型 FP16 梯度是 14GB;8 卡朴素做法(全发到 0 号卡求和再广播):
0 号卡收: 7×14 = 98 GB, 发: 7×14 = 98 GB   ← 单点收发 196GB
其他卡带宽闲置, 0 号卡链路被打爆
树形(reduce-broadcast)改进了负载,但仍要求网络具备高扇出的交换能力。千卡场景的正确答案是环。
2. Ring All-Reduce:算法逐步拆解
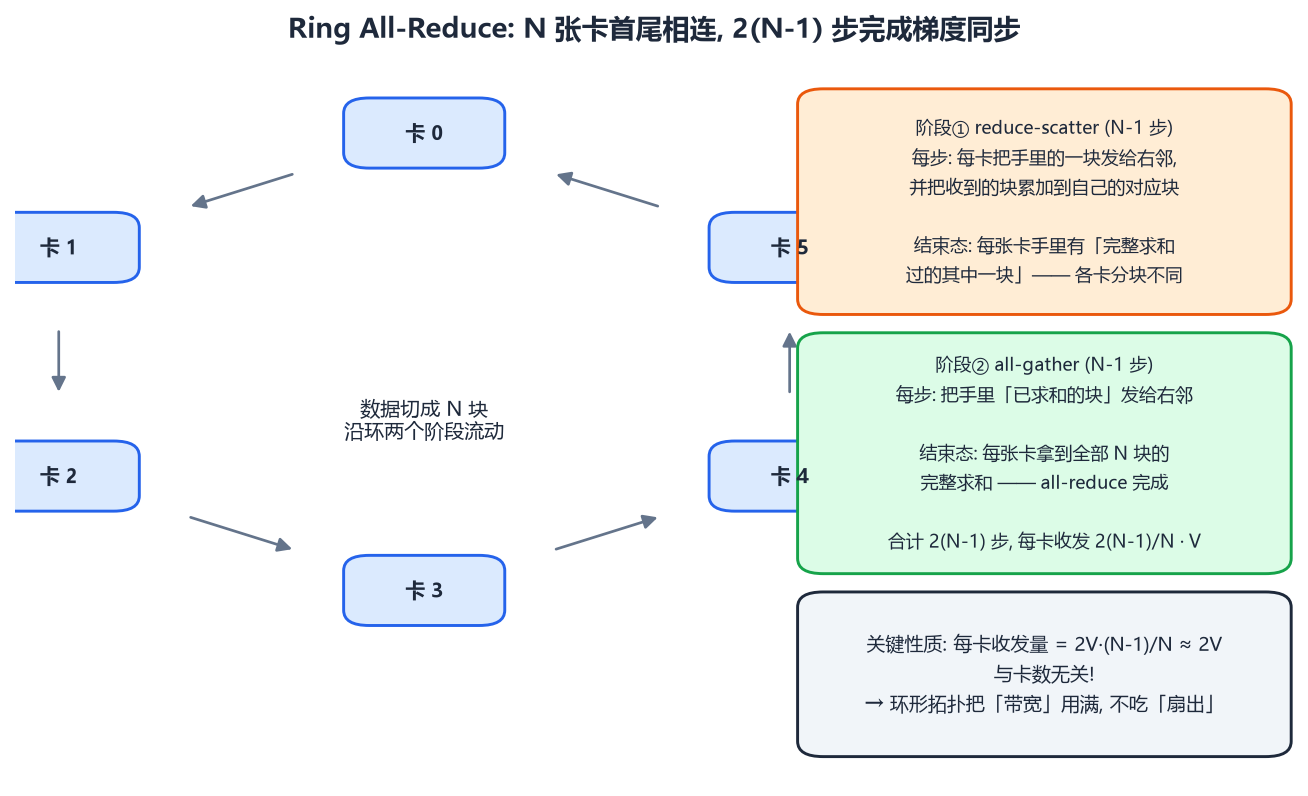
下面这个模拟器逐步执行真实的环算法(数值可与手算核对):N−1 步 reduce-scatter 后每卡恰好持有一块完整和,再 N−1 步 all-gather 人人拿到全部结果。切换卡数 N,看步数与每卡搬运量的变化:
N 张卡首尾连成环,梯度切成 N 块。两个阶段、共 2(N−1) 步:
阶段① reduce-scatter(N−1 步):每一步,每张卡把自己"负责"的块发给右邻,并把收到的块累加到自己的对应块上。N−1 步后,每张卡手里恰好有一块是全局求和完整的(各卡负责的块不同)。
阶段② all-gather(N−1 步):把手里那块"已求和"的块沿环传 N−1 步,人人拿到全部 N 块的完整求和。完成。
关键性质一行算清:
每卡总收发量 = 2 × V × (N−1)/N ≈ 2V (V 为梯度总量)
与卡数 N 无关——8 卡和 1024 卡,每卡搬运的总量几乎一样,只随步数增加而拉长时间。这就是环形算法的价值:把同步成本从"扇出受限"变成"带宽受限",而带宽恰好是网络可以堆的东西。
2.1 分块数:一个真实存在的甜点
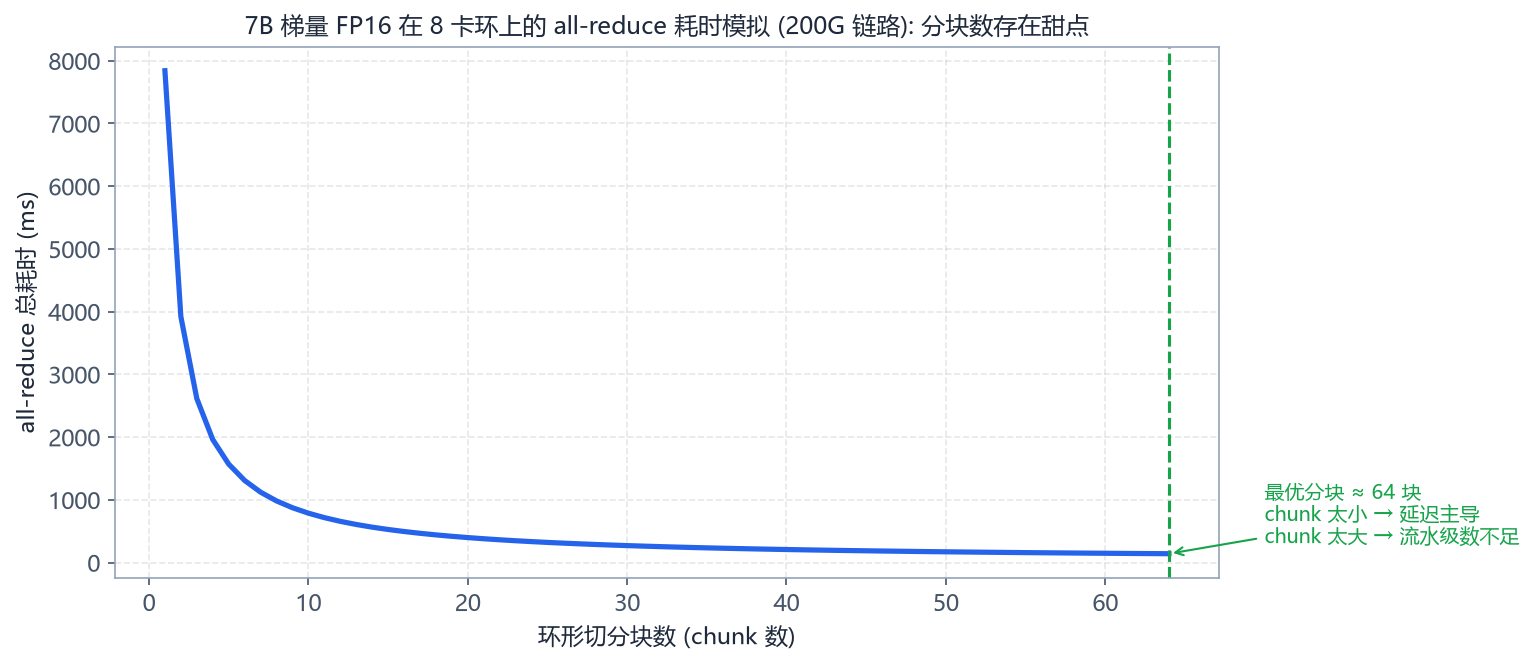
整块数据不能一次塞进网卡收发:切太少,每步消息太大,流水级数不足;切太碎,每步固定延迟(逐跳 latency)累积主导。上图是 7B 梯度、8 卡、200G 链路的模拟——分块数存在明显甜点,这正是 NCCL/HCCL 这类通信库内部要自动搜索的参数之一(chunk 大小、并行环数、协议切换 point-to-point / 简单算法的边界)。
2.2 NCCL / HCCL 做了什么
通信库的职责清单:探测拓扑(NVLink/HCCS 机内环 + 跨机环)→ 选择算法(ring / tree / 双环并行)→ 搜索分块与通道参数 → 暴露 all_reduce() 一个调用给框架。两套栈(NCCL 对 GPU、HCCL 对昇腾)在这层的算法与数学完全同源,差异在拓扑适配与调优经验——这呼应上一篇"CUDA→NPU 迁移清单"里的通信回归项。
3. 参数面网络:spine-leaf 的必然性
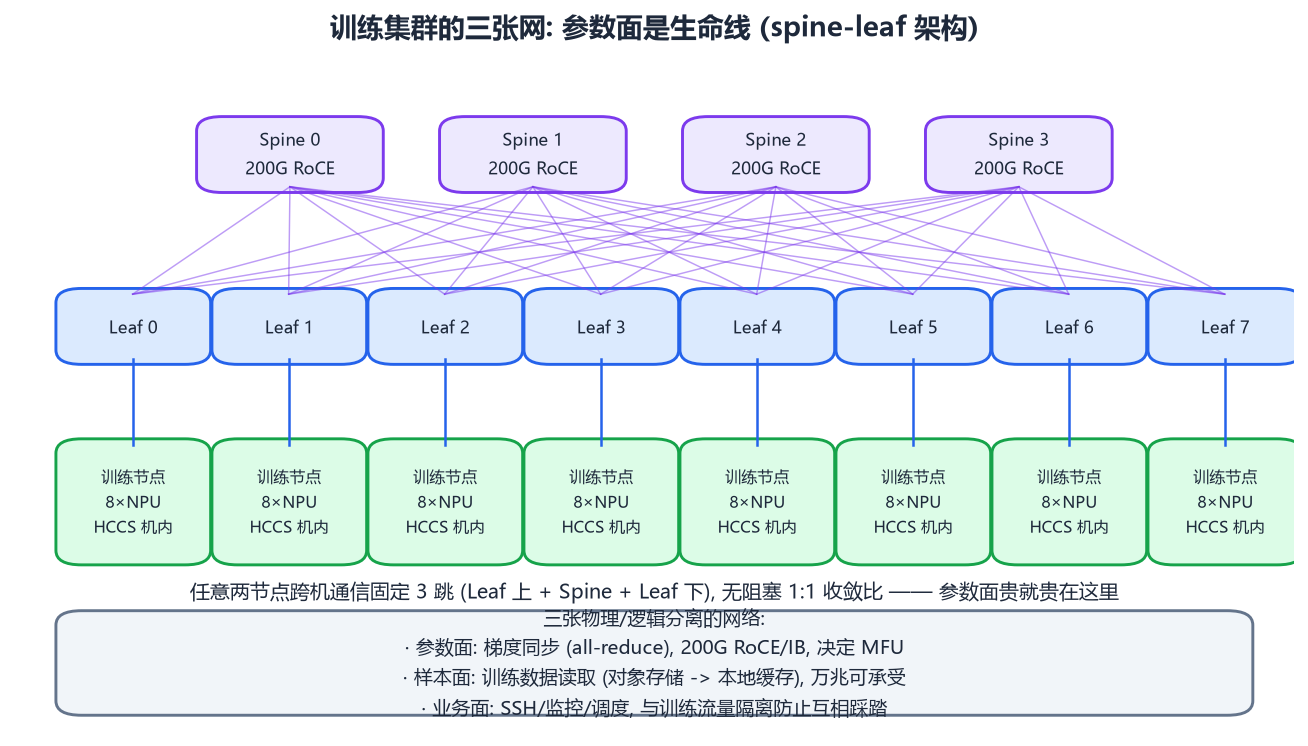
集群实际跑着三张逻辑网:
- 参数面:承载 all-reduce 梯度流量,200G RoCE(或 IB)每卡,1:1 无阻塞收敛比——贵,且必须 spine-leaf 两层架构保证任意两节点固定 3 跳、无超订;
- 样本面:训练数据从对象存储拉到本地缓存(数据管线),万兆/25G 可承受;
- 业务面:SSH、监控、调度指令,与训练流量隔离,防止一次大文件 scp 拖慢全局梯度同步。
RoCE(RDMA over Converged Ethernet)的意义:内核旁路 + 零拷贝,把 TCP 栈几十微秒的软件开销压到微秒级,同时绕过 CPU——千卡同步是每秒都在发生的事,这个开销乘以步数就是天文数字。与之配套的还有 PFC/ECN 流控(无损以太网)、以及交换机缓冲的水线配置——参数面的稳定性工程(不丢包)是训练稳定性的隐形地基,很多"莫名 loss spike"最后定位到网络层微突发丢包重传。
机内与跨机的分工(呼应硬件篇):机内 8 卡走 NVLink/HCCS 全互联(数百 GB/s),跨机走 200G RoCE(25GB/s)——相差一个数量级,这就是 TP 锁在机内、PP/DP 承担跨机的物理原因。
4. 三种并行的通信量账本
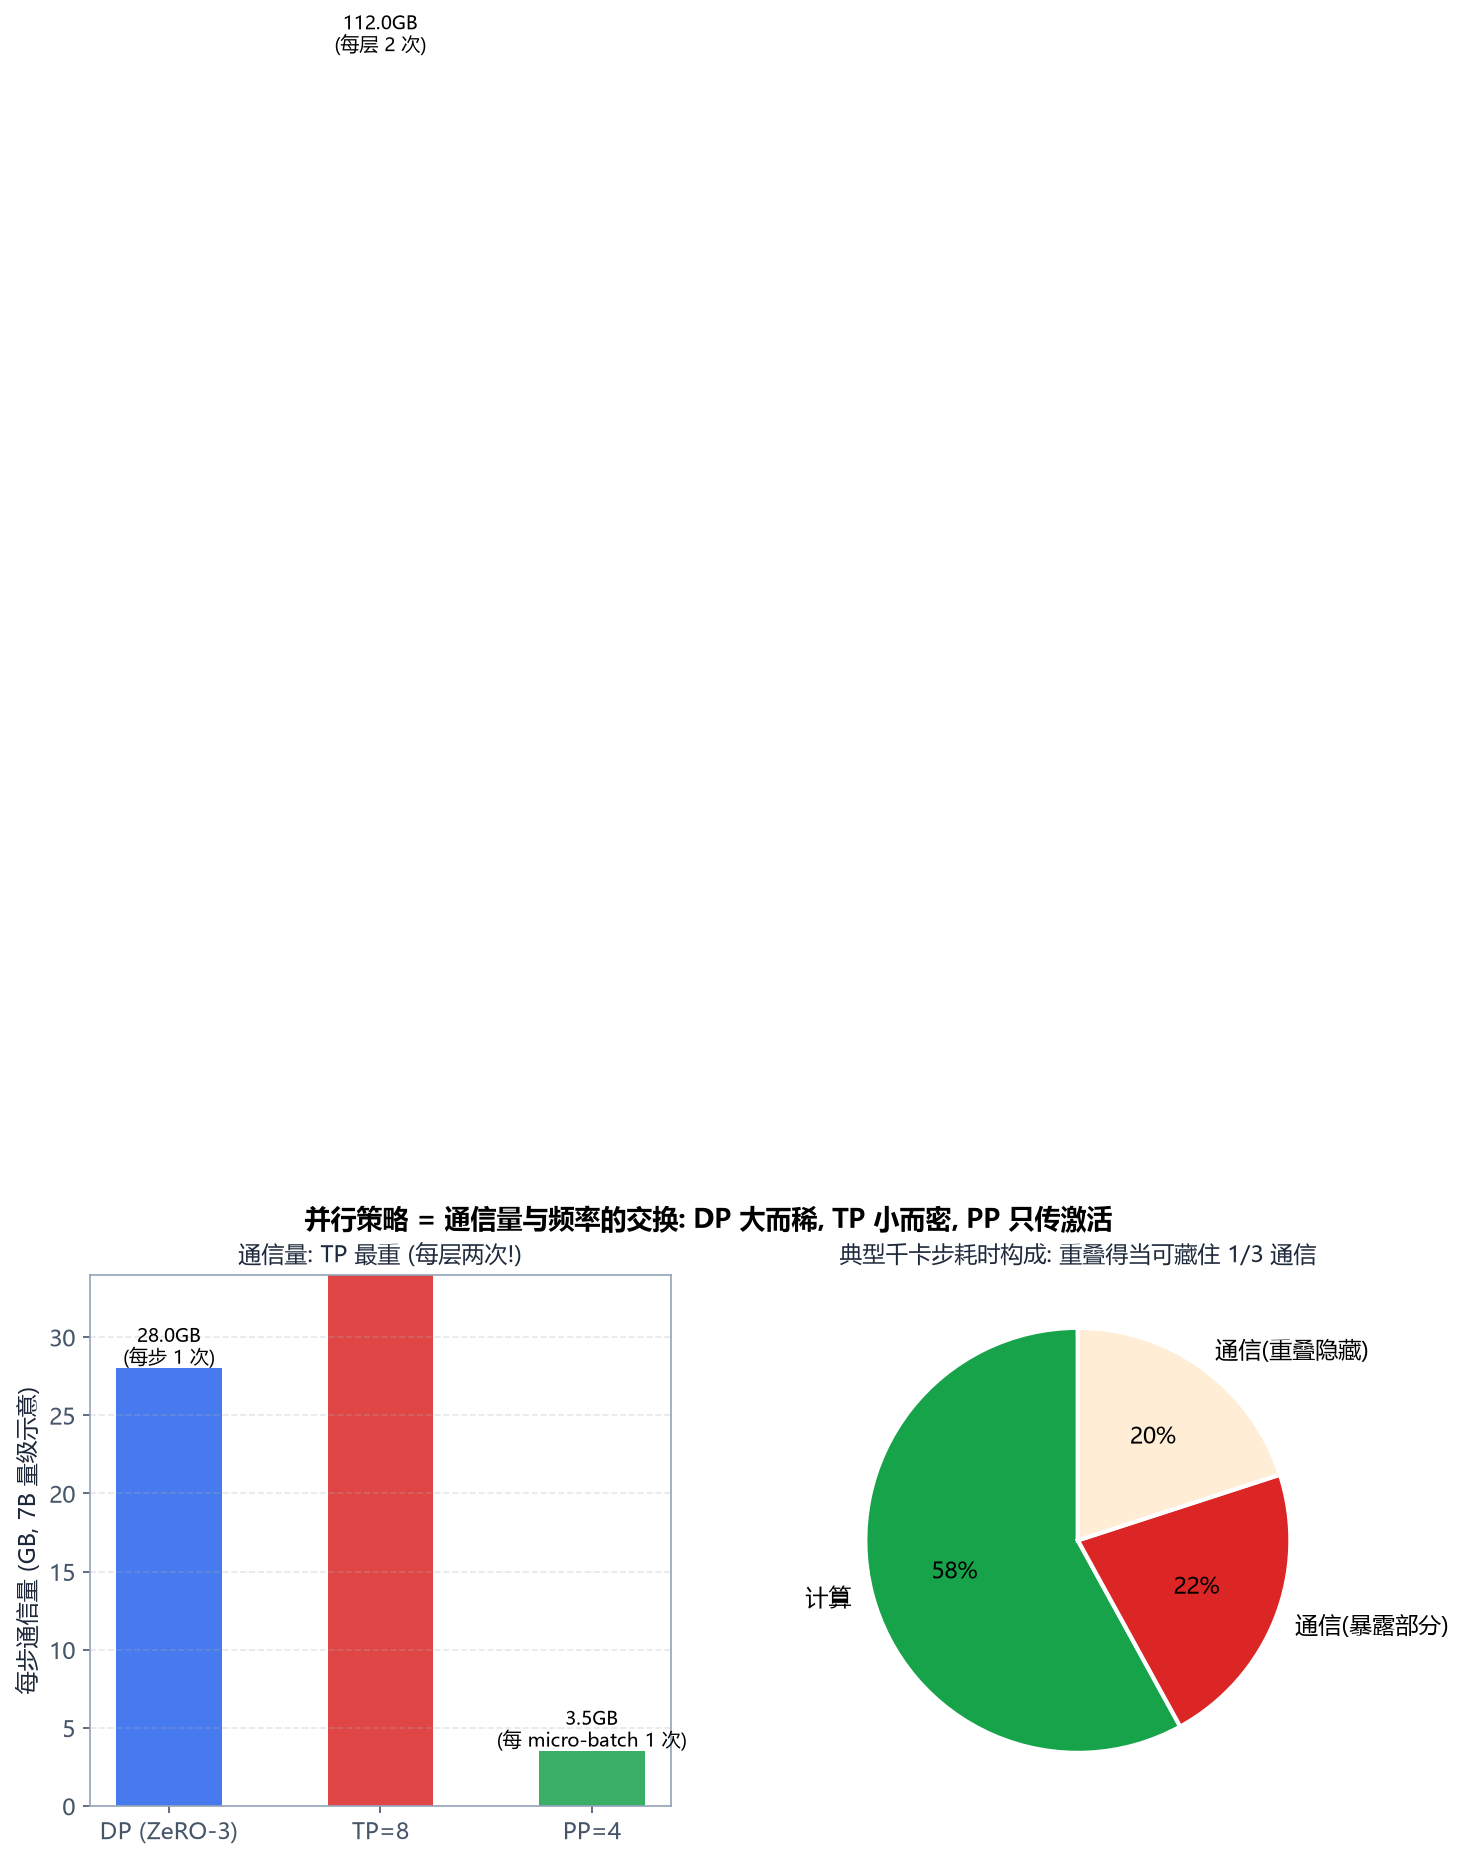
把训练篇的并行策略翻译成通信语言(7B 量级、每步):
| 并行 | 通信内容 | 频率 | 量级 | 承载网络 |
|---|---|---|---|---|
| DP(ZeRO-3) | 梯度/参数/优化器分片 all-reduce+all-gather | 每步 1 次 | ~2V(V=分片总量) | 跨机参数面 |
| TP=8 | 每层前向/反向各两次 all-reduce | 每层 2 次 | 单次小但极频繁 | 机内 NVLink/HCCS |
| PP=4 | 层间激活(micro-batch 传给下一段) | 每 micro-batch | 激活大小 | 机内或相邻机 |
结论三条:
- TP 通信最密,必须待在机内高速互联上(几百 GB/s 才喂得起每层两次的 all-reduce);
- DP/ZeRO 通信最大但稀(每步一次),跨机 200G 网络刚好对口;
- PP 最省(只传激活),但要吃流水线空泡((p−1)/(m+p−1))——所以超大模型跨机时 PP 是受欢迎的跨机组网维度。
重叠是第二半工程:通信与计算并行执行(反向传播到哪一层,哪一层的梯度就先发出去),典型系统可把 1/3 的通信时间藏进计算里。 MFU 的公式里因此有两项:MFU = 计算时间 / (计算时间 + 暴露的通信时间)——调优目标就是把"暴露"那部分压到最小。
5. 故障容忍:千卡集群的日常
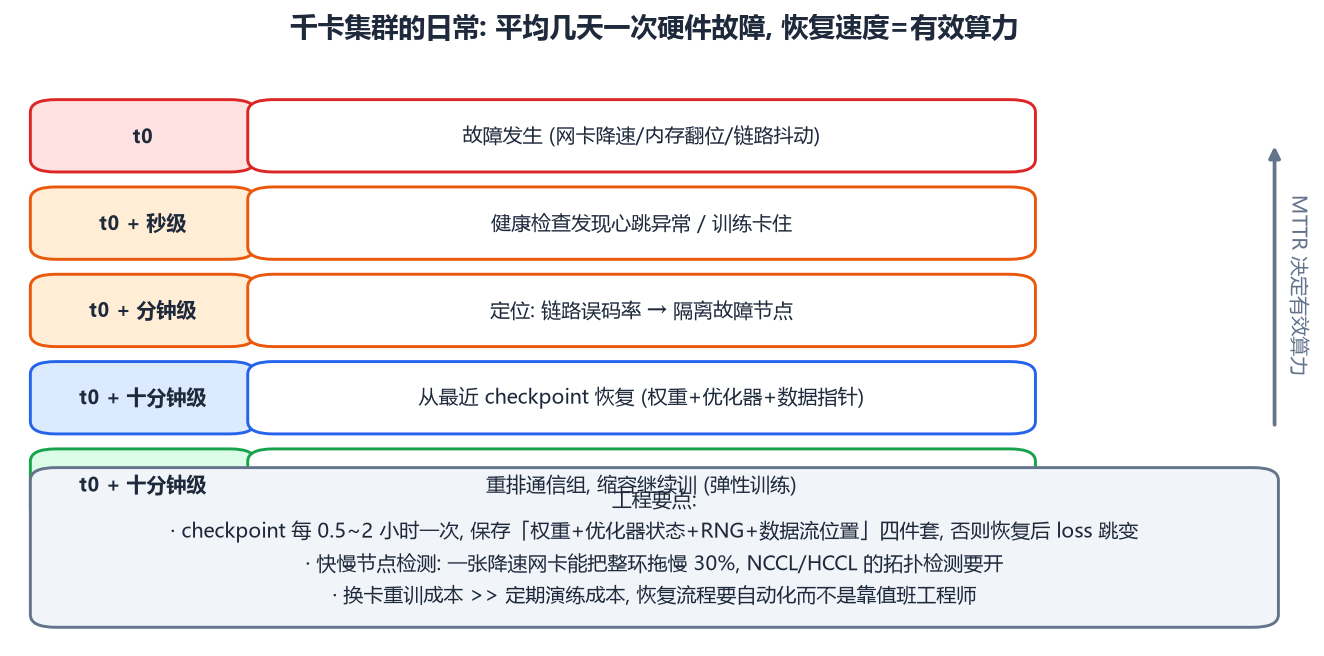
一个不太直觉的事实:千卡集群平均几天就会遇到一次硬件故障(内存翻位、网卡降速、光模块劣化、链路抖动)。故障不是异常,是常态——于是MTTR(平均恢复时间)直接等于有效算力:
- 检测:心跳 + 集合通信超时。一张"变慢但没死"的网卡最阴险——环上所有卡陪它降速,吞吐掉 30% 却不报警,需要 NCCL/HCCL 的健康检查与误码率监控来抓;
- 定位:链路层工具看 CRC 错误计数,快速隔离故障节点;
- 恢复:从最近 checkpoint 加载四件套——模型权重、优化器状态(Adam 动量!丢了它 loss 会跳变)、RNG 状态(保证数据流与 dropout 可续)、数据流位置。checkpoint 间隔(0.5~2 小时)是"恢复损失"与"写盘开销"的折中;
- 弹性:现代框架支持缩容/换卡续训(重排通信组),不必整集群重启。
把这条流水线自动化(而不是靠值班工程师手搓)是训练平台团队的核心产出之一。
6. 存储与数据面:别让 GPU 等饭
数据面虽然带宽要求低,但喂不上数据 = 全集群空转:
- 训练数据放对象存储(S3/OBS),计算节点本地 SSD 做 LRU 缓存——epoch 2 起命中率接近 100%;
- 数据集预打包成 tokenized 的二进制分片(如 webdataset 风格),避免训练时临时解压/分词——把数据管线的计算挪到训练之前;
- 混合精度训练时 DataLoader 的
pin_memory+ 预取流水(页锁定内存直达 DMA,呼应 CANN 篇的 Host 内存分配)。
7. 一张账本收尾
7B 模型、512 卡、A100/910B 级算力(量级推算):
每步计算量      ≈ 6 × 7e9 × 512 × 4096(token/step 全局 batch) ≈ 8.8e16 FLOP
每卡每步计算    8.8e16 / 512 = 1.7e14 → 400 TFLOPS 卡需 0.43s (100% 利用)
实际 MFU 45%    → 每步 ~0.95s
每步通信(暴露)  ~0.2s: ZeRO-3 梯度量 28GB/卡 ÷ 25GB/s ≈ 1.1s, 重叠藏掉 80%
账本能立刻暴露瓶颈在哪:是算力(MFU 低)、通信(暴露多)、还是数据供给(GPU 利用率间歇掉零)——先算账再调优,与推理篇的方法论一脉相承。
8. 小结
- all-reduce 环算法把每卡搬运量压到 ≈2V 与卡数无关,reduce-scatter + all-gather 两阶段 2(N−1) 步;
- 分块数有甜点,NCCL/HCCL 的核心工作是拓扑感知的算法与分块搜索;
- 参数面 spine-leaf 无阻塞 + RoCE 微秒级延迟 + 三网隔离,网络稳定性是训练稳定性的隐形地基;
- 通信量排序:TP 密而重(锁机内)、DP/ZeRO 大而稀(对口跨机)、PP 最省但有空泡;重叠隐藏决定 MFU;
- 千卡集群故障是常态,MTTR=有效算力:检测-定位-checkpoint 四件套-弹性恢复全链自动化。
硬件、单机软件栈、集群都有了,最后一块拼图是"运营"——下一篇:算力调度、NPU 切分与推理集群的 K8s 化部署。
第四部分 · 算力调度与推理集群:K8s、NPU 切分与弹性部署
前两篇解决了"单机软件栈"与"集群互联",但真实的数据中心还有一层运营问题:几十个团队、几百张卡、训练与推理混跑、白天与夜间负载差 10 倍——谁先用、用多少、出了问题谁管。这篇讲 AI 算力的"操作系统":K8s 如何接入 NPU(Device Plugin)、算力切分(vNPU 动态虚拟化)、训练作业的成组调度(Volcano)、推理服务的弹性伸缩,以及三层可观测体系。这是 AI Infra 系列的收官篇。
1. 为什么 AI 算力需要专门的调度层
裸机直用(SSH 上去跑脚本)在小规模下没问题,超过一个机柜就出现经典四问:
- 碎片化:8 卡机器被切给三个团队各 2~3 张,剩下的卡谁也用不了;
- 利用率:推理服务白天满载夜间闲置、训练任务排队等卡,两者互不知道;
- 隔离:一个实验把驱动搞挂,整节点所有任务陪葬;
- 审计:谁的作业占了多少卡小时、花了多少钱,没有账本。
答案与云计算十年前的答案相同:容器化 + 调度器。差异在于 AI 负载有三个特殊点:设备重(NPU/GPU 直通与拓扑)、成组性(训练作业要整组起)、冷启动重(加载模型权重以分钟计)。
2. K8s 接入 NPU:Device Plugin 机制
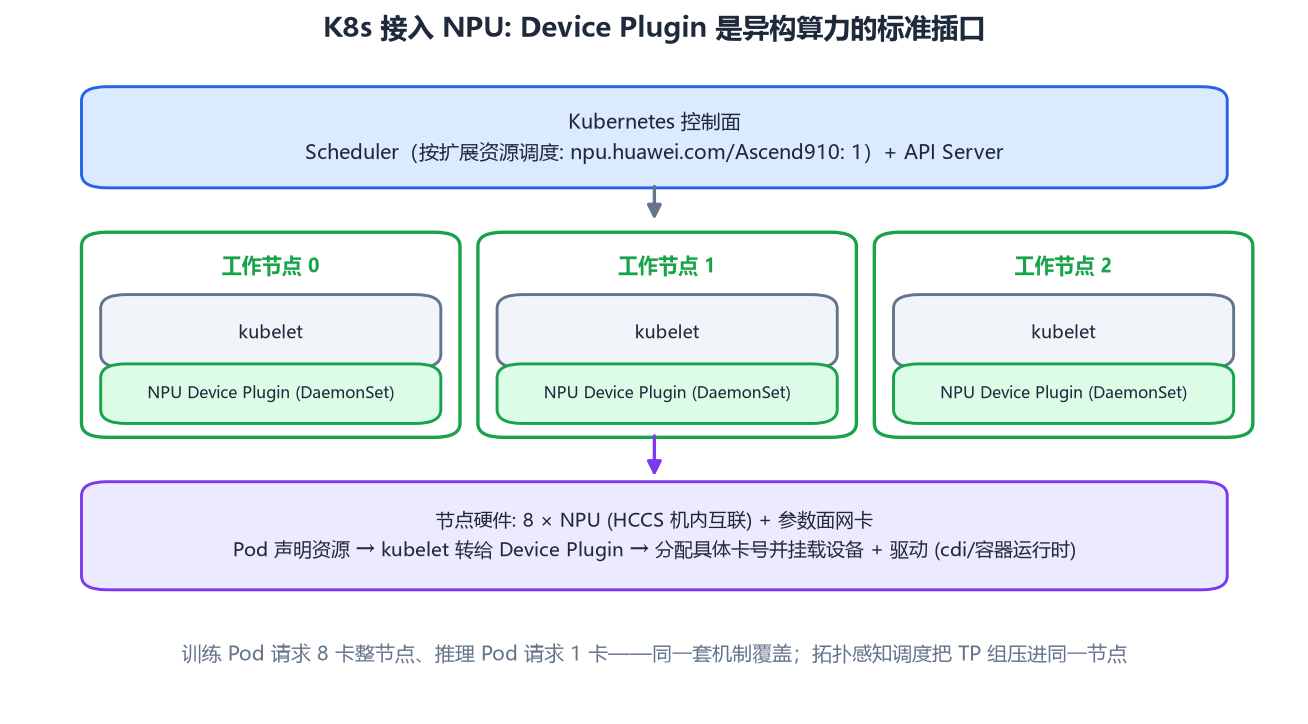
Kubernetes 本体只认识 CPU/内存,异构算力通过 Device Plugin 框架插入,机制四步:
- 插件以 DaemonSet 跑在每个节点上,向 kubelet 注册扩展资源(如
npu.huawei.com/Ascend910,容量 8); - Pod 的资源声明里写这个扩展资源("我要 8 张 NPU"),Scheduler 按总账调度到合适的节点;
- kubelet 请求插件分配具体设备——插件决定给你哪几张卡(这一步可以做拓扑对齐:让同一 TP 组的卡在同一 HCCS/NVLink 域内);
- 容器运行时把设备文件与驱动挂进容器(CDI 机制),Pod 内进程看到的就是
/dev/davinci0..7。
对用户的直接意义:Pod YAML 里一行 resources 声明,就把"哪台机器哪张卡"的问题交给调度器;而 NPU 厂商的 K8s 插件(昇腾的 volccano 生态组件、NVIDIA 的 k8s-device-plugin)本质都是在实现这套插口。训练 Pod 要整卡整节点,推理 Pod 可以只要 1 张卡或 1/4 张——同一套机制覆盖。
3. 算力切分:一张 NPU 当多张用
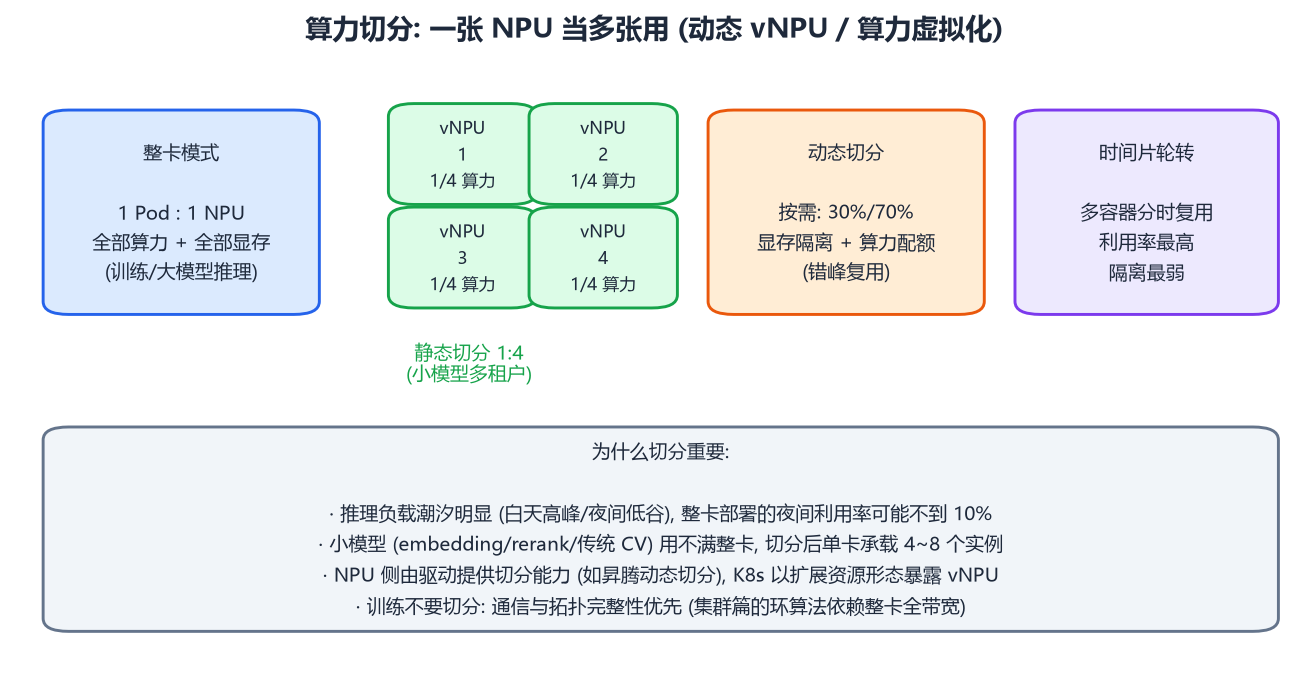
推理场景的矛盾:小模型(embedding、rerank、传统 CV)用不满一整张数百 TFLOPS 的卡,但租户又需要独占的显存与 QoS。三种切分粒度:
- 静态切分(1:2 / 1:4):驱动把一张物理卡注册成多个 vNPU,各自有独立的显存配额与算力份额,K8s 侧表现为更多的"卡"。隔离强、灵活性差;
- 动态切分:按比例(如 30%/70%)在线调整配额,配合潮汐负载错峰复用——白天推理多切给在线、夜间切给离线评估;
- 时间片轮转:多容器分时复用整卡。利用率最高、隔离最弱(一个邻居的尖峰延迟会传导给你),只适合不在乎尾延迟的批处理。
边界也很清楚:训练不要切分。切分破坏了卡间全带宽(集群篇的环算法依赖它),TP 组被切开等于自废武功。切分是推理与多租户场景的工具。
4. 训练作业调度:成组起、成组死
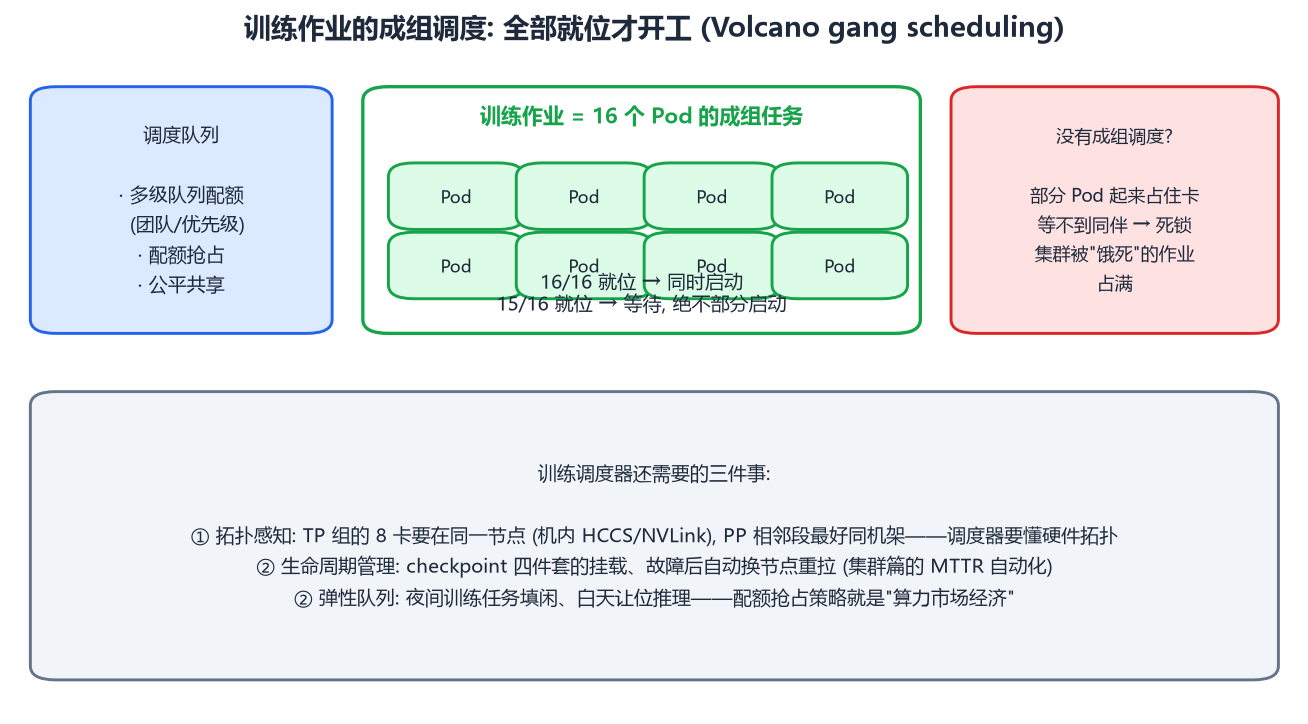
一个 16 节点的训练作业提交后,如果默认调度器"有多少资源起多少 Pod",会发生经典死锁:起了 15 个 Pod 各占一节点,第 16 个怎么也排不上(被别的作业占了),15 个 Pod 干占着卡等同伴,集群吞吐归零。
解法是成组调度(gang scheduling):作业的所有 Pod 作为一个整体,凑齐才启动、起不来就全不启动(排队等待)。Volcano(及 k8s 原生演进出的 coscheduling)在此之上补齐训练场景的另外三块:
- 多级队列与配额:按团队/优先级分配配额,支持抢占(高优作业可以"买断"低优作业的资源,低优作业回到队列);
- 拓扑感知调度:把 TP 组压进同一节点、PP 相邻段放进同机架——调度器必须"懂"上一章的网络拓扑,否则给你 8 张横跨三台机器的"TP 组",每层 all-reduce 都在跨机链路上爬;
- 作业生命周期:故障节点自动换机重拉(集群篇 MTTR 自动化的落地)、checkpoint 卷的挂载继承。
一句话:通用 K8s 把容器放到节点上,AI 调度器把"一个作业的拓扑"放到"一个集群的拓扑"上。
5. 推理集群:弹性与多模型共存
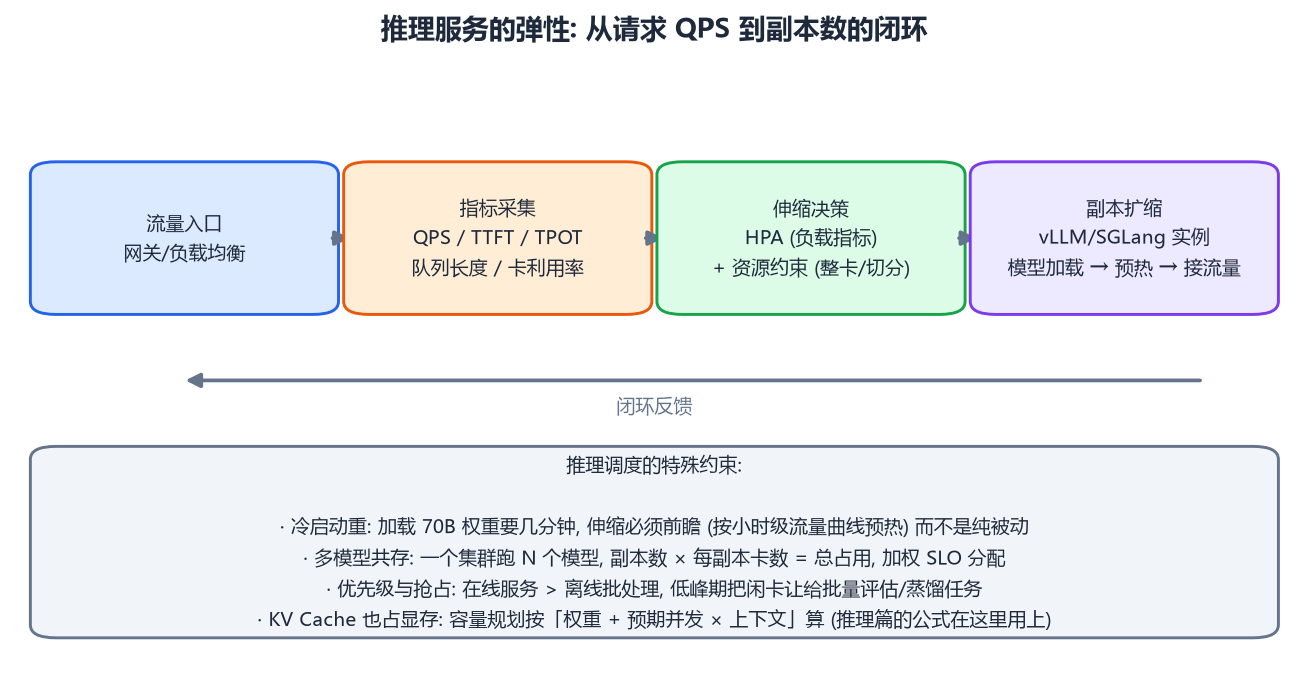
推理侧的调度目标是 SLO(TTFT/TPOT 分位值)下的成本最小化。标准闭环:流量入口 → 指标采集(QPS、队列深度、卡利用率)→ 伸缩决策(HPA 按自定义指标)→ 副本扩缩(新起 vLLM/SGLang 实例 → 加载权重 → 预热 → 接流量)。
AI 推理区别于普通微服务的三个现实:
- 冷启动以分钟计:加载 70B 权重 + 图编译(CANN 篇的预热)。伸缩必须前瞻——按小时级流量曲线提前扩,而不是等 P99 报警再扩;
- 容量 = 权重 + KV Cache:容量规划要用推理篇的公式(并发 × 上下文 × 每 token 缓存量),而不是"每实例 X QPS"这种拍脑袋数;
- 多模型加权:一个集群跑 N 个模型,副本数 × 每副本卡数的总盘子在 SLO 约束下分配;低峰期把闲卡让给离线批量(评估、蒸馏语料生成),白天抢占回来——配额与抢占策略就是集群内部的"算力市场"。
6. 可观测:三层指标各回答一个问题
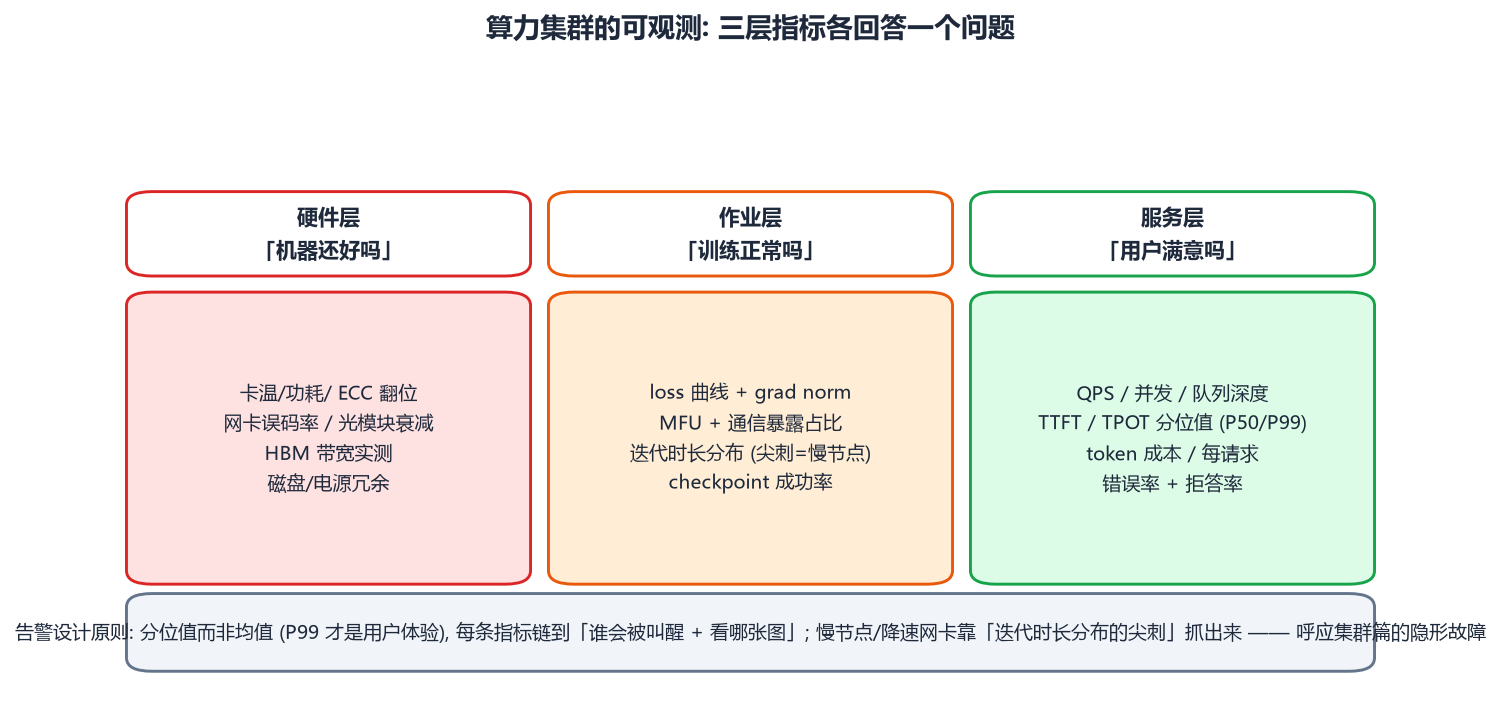
- 硬件层(机器还好吗):卡温/功耗/ECC 翻位计数、网卡误码率、光模块衰减、HBM 带宽实测——集群篇那些"隐形故障"(降速网卡)就靠这层数据 + 迭代时长分布的尖刺抓出来;
- 作业层(训练正常吗):loss 曲线与 grad norm(spike 预警)、MFU 与通信暴露占比、迭代时长分布、checkpoint 成功率;
- 服务层(用户满意吗):QPS、队列深度、TTFT/TPOT 的 P50/P99、每请求 token 成本、错误率与拒答率。
告警设计两条铁律:看分位不看均值(P99 才是用户体验,均值是自我安慰);每条告警都能回答"谁被叫醒、看哪张图、执行什么动作"——否则就是噪音制造机。
7. 一个最小参考架构
把四篇 Infra 拼成一个可落地的参考栈(自建或评估云上方案都适用):
【硬件】  8 卡 NPU 节点 (HCCS 机内) × N + spine-leaf 200G 参数面 + 对象存储
【系统】  K8s + NPU device plugin + Volcano (队列/成组/拓扑) + 监控栈
【训练】  PyTorch + torch_npu + HCCL + DeepSpeed/Megatron + 弹性恢复
【推理】  vLLM/SGLang 类引擎 + 图模式预热 + 前缀缓存 + 切分多租户
【运营】  配额账本 (卡小时/团队) + 三层可观测 + 前瞻伸缩
评估任何"智算平台"方案时,就按这五层对号入座:每层都有明确的技术点与替代品,缺哪层、哪层是自研哪层是开源,一目了然。
8. 小结
- Device Plugin 是异构算力进 K8s 的标准插口:扩展资源声明 → 插件分配具体卡 → 设备挂载进容器;
- 切分(静态 vNPU/动态配额/时间片)服务推理与多租户,训练坚持整卡整拓扑;
- 训练调度三件套:gang scheduling(凑齐才起)、队列配额与抢占、拓扑感知放置;
- 推理伸缩要前瞻(冷启动分钟级),容量规划 = 权重 + KV Cache,多模型在 SLO 下加权共存;
- 可观测分硬件/作业/服务三层,分位值优先,每条告警绑定责任人与动作。
至此 AI Infra 四部曲(硬件 → 软件栈 → 集群 → 调度运营)完结,加上前七篇的模型层(分词器 → 架构 → 训练 → 推理 → 量化 → RAG → Agent),这个系列从晶体管到应用层的完整地图就画完了。祝构建愉快。
全系列总览:硬件篇回答"算力从哪来",编程栈篇回答"怎么让专用芯片干活",集群篇回答"千卡怎么连成一台计算机",调度篇回答"算力怎么运营"——四篇合起来是智算中心的完整技术地图。延伸阅读:大语言模型全栈解析(跑在这些基础设施上的模型与推理引擎)。